Appearance
聊天客户端API
The ChatClient 提供了一个流畅的 API,用于与 AI 模型进行通信。 它同时支持同步和流式编程模型。
请参阅本文档底部的 Implementation Notes,其中涉及在 ChatClient 中结合使用命令式和响应式编程模型的相关说明。
流畅的 API 提供了用于构建作为输入传递给 AI 模型的 Prompt 的各个组成部分的方法。 Prompt 包含用于指导 AI 模型输出和行为的指令文本。从 API 的角度来看,提示由一系列消息组成。
AI 模型处理两种主要类型的消息:用户消息,即来自用户的直接输入;以及系统消息,由系统生成以引导对话。
这些消息通常包含占位符,这些占位符会在运行时根据用户输入进行替换,以自定义 AI 模型对用户输入的响应。
此外,还可以指定一些提示选项,例如要使用的 AI 模型名称以及控制生成输出随机性或创造性的温度设置。
创建聊天客户端
ChatClient 是使用 ChatClient.Builder 对象创建的。 您可以为任何 ChatModel Spring Boot 自动配置获取一个自动配置的 ChatClient.Builder 实例,或以编程方式创建一个。
使用自动配置的 ChatClient.Builder
在最简单的使用场景中,Spring AI 提供了 Spring Boot 自动配置,为您创建一个原型 ChatClient.Builder Bean,以便您将其注入到类中。 以下是一个简单的示例,用于检索对简单用户请求的 String 响应。
java
@RestController
class MyController {

    private final ChatClient chatClient;

    public MyController(ChatClient.Builder chatClientBuilder) {
        this.chatClient = chatClientBuilder.build();
    }

    @GetMapping("/ai")
    String generation(String userInput) {
        return this.chatClient.prompt()
            .user(userInput)
            .call()
            .content();
    }
}
在这个简单示例中,用户输入设置了用户消息的内容。 call() 方法向 AI 模型发送请求,而 content() 方法将 AI 模型的响应作为 String 返回。
使用多个聊天模型
在单个应用程序中,您可能需要使用多个聊天模型的几种场景包括:
- 使用不同的模型来处理不同类型的任务(例如,使用强大的模型进行复杂推理,而使用更快、更便宜的模型处理简单任务)。
- 在某个模型服务不可用时,实现回退机制
- A/B 测试不同的模型或配置
- 根据用户的偏好提供模型选择
- 结合专用模型(一个用于代码生成,另一个用于创意内容等)。
默认情况下,Spring AI 会自动配置一个 ChatClient.Builder bean。 然而,您可能需要在应用程序中使用多个聊天模型。 以下是处理这种情况的方法:
在所有情况下,您都需要通过设置属性 spring.ai.chat.client.enabled=false 来禁用 ChatClient.Builder 自动配置。
这允许您手动创建多个 ChatClient 实例。
多个聊天客户端使用单一模型类型
本节介绍一种常见用例:您需要创建多个 ChatClient 实例,这些实例均使用相同的底层模型类型,但配置各不相同。
java
// Create ChatClient instances programmatically
ChatModel myChatModel = ... // already autoconfigured by Spring Boot
ChatClient chatClient = ChatClient.create(myChatModel);

// Or use the builder for more control
ChatClient.Builder builder = ChatClient.builder(myChatModel);
ChatClient customChatClient = builder
    .defaultSystemPrompt("You are a helpful assistant.")
    .build();
不同模型类型的聊天客户端
在使用多个AI模型时,您可以为每个模型定义单独的 ChatClient bean:
java
import org.springframework.ai.chat.ChatClient;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class ChatClientConfig {

    @Bean
    public ChatClient openAiChatClient(OpenAiChatModel chatModel) {
        return ChatClient.create(chatModel);
    }

    @Bean
    public ChatClient anthropicChatClient(AnthropicChatModel chatModel) {
        return ChatClient.create(chatModel);
    }
}
您随后可以使用 @Qualifier 注解将这些 Bean 注入到您的应用程序组件中:
java
@Configuration
public class ChatClientExample {

    @Bean
    CommandLineRunner cli(
            @Qualifier("openAiChatClient") ChatClient openAiChatClient,
            @Qualifier("anthropicChatClient") ChatClient anthropicChatClient) {

        return args -> {
            var scanner = new Scanner(System.in);
            ChatClient chat;

            // Model selection
            System.out.println("\nSelect your AI model:");
            System.out.println("1. OpenAI");
            System.out.println("2. Anthropic");
            System.out.print("Enter your choice (1 or 2): ");

            String choice = scanner.nextLine().trim();

            if (choice.equals("1")) {
                chat = openAiChatClient;
                System.out.println("Using OpenAI model");
            } else {
                chat = anthropicChatClient;
                System.out.println("Using Anthropic model");
            }

            // Use the selected chat client
            System.out.print("\nEnter your question: ");
            String input = scanner.nextLine();
            String response = chat.prompt(input).call().content();
            System.out.println("ASSISTANT: " + response);

            scanner.close();
        };
    }
}
多个 OpenAI 兼容的 API 端点
The OpenAiApi and OpenAiChatModel classes provide a mutate() method that allows you to create variations of existing instances with different properties. This is particularly useful when you need to work with multiple OpenAI-compatible APIs.
java
@Service
public class MultiModelService {

    private static final Logger logger = LoggerFactory.getLogger(MultiModelService.class);

    @Autowired
    private OpenAiChatModel baseChatModel;

    @Autowired
    private OpenAiApi baseOpenAiApi;

    public void multiClientFlow() {
        try {
            // Derive a new OpenAiApi for Groq (Llama3)
            OpenAiApi groqApi = baseOpenAiApi.mutate()
                .baseUrl("https://api.groq.com/openai")
                .apiKey(System.getenv("GROQ_API_KEY"))
                .build();

            // Derive a new OpenAiApi for OpenAI GPT-4
            OpenAiApi gpt4Api = baseOpenAiApi.mutate()
                .baseUrl("https://api.openai.com")
                .apiKey(System.getenv("OPENAI_API_KEY"))
                .build();

            // Derive a new OpenAiChatModel for Groq
            OpenAiChatModel groqModel = baseChatModel.mutate()
                .openAiApi(groqApi)
                .defaultOptions(OpenAiChatOptions.builder().model("llama3-70b-8192").temperature(0.5).build())
                .build();

            // Derive a new OpenAiChatModel for GPT-4
            OpenAiChatModel gpt4Model = baseChatModel.mutate()
                .openAiApi(gpt4Api)
                .defaultOptions(OpenAiChatOptions.builder().model("gpt-4").temperature(0.7).build())
                .build();

            // Simple prompt for both models
            String prompt = "What is the capital of France?";

            String groqResponse = ChatClient.builder(groqModel).build().prompt(prompt).call().content();
            String gpt4Response = ChatClient.builder(gpt4Model).build().prompt(prompt).call().content();

            logger.info("Groq (Llama3) response: {}", groqResponse);
            logger.info("OpenAI GPT-4 response: {}", gpt4Response);
        }
        catch (Exception e) {
            logger.error("Error in multi-client flow", e);
        }
    }
}
聊天客户端流畅API
The ChatClient fluent API allows you to create a prompt in three distinct ways using an overloaded prompt method to initiate the fluent API:
prompt(): 此无参方法可让您开始使用流畅式 API,从而构建提示中的用户、系统及其他部分。prompt(Prompt prompt): 此方法接受一个Prompt参数,允许您传入使用 Prompt 的非流畅 API 创建的Prompt实例。prompt(String content): 这是一个类似于上一个重载的便捷方法。它接受用户的文本内容。
聊天客户端响应
The ChatClient API offers several ways to format the response from the AI Model using the fluent API.
返回 ChatResponse
AI 模型的响应是一个由类型 ChatResponse 定义的丰富结构。 它包含有关如何生成该响应的元数据,并且还可以包含多个响应,称为 生成 ,每个生成都有其自身的元数据。 元数据包括用于创建响应的标记数量(每个标记大约相当于 3/4 个单词)。 这些信息很重要,因为托管的 AI 模型会根据每次请求使用的标记数量收费。
以下示例展示了在调用 call() 方法后,通过调用 chatResponse() 返回包含元数据的 ChatResponse 对象。
java
ChatResponse chatResponse = chatClient.prompt()
    .user("Tell me a joke")
    .call()
    .chatResponse();
返回实体
您通常希望返回一个从返回的 String 映射而来的实体类。 entity() 方法提供了此功能。
例如,给定以下 Java 记录:
java
record ActorFilms(String actor, List<String> movies) {}您可以使用 entity() 方法轻松将 AI 模型的输出映射到此记录,如下所示:
java
ActorFilms actorFilms = chatClient.prompt()
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorFilms.class);
还有一个重载的 entity 方法,其签名是 entity(ParameterizedTypeReference<T> type),允许您指定诸如泛型 List 之类的类型:
java
List<ActorFilms> actorFilms = chatClient.prompt()
    .user("Generate the filmography of 5 movies for Tom Hanks and Bill Murray.")
    .call()
    .entity(new ParameterizedTypeReference<List<ActorFilms>>() {});
原生结构化输出
随着越来越多的AI模型原生支持结构化输出,您可以通过在调用 ChatClient 时使用 AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT 顾问参数来利用这一特性。 您可以使用 ChatClient.Builder 上的 defaultAdvisors() 方法,为所有调用全局设置此参数,或按如下所示为每次调用单独设置:
java
ActorFilms actorFilms = chatClient.prompt()
    .advisors(AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT)
    .user("Generate the filmography for a random actor.")
    .call()
.entity(ActorFilms.class);| 一些 AI 模型,例如 OpenAI,并不原生支持对象数组。 在这种情况下,您可以使用 Spring AI 的默认结构化输出转换。 |
|---|
流式响应
The stream() method lets you get an asynchronous response as shown below:
java
Flux<String> output = chatClient.prompt()
    .user("Tell me a joke")
    .stream()
    .content();
您也可以使用方法 Flux<ChatResponse> chatResponse() 来流式传输 ChatResponse 。
在未来,我们将提供一个便捷方法,使您能够使用响应式 stream() 方法返回 Java 实体。 与此同时,您应使用 结构化输出转换器 明确地将聚合响应进行转换,如下所示。 这也展示了流畅 API 中参数的使用,相关内容将在文档的后续部分中更详细地讨论。
java
var converter = new BeanOutputConverter<>(new ParameterizedTypeReference<List<ActorsFilms>>() {});

Flux<String> flux = this.chatClient.prompt()
    .user(u -> u.text("""
                        Generate the filmography for a random actor.
                        {format}
                      """)
            .param("format", this.converter.getFormat()))
    .stream()
    .content();

String content = this.flux.collectList().block().stream().collect(Collectors.joining());

List<ActorsFilms> actorFilms = this.converter.convert(this.content);
提示模板
The ChatClient fluent API lets you provide user and system text as templates with variables that are replaced at runtime.
java
String answer = ChatClient.create(chatModel).prompt()
    .user(u -> u
            .text("Tell me the names of 5 movies whose soundtrack was composed by {composer}")
            .param("composer", "John Williams"))
    .call()
    .content();
在内部,ChatClient 使用 PromptTemplate 类来处理用户和系统文本,并根据给定的 TemplateRenderer 实现,在运行时将变量替换为提供的值。 默认情况下,Spring AI 使用 StTemplateRenderer 实现,该实现基于 Terence Parr 开发的开源 StringTemplate 引擎。
Spring AI 也为不需要模板处理的情况提供了 NoOpTemplateRenderer 。
直接在 ChatClient 上配置的 TemplateRenderer (通过.templateRenderer() )仅适用于在 ChatClient 构建器链中直接定义的提示内容(例如,通过.user() 、.system())。 它 不会 影响 Advisors 内部使用的模板,如 QuestionAnswerAdvisor,这些模板拥有自己的模板自定义机制(参见 自定义顾问模板)。 |
|---|
如果您更倾向于使用其他模板引擎,可以直接向 ChatClient 提供 TemplateRenderer 接口的自定义实现。您也可以继续使用默认的 StTemplateRenderer,但需进行自定义配置。
例如,默认情况下,模板变量通过 {} 语法进行标识。 如果您计划在提示中包含JSON,可能需要使用不同的语法以避免与JSON语法冲突。例如,您可以使用 < 和 > 作为分隔符。
java
String answer = ChatClient.create(chatModel).prompt()
    .user(u -> u
            .text("Tell me the names of 5 movies whose soundtrack was composed by <composer>")
            .param("composer", "John Williams"))
    .templateRenderer(StTemplateRenderer.builder().startDelimiterToken('<').endDelimiterToken('>').build())
    .call()
    .content();
调用() 返回值
在 ChatClient 上指定 call() 方法后,响应类型有几种不同的选择。
String content(): 返回响应的字符串内容ChatResponse chatResponse(): 返回包含多代以及关于响应的元数据的ChatResponse对象,例如用于创建响应的标记数量。ChatClientResponse chatClientResponse(): 返回一个包含ChatClientResponse对象的ChatResponse对象,该对象包含 ChatClient 执行上下文,使您能够访问在顾问执行期间使用的附加数据(例如,在 RAG 流程中检索的相关文档)。entity()以返回 Java 类型entity(ParameterizedTypeReference<T> type): 用于返回实体类型的Collection。entity(Class<T> type): 用于返回特定的实体类型。entity(StructuredOutputConverter<T> structuredOutputConverter): 用于指定一个StructuredOutputConverter的实例,以将String转换为实体类型。
responseEntity()以返回ChatResponse和 Java 类型。这在您需要同时访问完整的 AI 模型响应(包含元数据和生成内容)以及结构化输出实体时非常有用。responseEntity(Class<T> type): 用于返回一个包含完整ChatResponse对象和特定实体类型的ResponseEntity。responseEntity(ParameterizedTypeReference<T> type): 用于返回一个包含完整ChatResponse对象和实体类型Collection的ResponseEntity。responseEntity(StructuredOutputConverter<T> structuredOutputConverter): 用于返回一个包含完整ChatResponse对象以及使用指定StructuredOutputConverter转换的实体的ResponseEntity。
您也可以调用 stream() 方法,而不是 call() 。
调用 call() 方法并不会真正触发 AI 模型的执行。相反,它仅指示 Spring AI 是使用同步调用还是流式调用。 实际的 AI 模型调用发生在调用诸如 content() 、 chatResponse() 和 responseEntity() 等方法时。 |
|---|
流() 返回值
在 ChatClient 上指定 stream() 方法后,响应类型有几种选择:
Flux<String> content(): 返回由AI模型生成的字符串的Flux。Flux<ChatResponse> chatResponse(): 返回Flux的ChatResponse对象,其中包含有关响应的附加元数据。Flux<ChatClientResponse> chatClientResponse(): 返回包含ChatResponse对象和 ChatClient 执行上下文的ChatClientResponse对象中的Flux,使您能够访问在顾问执行期间使用的附加数据(例如,在 RAG 流程中检索的相关文档)。
消息元数据
ChatClient 支持为用户消息和系统消息添加元数据。 元数据提供了关于消息的额外上下文和信息,可供 AI 模型或下游处理使用。
为用户消息添加元数据
您可以使用 metadata() 方法向用户消息添加元数据:
java
// Adding individual metadata key-value pairs
String response = chatClient.prompt()
    .user(u -> u.text("What's the weather like?")
        .metadata("messageId", "msg-123")
        .metadata("userId", "user-456")
        .metadata("priority", "high"))
    .call()
    .content();

// Adding multiple metadata entries at once
Map<String, Object> userMetadata = Map.of(
    "messageId", "msg-123",
    "userId", "user-456",
    "timestamp", System.currentTimeMillis()
);

String response = chatClient.prompt()
    .user(u -> u.text("What's the weather like?")
        .metadata(userMetadata))
    .call()
    .content();
为系统消息添加元数据
同样,您也可以为系统消息添加元数据:
java
// Adding metadata to system messages
String response = chatClient.prompt()
    .system(s -> s.text("You are a helpful assistant.")
        .metadata("version", "1.0")
        .metadata("model", "gpt-4"))
    .user("Tell me a joke")
    .call()
    .content();
默认元数据支持
您还可以在 ChatClient 构建器级别配置默认元数据:
java
@Configuration
class Config {
    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder
            .defaultSystem(s -> s.text("You are a helpful assistant")
                .metadata("assistantType", "general")
                .metadata("version", "1.0"))
            .defaultUser(u -> u.text("Default user context")
                .metadata("sessionId", "default-session"))
            .build();
    }
}
元数据验证
ChatClient 会验证元数据以确保数据完整性:
- 元数据键不能为 null 或空
- 元数据值不能为 null
- 在传递 Map 时,键和值都不能包含空元素。
java
// This will throw an IllegalArgumentException
chatClient.prompt()
    .user(u -> u.text("Hello")
        .metadata(null, "value"))  // Invalid: null key
    .call()
    .content();

// This will also throw an IllegalArgumentException
chatClient.prompt()
    .user(u -> u.text("Hello")
        .metadata("key", null))    // Invalid: null value
    .call()
    .content();
访问元数据
元数据包含在生成的 UserMessage 和 SystemMessage 对象中,可以通过消息的 getMetadata() 方法访问。 这在处理顾问中的消息或检查对话历史时尤其有用。
使用默认值
在 @Configuration 类中创建一个带有默认系统文本的 ChatClient ,可以简化运行时代码。 通过设置默认值,您只需在调用 ChatClient 时指定用户文本,从而无需在运行时代码路径中为每次请求都设置系统文本。
默认系统文本
在下面的示例中,我们将配置系统文本始终以海盗的口吻进行回复。 为避免在运行时代码中重复系统文本,我们将在 @Configuration 类中创建一个 ChatClient 实例。
java
@Configuration
class Config {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a friendly chat bot that answers question in the voice of a Pirate")
                .build();
    }

}
以及一个 @RestController 来调用它:
java
@RestController
class AIController {

    private final ChatClient chatClient;

    AIController(ChatClient chatClient) {
        this.chatClient = chatClient;
    }

    @GetMapping("/ai/simple")
    public Map<String, String> completion(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message) {
        return Map.of("completion", this.chatClient.prompt().user(message).call().content());
    }
}
通过 curl 调用应用程序端点时,结果为:
bash
❯ curl localhost:8080/ai/simple
{"completion":"Why did the pirate go to the comedy club? To hear some arrr-rated jokes! Arrr, matey!"}
默认系统文本,带参数
在下面的示例中,我们将使用系统文本中的占位符来指定完成时的语音,而不是在设计时指定。
java
@Configuration
class Config {

    @Bean
    ChatClient chatClient(ChatClient.Builder builder) {
        return builder.defaultSystem("You are a friendly chat bot that answers question in the voice of a {voice}")
                .build();
    }

}
java
@RestController
class AIController {
    private final ChatClient chatClient;

    AIController(ChatClient chatClient) {
        this.chatClient = chatClient;
    }

    @GetMapping("/ai")
    Map<String, String> completion(@RequestParam(value = "message", defaultValue = "Tell me a joke") String message, String voice) {
        return Map.of("completion",
                this.chatClient.prompt()
                        .system(sp -> sp.param("voice", voice))
                        .user(message)
                        .call()
                        .content());
    }

}
通过 httpie 调用应用程序端点时,结果为:
bash
http localhost:8080/ai voice=='Robert DeNiro'
{
    "completion": "You talkin' to me? Okay, here's a joke for ya: Why couldn't the bicycle stand up by itself? Because it was two tired! Classic, right?"
}
其他默认值
在 ChatClient.Builder 级别,您可以指定默认的提示配置。
defaultOptions(ChatOptions chatOptions): 传入在ChatOptions类中定义的可移植选项,或模型特定的选项,例如OpenAiChatOptions中的选项。 有关模型特定ChatOptions实现的更多信息,请参阅 JavaDocs。defaultFunction(String name, String description, java.util.function.Function<I, O> function):name用于引用用户文本中的函数。description解释了函数的作用,并帮助 AI 模型选择正确的函数以获得准确的响应。function参数是 Java 函数实例,模型将在必要时执行该实例。defaultFunctions(String… functionNames): 应用上下文中定义的 `java.util.Function` 的 Bean 名称。defaultUser(String text),defaultUser(Resource text),defaultUser(Consumer<UserSpec> userSpecConsumer): 这些方法允许您定义用户文本。Consumer<UserSpec>允许您使用 lambda 来指定用户文本以及任何默认参数。defaultAdvisors(Advisor… advisor): 顾问允许修改用于创建Prompt的数据。QuestionAnswerAdvisor实现通过将提示与用户文本相关的上下文信息附加在一起,从而启用Retrieval Augmented Generation模式。defaultAdvisors(Consumer<AdvisorSpec> advisorSpecConsumer): 此方法允许您定义一个Consumer以使用AdvisorSpec配置多个顾问。顾问可以修改用于创建最终Prompt的数据。Consumer<AdvisorSpec>允许您指定一个 lambda 来添加顾问,例如QuestionAnswerAdvisor,它通过根据用户文本附加相关上下文信息来支持Retrieval Augmented Generation。
您可以在运行时使用相应的方法覆盖这些默认值,而无需使用 default 前缀。
options(ChatOptions chatOptions)function(String name, String description, java.util.function.Function<I, O> function)functions(String… functionNames)user(String text),user(Resource text),user(Consumer<UserSpec> userSpecConsumer)advisors(Advisor… advisor)advisors(Consumer<AdvisorSpec> advisorSpecConsumer)
通知器
The Advisors API provides a flexible and powerful way to intercept, modify, and enhance AI-driven interactions in your Spring applications.
在使用用户文本调用 AI 模型时,一种常见的模式是将上下文数据附加或增强到提示中。
这些上下文数据可以是不同类型。常见的类型包括:
- 您自己的数据 :这是AI模型未被训练过的数据。 即使模型见过类似的数据,附加的上下文数据在生成响应时仍具有优先权。
- 对话历史 :聊天模型的API是无状态的。 如果您告诉AI模型您的名字,它在后续的交互中不会记住这个名字。 每次请求时都必须发送对话历史,以确保在生成响应时考虑之前的交互。
聊天客户端中的顾问配置
ChatClient流畅API提供了一个 AdvisorSpec 接口用于配置顾问。 该接口提供了添加参数、一次性设置多个参数以及向链中添加一个或多个顾问的方法。
java
interface AdvisorSpec {
    AdvisorSpec param(String k, Object v);
    AdvisorSpec params(Map<String, Object> p);
    AdvisorSpec advisors(Advisor... advisors);
    AdvisorSpec advisors(List<Advisor> advisors);
}| 将顾问添加到链中的顺序至关重要,因为它决定了它们的执行顺序。 每个顾问都会以某种方式修改提示或上下文,而前一个顾问所做的更改会传递给链中的下一个顾问。 |
|---|
java
ChatClient.builder(chatModel)
    .build()
    .prompt()
    .advisors(
        MessageChatMemoryAdvisor.builder(chatMemory).build(),
        QuestionAnswerAdvisor.builder(vectorStore).build()
    )
    .user(userText)
    .call()
    .content();
在此配置中, MessageChatMemoryAdvisor 将首先执行,将对话历史添加到提示中。 然后, QuestionAnswerAdvisor 将根据用户的提问和已添加的对话历史进行搜索,从而可能提供更相关的结果。
增强检索生成
请参考 检索增强生成 指南。
日志
SimpleLoggerAdvisor 是一个记录 request 和 response 的 ChatClient 数据的顾问。 这对于调试和监控您的AI交互非常有用。
| Spring AI 支持对 LLM 和向量存储交互的可观测性。 请参考 可观测性 指南以获取更多信息。 |
|---|
要启用日志记录,请在创建 ChatClient 时将 SimpleLoggerAdvisor 添加到 advisor 链中。 建议将其添加到链的末尾:
java
ChatResponse response = ChatClient.create(chatModel).prompt()
        .advisors(new SimpleLoggerAdvisor())
        .user("Tell me a joke?")
        .call()
        .chatResponse();
要查看日志,请将 advisor 包的日志级别设置为 DEBUG :
logging.level.org.springframework.ai.chat.client.advisor=DEBUG将此添加到您的 application.properties 或 application.yaml 文件中。
您可以使用以下构造函数来自定义从 AdvisedRequest 和 ChatResponse 记录哪些数据:
java
SimpleLoggerAdvisor(
    Function<ChatClientRequest, String> requestToString,
    Function<ChatResponse, String> responseToString,
    int order
)
示例用法:
java
SimpleLoggerAdvisor customLogger = new SimpleLoggerAdvisor(
    request -> "Custom request: " + request.prompt().getUserMessage(),
    response -> "Custom response: " + response.getResult(),
    0
);
这使您能够根据自己的特定需求定制记录的信息。
| 在生产环境中记录敏感信息时需谨慎。 |
|---|
聊天记忆
接口 ChatMemory 表示用于存储聊天对话记忆的存储库。 它提供了向对话中添加消息、从对话中检索消息以及清除对话历史记录的方法。
目前有一个内置实现: MessageWindowChatMemory 。
MessageWindowChatMemory 是一种聊天记忆实现,它会维护一个消息窗口,最多保留指定的最大数量的消息(默认:20 条消息)。 当消息数量超过此限制时,较早的消息将被移除,但系统消息会被保留。 如果添加了新的系统消息,所有之前存在的系统消息都将从内存中删除。 这确保了对话始终可以获取最新的上下文,同时使内存使用量保持在有限范围内。
MessageWindowChatMemory 由 ChatMemoryRepository 抽象提供支持,该抽象为聊天对话内存提供了存储实现。 有多种实现可用,包括 InMemoryChatMemoryRepository 、 JdbcChatMemoryRepository 、 CassandraChatMemoryRepository 和 Neo4jChatMemoryRepository 。
有关更多详细信息和使用示例,请参阅 聊天内存 文档。
实现说明
在 ChatClient 中,命令式和响应式编程模型的结合使用是该 API 的一个独特方面。 通常,一个应用程序要么是响应式的,要么是命令式的,而不会同时兼具两者。
- 在自定义模型实现的HTTP客户端交互时,必须同时配置RestClient和WebClient。
由于 Spring Boot 3.4 中存在一个 bug,必须设置 "spring.http.client.factory=jdk" 属性。 否则,默认值为 "reactor",这会导致某些 AI 工作流(如 ImageModel)无法正常工作。
- 流式传输仅通过响应式堆栈支持。 因此,命令式应用程序必须包含响应式堆栈(例如 spring-boot-starter-webflux)。
- 非流式处理仅通过 Servlet 栈支持。 由于此原因,响应式应用程序必须包含 Servlet 栈(例如 spring-boot-starter-web),并预期某些调用是阻塞的。
- 工具调用是强制性的,会导致工作流阻塞。 这还会导致 Micrometer 监测出现部分/中断的情况(例如,ChatClient 的跨度和工具调用的跨度没有连接,因此前者会一直处于未完成状态)。
- 内置的顾问器对标准调用执行阻塞操作,对流式调用执行非阻塞操作。 用于顾问器流式调用的 Reactor Scheduler 可以通过每个 Advisor 类上的 Builder 进行配置。
顾问API
Spring AI顾问API提供了一种灵活且强大的方式,用于在Spring应用程序中拦截、修改和增强AI驱动的交互。 通过使用顾问API,开发人员可以创建更复杂、可复用和维护的AI组件。
核心优势包括封装重复的生成式AI模式,将数据转换为从和发送到大型语言模型(LLMs),以及提供在各种模型和使用场景中的可访问性。
您可以使用 ChatClient API 配置现有的顾问,如下例所示:
java
ChatMemory chatMemory = ... // Initialize your chat memory store
VectorStore vectorStore = ... // Initialize your vector store

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(
        MessageChatMemoryAdvisor.builder(chatMemory).build(), // chat-memory advisor
        QuestionAnswerAdvisor.builder(vectorStore).build()    // RAG advisor
    )
    .build();

var conversationId = "678";

String response = this.chatClient.prompt()
    // Set advisor parameters at runtime
    .advisors(advisor -> advisor.param(ChatMemory.CONVERSATION_ID, conversationId))
    .user(userText)
    .call()
    .content();
建议在构建时使用构建器的 defaultAdvisors() 方法注册通知器。
通知器(Advisors)也会参与可观测性栈,因此您可以查看与其执行相关的指标和追踪信息。
核心组件
该API包含用于非流式场景的 CallAdvisor 和 CallAdvisorChain ,以及用于流式场景的 StreamAdvisor 和 StreamAdvisorChain 。 它还包括用于表示未密封的Prompt请求的 ChatClientRequest ,以及用于聊天补全响应的 ChatClientResponse 。两者都持有一个 advise-context 以在顾问链中共享状态。
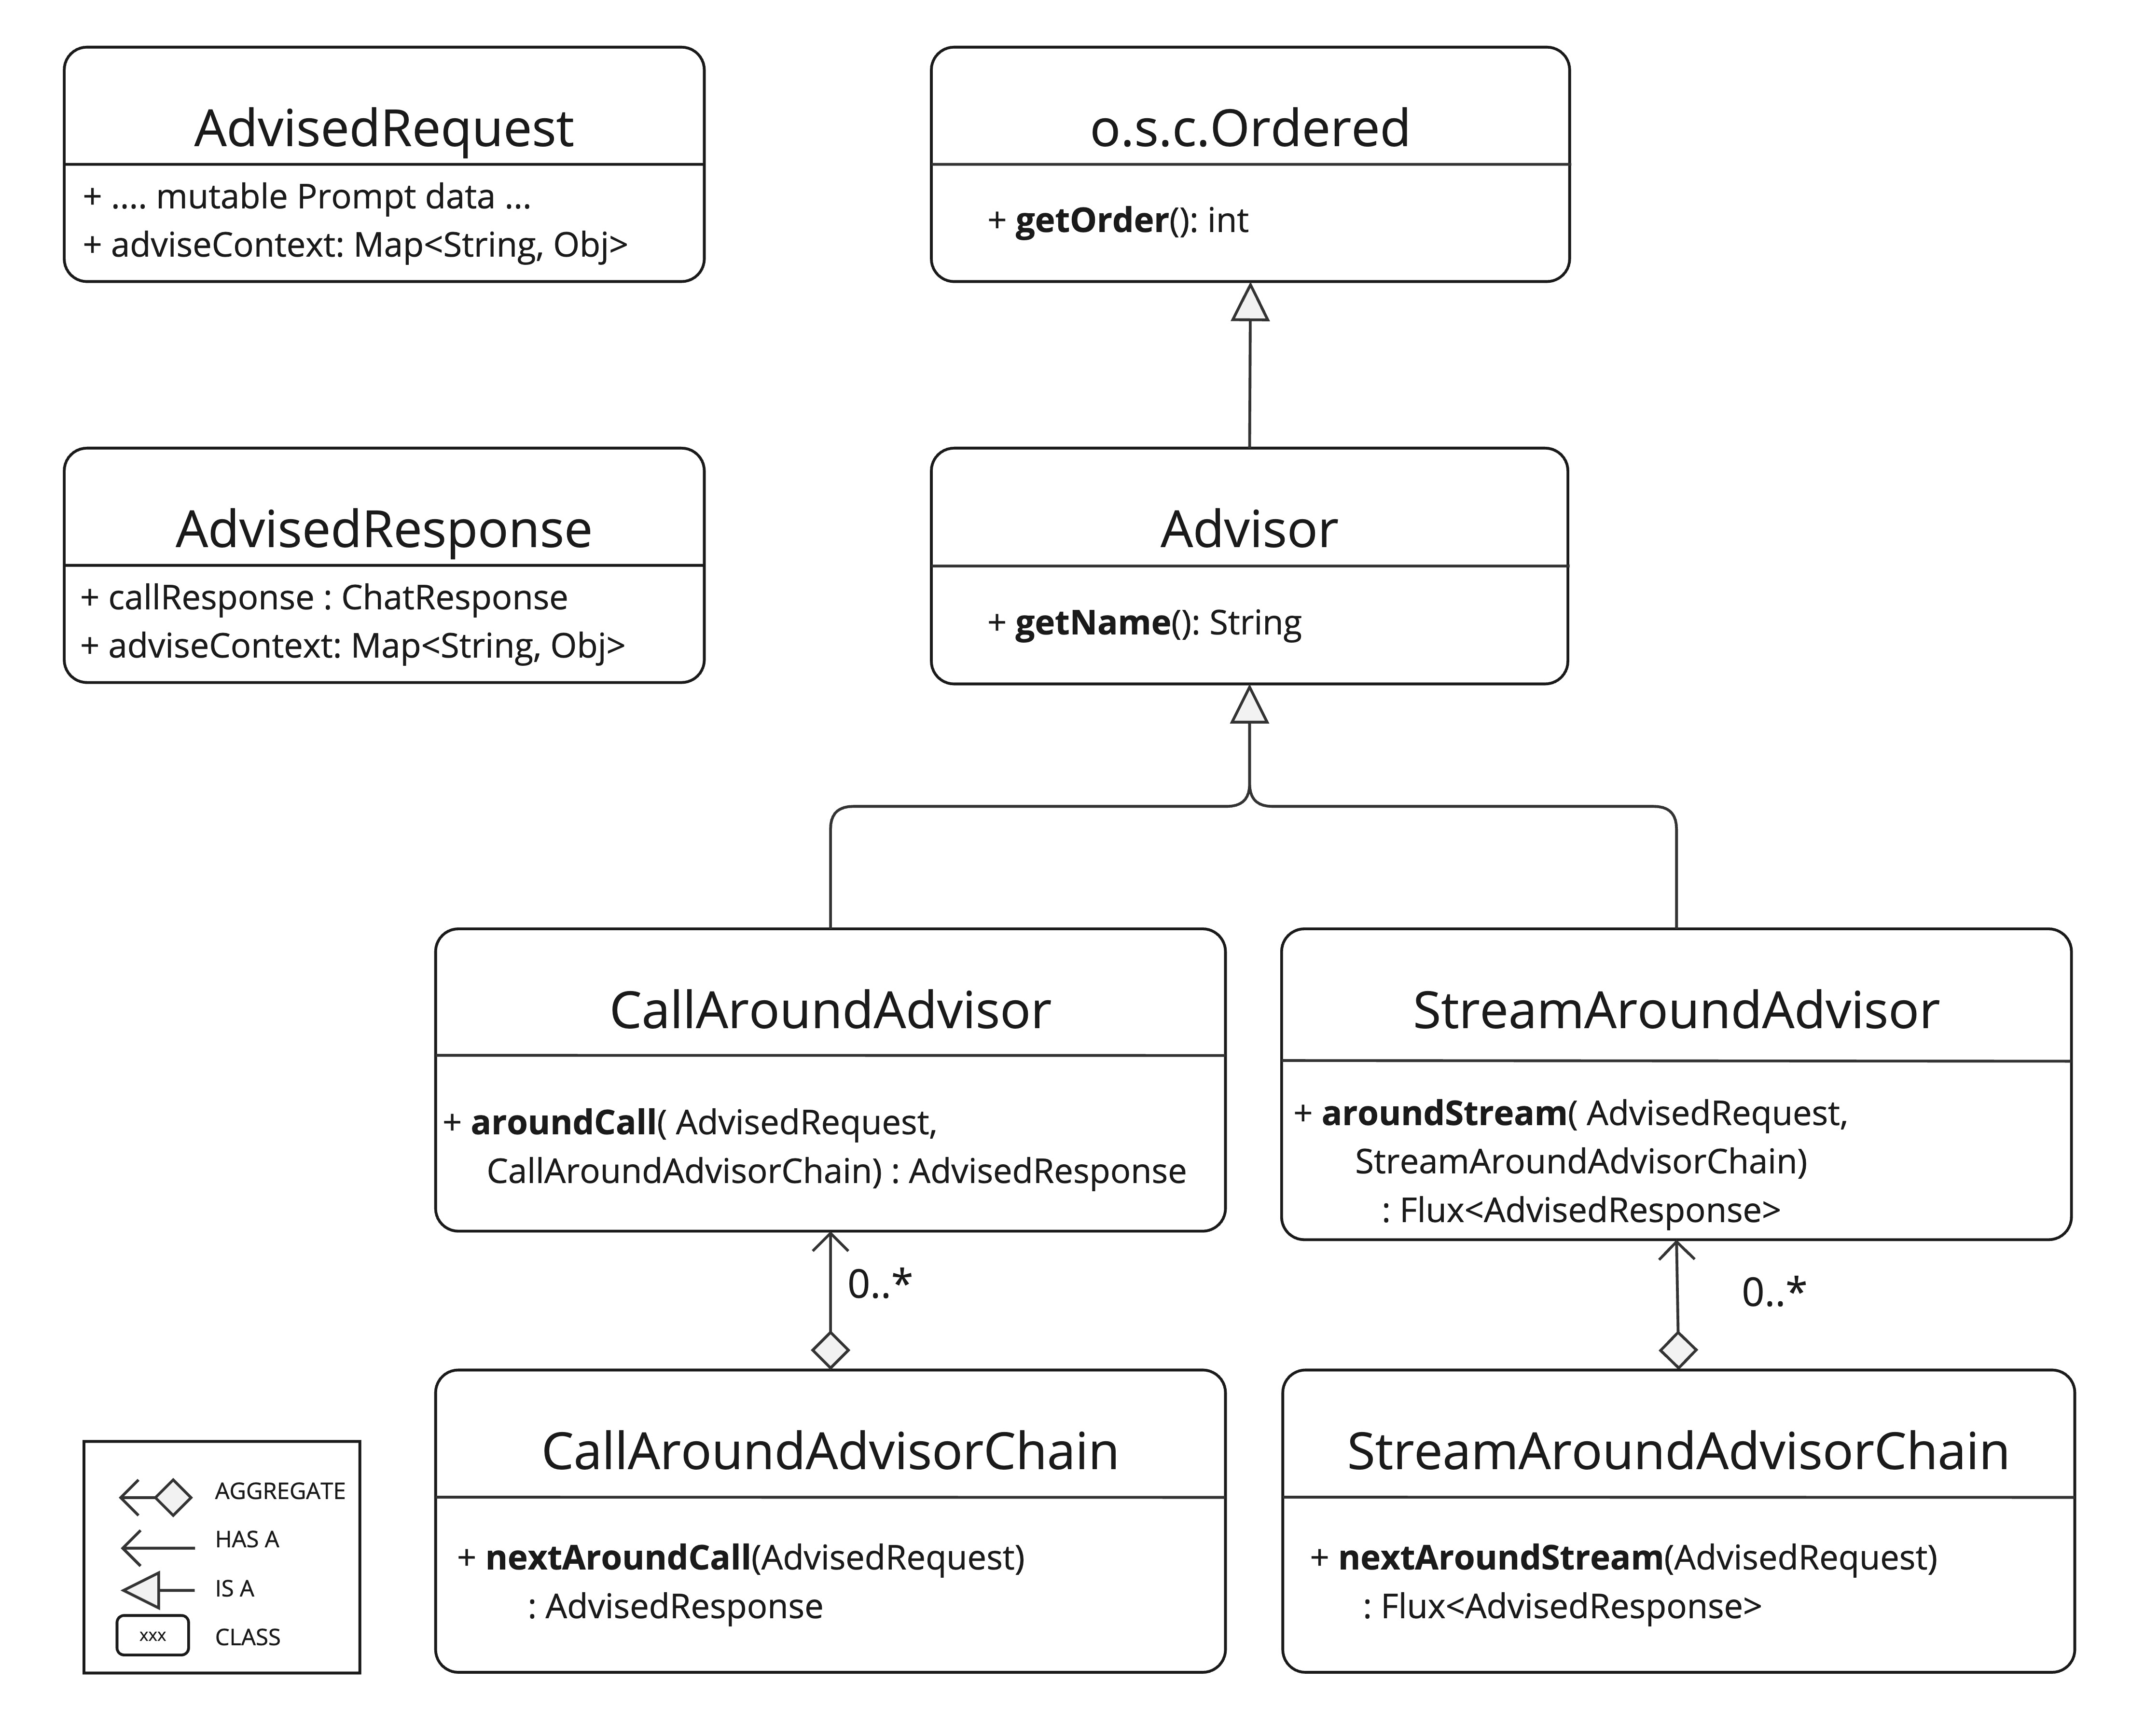
adviseCall() 和 adviseStream() 是关键的顾问方法,通常执行诸如检查未密封的提示数据、自定义和增强提示数据、调用顾问链中的下一个实体、选择性地阻止请求、检查聊天补全响应以及抛出异常以指示处理错误等操作。
此外, getOrder() 方法确定链中通知器的顺序,而 getName() 提供唯一的通知器名称。
由Spring AI框架创建的Advisor链,允许按照其 getOrder() 值顺序依次调用多个advisor。 数值越小,优先级越高,越先执行。 最后一个advisor会自动将请求发送给大语言模型(LLM)。
下图展示了通知器链(advisor chain)与聊天模型(Chat Model)之间的交互:
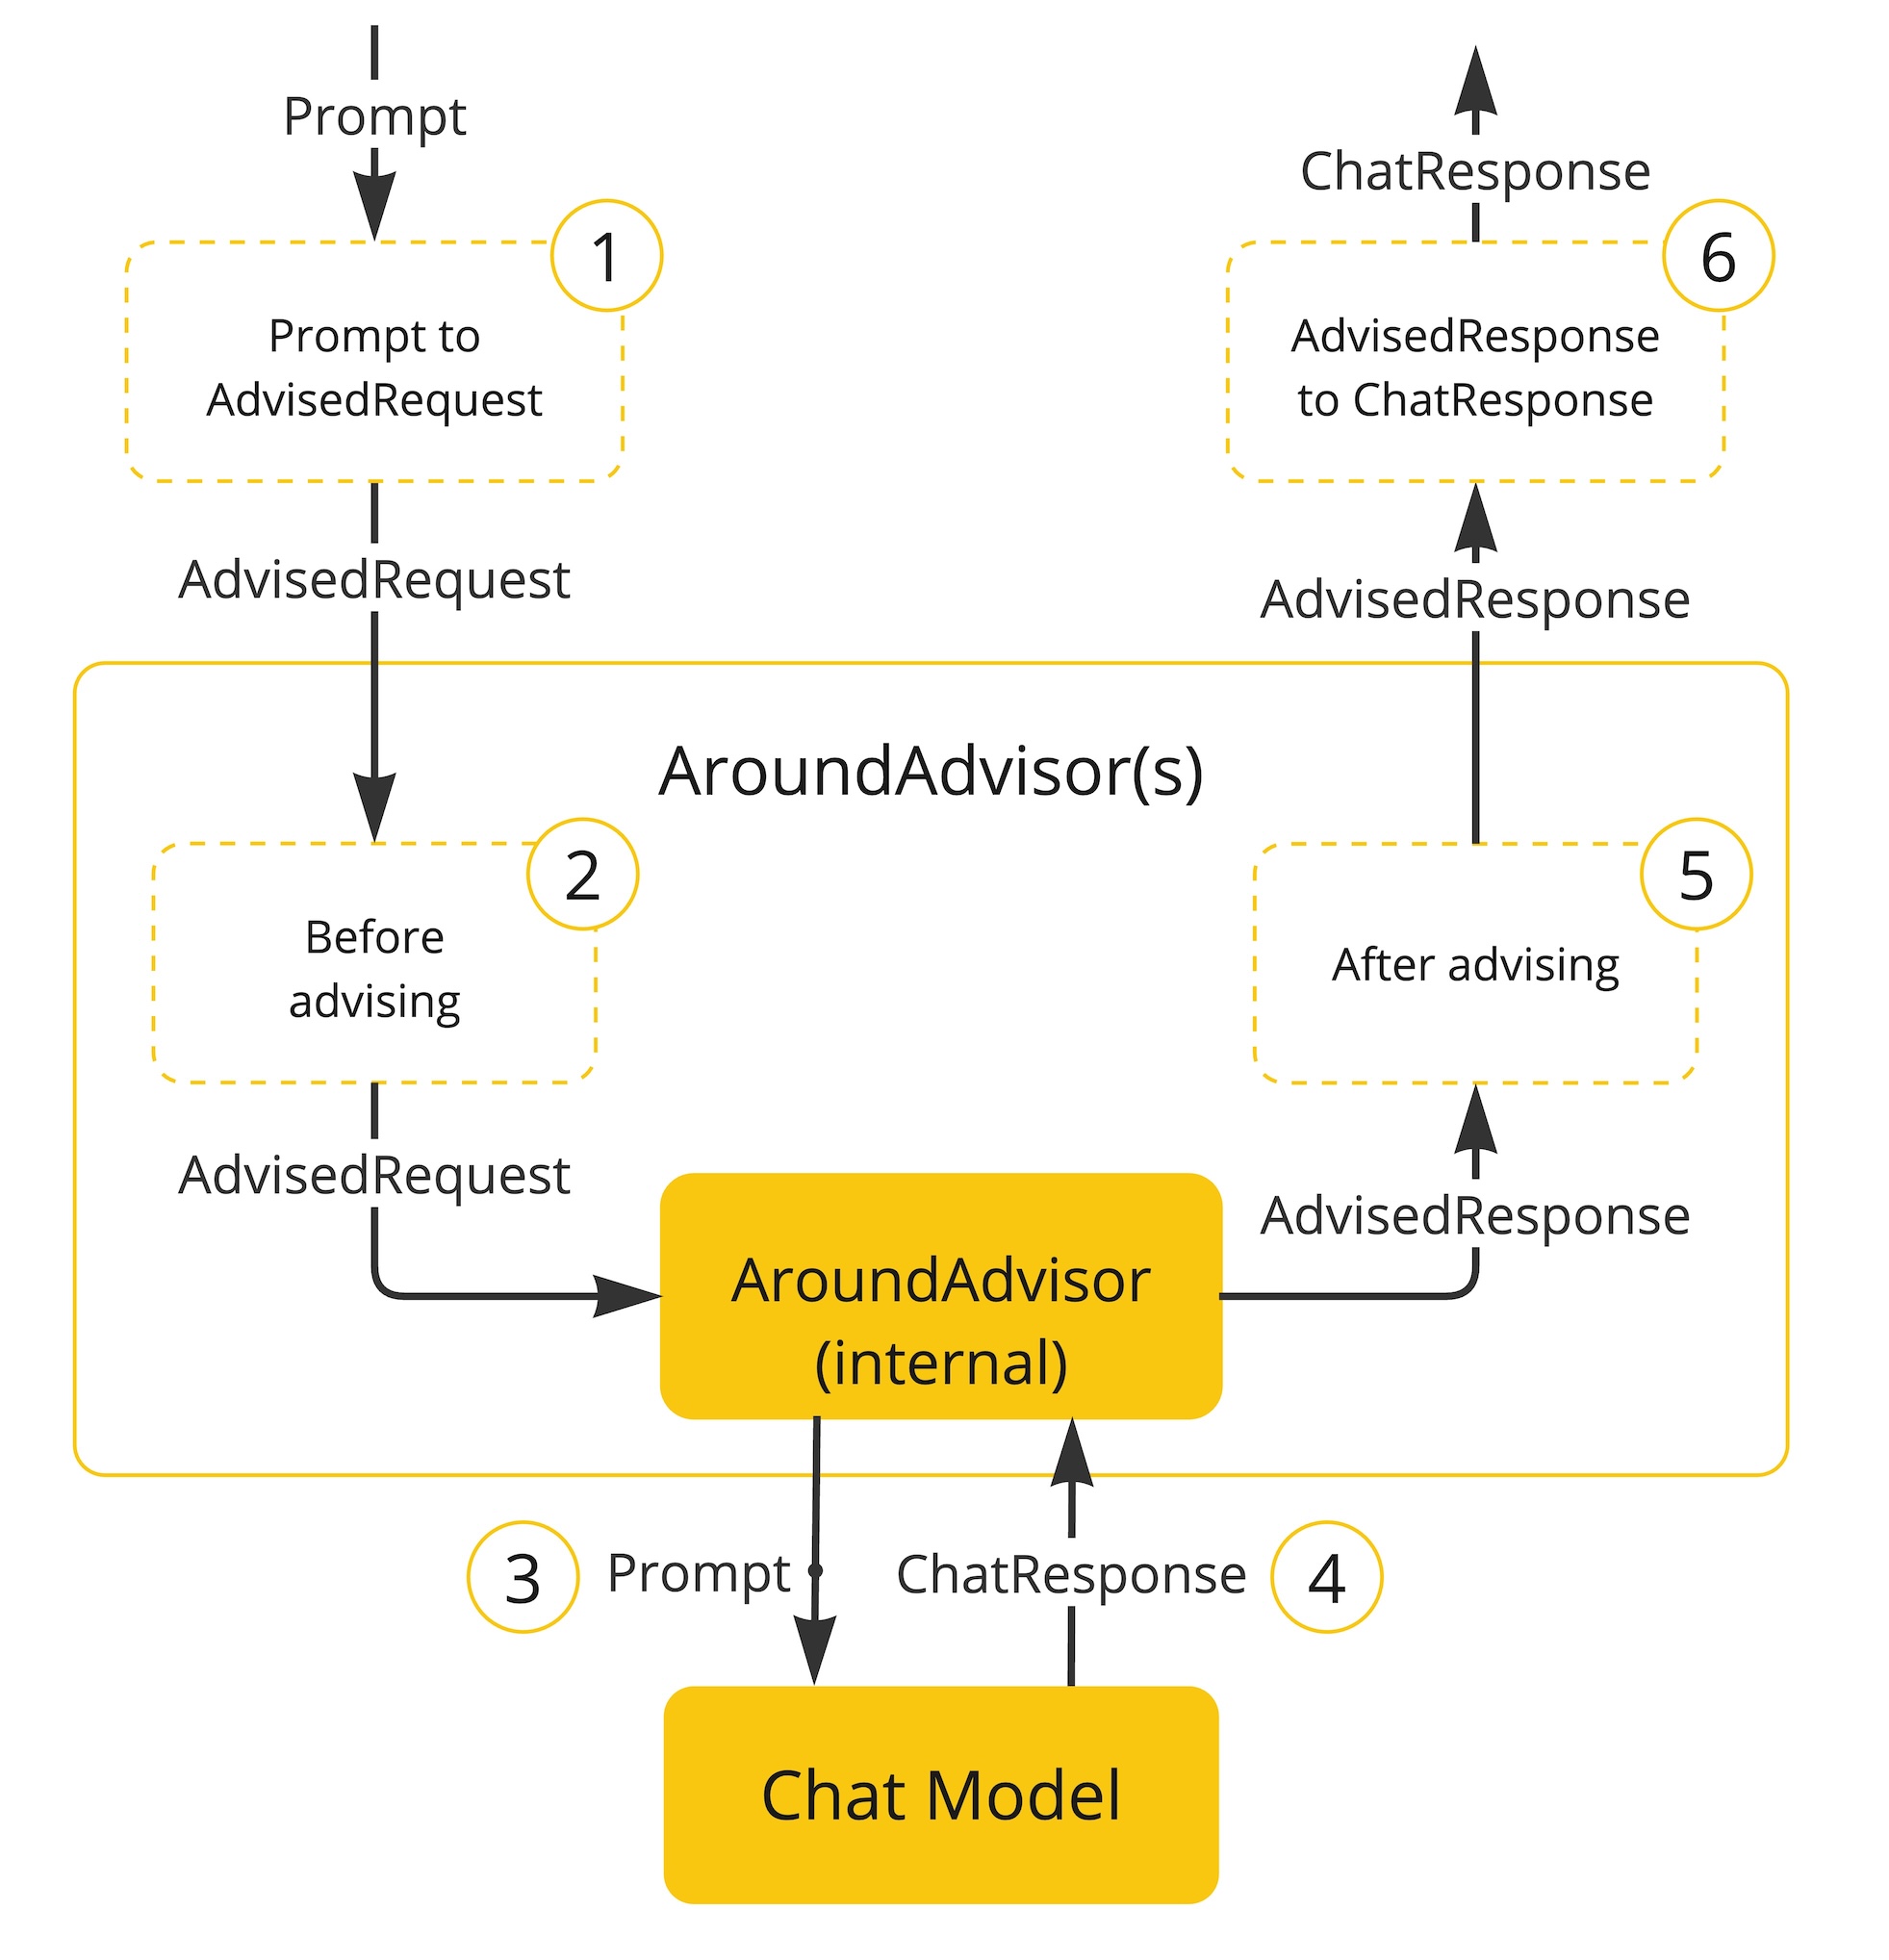
- Spring AI 框架根据用户的
Prompt创建一个ChatClientRequest,以及一个空的顾问context对象。 - 链中的每个通知器都会处理请求,可能会对其进行修改。或者,它也可以选择不调用下一个实体来阻止该请求。在后一种情况下,该通知器负责填充响应。
- 由框架提供的最终通知器,将请求发送到
Chat Model。 - 聊天模型的响应随后会通过顾问链回传,并被转换为
ChatClientResponse。之后包含共享的顾问context实例。 - 每个顾问都可以处理或修改响应。
- 最终的
ChatClientResponse通过提取ChatCompletion返回给客户端。
Advisor Order
顾问在链中的执行顺序由 getOrder() 方法决定。需要理解的关键点:
- 具有较低订单值的顾问会首先执行。
- 顾问链以栈的形式运行:
- 链中的第一个顾问将最先处理该请求。
- 它也是最后一个处理响应的。
- 要控制执行顺序:
- 将订单关闭设置为
Ordered.HIGHEST_PRECEDENCE以确保顾问在链中首先执行(请求处理时优先,响应处理时最后)。 - 将订单关闭设置为
Ordered.LOWEST_PRECEDENCE以确保顾问在链中最后执行(请求处理时最后,响应处理时第一)。
- 将订单关闭设置为
- 较高的值被解释为较低的优先级。
- 如果多个顾问具有相同的订单值,则其执行顺序不保证。
| 看似矛盾的顺序与执行顺序之间的差异,源于顾问链的栈式特性: - 具有最高优先级(最低顺序值)的顾问被添加到堆栈的顶部。 - 它将在栈展开时第一个处理该请求。 - 它将是最后一个处理响应的,因为栈会回退。 |
|---|
作为提醒,以下是 Spring Ordered 接口的语义:
java
public interface Ordered {

    /**
     * Constant for the highest precedence value.
     * @see java.lang.Integer#MIN_VALUE
     */
    int HIGHEST_PRECEDENCE = Integer.MIN_VALUE;

    /**
     * Constant for the lowest precedence value.
     * @see java.lang.Integer#MAX_VALUE
     */
    int LOWEST_PRECEDENCE = Integer.MAX_VALUE;

    /**
     * Get the order value of this object.
     * <p>Higher values are interpreted as lower priority. As a consequence,
     * the object with the lowest value has the highest priority (somewhat
     * analogous to Servlet {@code load-on-startup} values).
     * <p>Same order values will result in arbitrary sort positions for the
     * affected objects.
     * @return the order value
     * @see #HIGHEST_PRECEDENCE
     * @see #LOWEST_PRECEDENCE
     */
    int getOrder();
}| 对于在输入和输出端都需要位于链首的用例: 1. 为每一方使用独立的顾问。 2. 使用不同的顺序值来配置它们。 3. 使用顾问上下文在它们之间共享状态。 |
|---|
API概述
主要的Advisor接口位于包 org.springframework.ai.chat.client.advisor.api 中。以下是您在创建自己的advisor时会遇到的关键接口:
java
public interface Advisor extends Ordered {

    String getName();

}
同步和响应式 Advisor 的两个子接口是:
java
public interface CallAdvisor extends Advisor {

    ChatClientResponse adviseCall(
        ChatClientRequest chatClientRequest, CallAdvisorChain callAdvisorChain);

}
和
java
public interface StreamAdvisor extends Advisor {

    Flux<ChatClientResponse> adviseStream(
        ChatClientRequest chatClientRequest, StreamAdvisorChain streamAdvisorChain);

}
要继续 Advice 的链式调用,请在您的 Advice 实现中使用 CallAdvisorChain 和 StreamAdvisorChain :
这些接口是
java
public interface CallAdvisorChain extends AdvisorChain {

    /**
     * Invokes the next {@link CallAdvisor} in the {@link CallAdvisorChain} with the given
     * request.
     */
    ChatClientResponse nextCall(ChatClientRequest chatClientRequest);

    /**
     * Returns the list of all the {@link CallAdvisor} instances included in this chain at
     * the time of its creation.
     */
    List<CallAdvisor> getCallAdvisors();

}
和
java
public interface StreamAdvisorChain extends AdvisorChain {

    /**
     * Invokes the next {@link StreamAdvisor} in the {@link StreamAdvisorChain} with the
     * given request.
     */
    Flux<ChatClientResponse> nextStream(ChatClientRequest chatClientRequest);

    /**
     * Returns the list of all the {@link StreamAdvisor} instances included in this chain
     * at the time of its creation.
     */
    List<StreamAdvisor> getStreamAdvisors();

}
实现顾问
要创建一个顾问,实现 CallAdvisor 或 StreamAdvisor (或两者都实现)。需要实现的关键方法是对于非流式顾问为 nextCall(),对于流式顾问为 nextStream() 。
示例
我们将提供几个动手示例,以说明如何实现用于观察和增强用例的顾问。
日志顾问
我们可以实现一个简单的日志通知器,它会在调用链中的下一个通知器之前记录 ChatClientRequest,并在之后记录 ChatClientResponse 。 请注意,该通知器仅观察请求和响应,而不会对其进行修改。 此实现同时支持非流式和流式场景。
java
public class SimpleLoggerAdvisor implements CallAdvisor, StreamAdvisor {

    private static final Logger logger = LoggerFactory.getLogger(SimpleLoggerAdvisor.class);

    @Override
    public String getName() { (1)
        return this.getClass().getSimpleName();
    }

    @Override
    public int getOrder() { (2)
        return 0;
    }

    @Override
    public ChatClientResponse adviseCall(ChatClientRequest chatClientRequest, CallAdvisorChain callAdvisorChain) {
        logRequest(chatClientRequest);

        ChatClientResponse chatClientResponse = callAdvisorChain.nextCall(chatClientRequest);

        logResponse(chatClientResponse);

        return chatClientResponse;
    }

    @Override
    public Flux<ChatClientResponse> adviseStream(ChatClientRequest chatClientRequest,
            StreamAdvisorChain streamAdvisorChain) {
        logRequest(chatClientRequest);

        Flux<ChatClientResponse> chatClientResponses = streamAdvisorChain.nextStream(chatClientRequest);

        return new ChatClientMessageAggregator().aggregateChatClientResponse(chatClientResponses, this::logResponse); (3)
    }

    private void logRequest(ChatClientRequest request) {
        logger.debug("request: {}", request);
    }

    private void logResponse(ChatClientResponse chatClientResponse) {
        logger.debug("response: {}", chatClientResponse);
    }

}| 1 | 为顾问提供一个唯一名称。 |
|---|---|
| 2 | 您可以设置 order 值来控制执行顺序。较低的值会优先执行。 |
| 3 | The MessageAggregator is a utility class that aggregates the Flux responses into a single ChatClientResponse. This can be useful for logging or other processing that observe the entire response rather than individual items in the stream. Note that you can not alter the response in the MessageAggregator as it is a read-only operation. |
重新阅读(Re2)顾问
“ 重读提升大型语言模型的推理能力 ”一文介绍了一种名为“重读”(Re2)的技术,该技术能够提升大型语言模型的推理能力。 Re2 技术需要对输入提示进行如下增强:
{Input_Query}
Read the question again: {Input_Query}
实现一个将 Re2 技术应用于用户输入查询的顾问,可以按如下方式完成:
java
public class ReReadingAdvisor implements BaseAdvisor {

    private static final String DEFAULT_RE2_ADVISE_TEMPLATE = """
            {re2_input_query}
            Read the question again: {re2_input_query}
            """;

    private final String re2AdviseTemplate;

    private int order = 0;

    public ReReadingAdvisor() {
        this(DEFAULT_RE2_ADVISE_TEMPLATE);
    }

    public ReReadingAdvisor(String re2AdviseTemplate) {
        this.re2AdviseTemplate = re2AdviseTemplate;
    }

    @Override
    public ChatClientRequest before(ChatClientRequest chatClientRequest, AdvisorChain advisorChain) { (1)
        String augmentedUserText = PromptTemplate.builder()
            .template(this.re2AdviseTemplate)
            .variables(Map.of("re2_input_query", chatClientRequest.prompt().getUserMessage().getText()))
            .build()
            .render();

        return chatClientRequest.mutate()
            .prompt(chatClientRequest.prompt().augmentUserMessage(augmentedUserText))
            .build();
    }

    @Override
    public ChatClientResponse after(ChatClientResponse chatClientResponse, AdvisorChain advisorChain) {
        return chatClientResponse;
    }

    @Override
    public int getOrder() { (2)
        return this.order;
    }

    public ReReadingAdvisor withOrder(int order) {
        this.order = order;
        return this;
    }

}| 1 | The before method augments the user’s input query applying the Re-Reading technique. |
|---|---|
| 2 | 您可以设置 order 值来控制执行顺序。较低的值会优先执行。 |
Spring AI 内置顾问
Spring AI 框架提供了多个内置的顾问,以增强您的 AI 交互。以下是可用顾问的概览:
聊天记忆顾问
这些顾问在聊天记忆存储中管理对话历史:
MessageChatMemoryAdvisor检索内存,并将其作为消息集合添加到提示中。这种方法保持了对话历史的结构。请注意,并非所有 AI 模型都支持这种方法。PromptChatMemoryAdvisor检索记忆并将其整合到提示的系统文本中。VectorStoreChatMemoryAdvisor从 VectorStore 中检索内存,并将其添加到提示的系统文本中。此顾问对于高效地从大型数据集中搜索和检索相关信息非常有用。
问答顾问
QuestionAnswerAdvisor该顾问使用向量存储来提供问答功能,实现了朴素的 RAG(检索增强生成)模式。RetrievalAugmentationAdvisorAdvisor that implements common 检索增强生成(RAG) flows using the building blocks defined in the \`org.springframework.ai.rag\` package and following the Modular RAG Architecture.
推理顾问
ReReadingAdvisor实现了一种用于LLM推理的重读策略,称为RE2,以增强输入阶段的理解。 基于文章:[重读提升LLM的推理能力](arxiv.org/pdf/2309.06275)。
内容安全顾问
SafeGuardAdvisor一个简单的顾问,旨在防止模型生成有害或不适当的内容。
流式传输与非流式传输
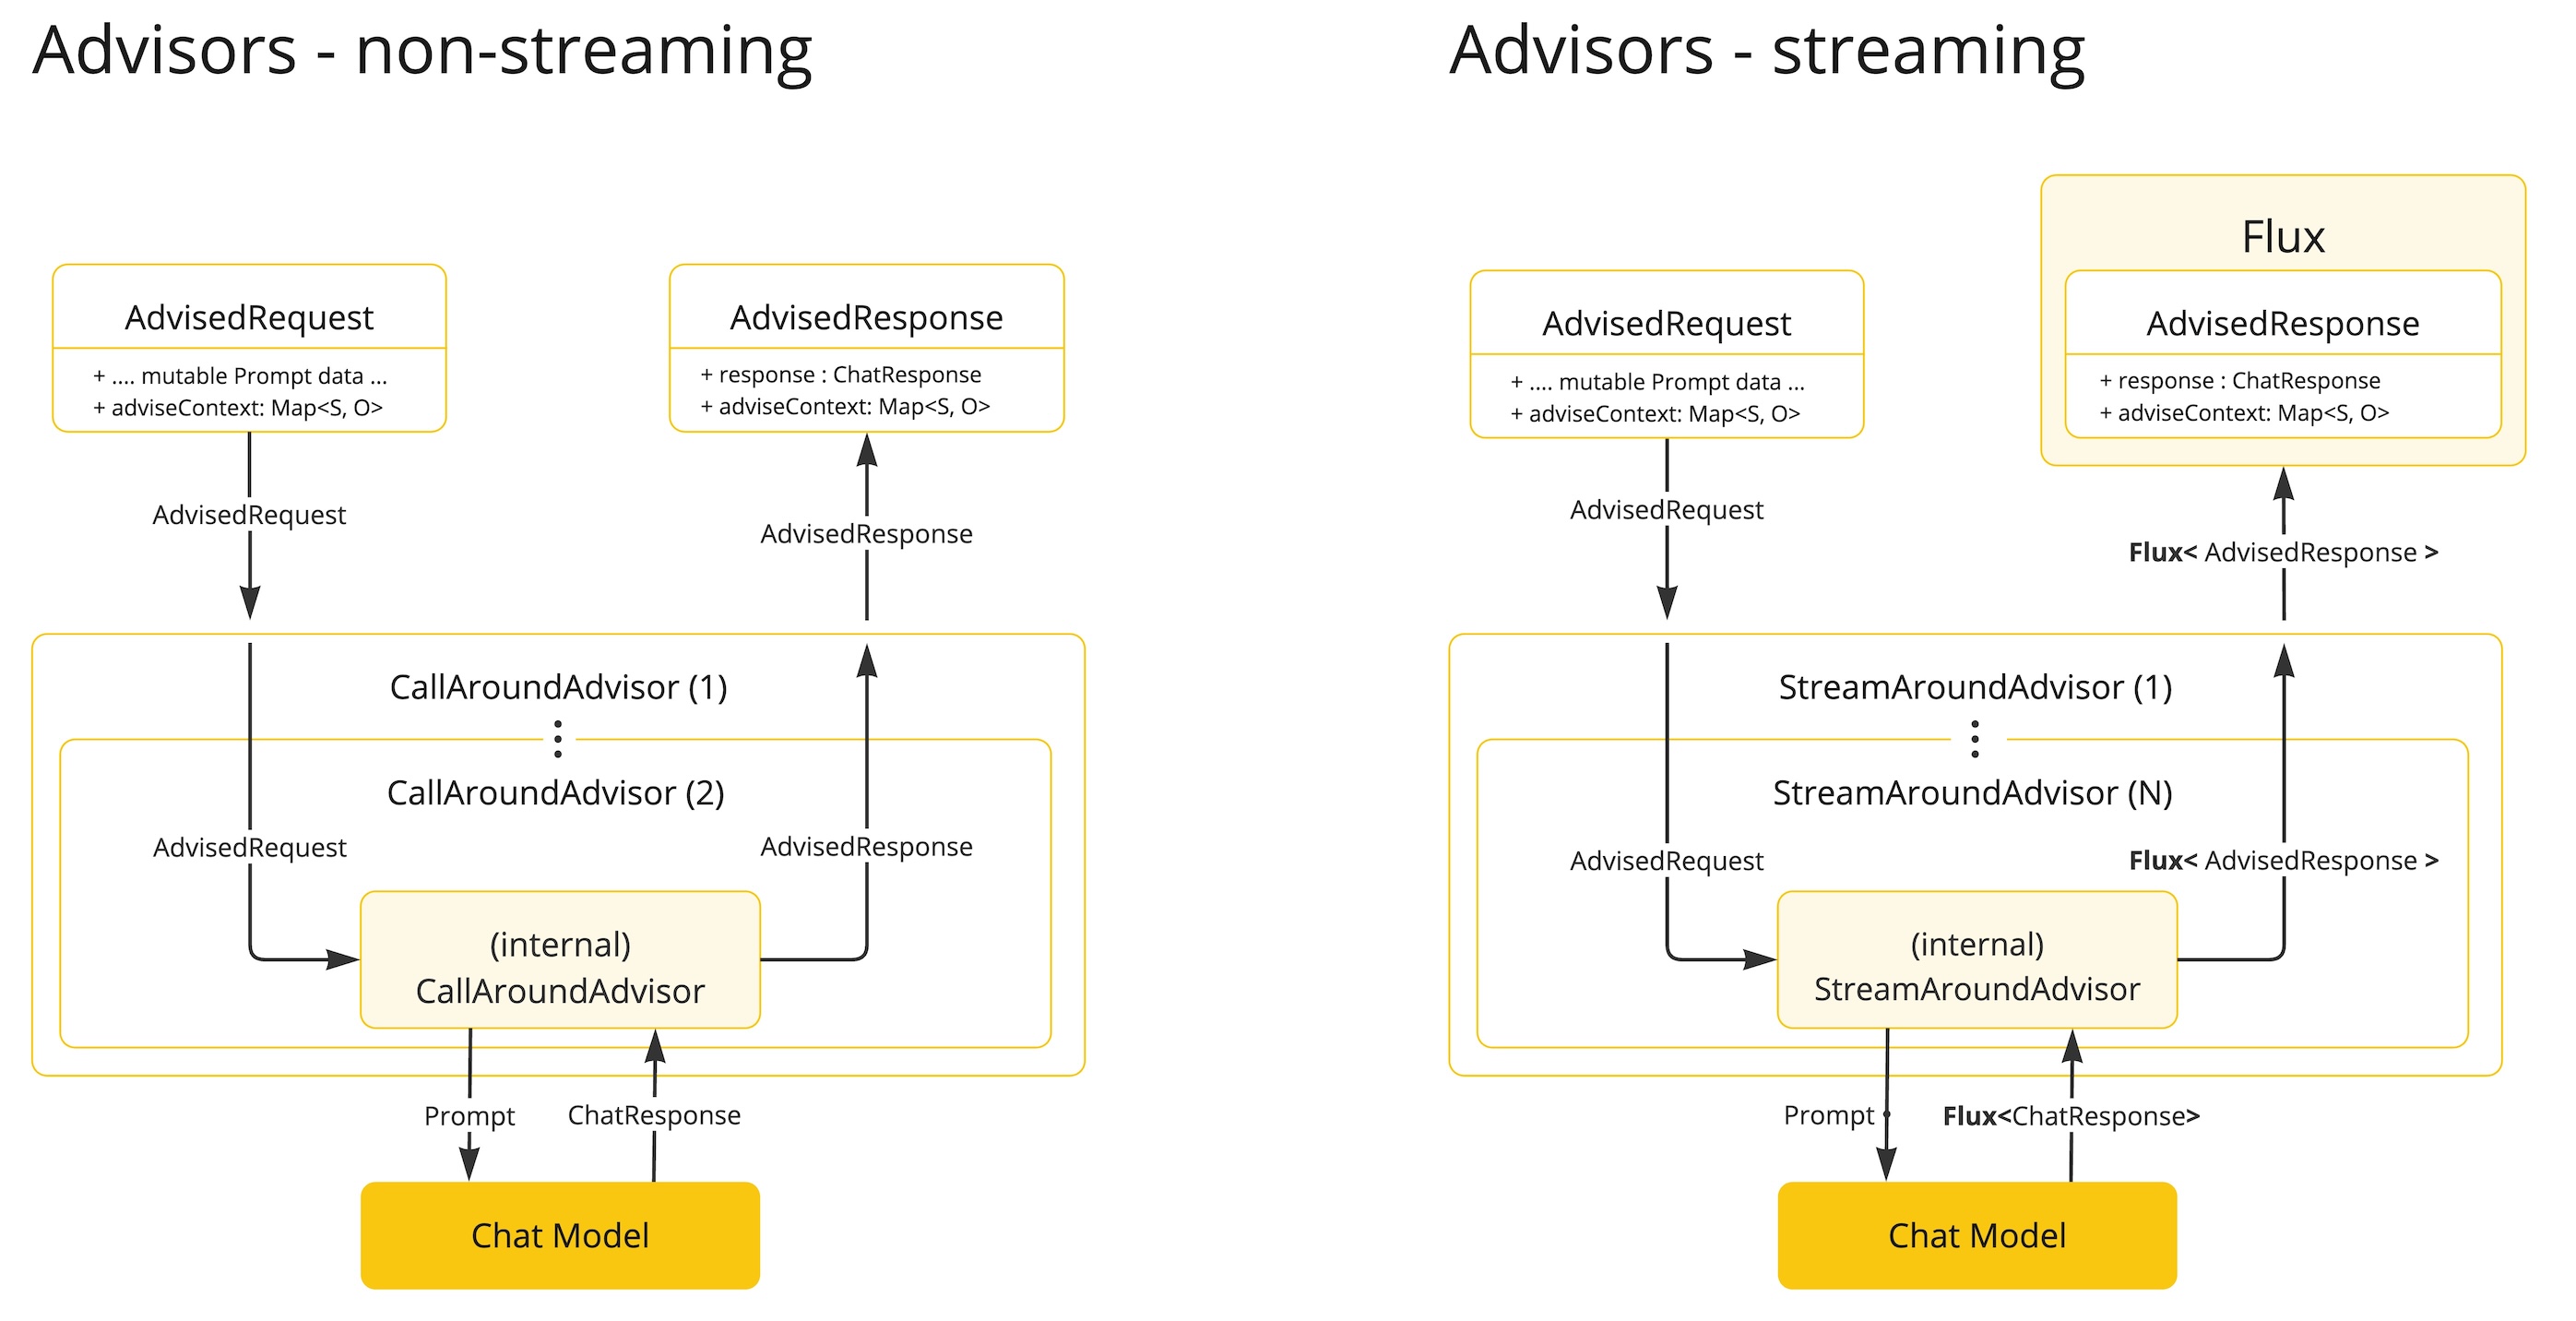
- 非流式通知器处理完整的请求和响应。
- 流式顾问以连续流的形式处理请求和响应,使用响应式编程概念(例如,用于响应的 Flux)。
java
@Override
public Flux<ChatClientResponse> adviseStream(ChatClientRequest chatClientRequest, StreamAdvisorChain chain) {

    return  Mono.just(chatClientRequest)
            .publishOn(Schedulers.boundedElastic())
            .map(request -> {
                // This can be executed by blocking and non-blocking Threads.
                // Advisor before next section
            })
            .flatMapMany(request -> chain.nextStream(request))
            .map(response -> {
                // Advisor after next section
            });
}
最佳实践
- 让顾问专注于特定任务,以实现更好的模块化。
- 使用
adviseContext在必要时在顾问之间共享状态。 - 实现顾问的流式和非流式两种版本,以获得最大的灵活性。
- 仔细考虑通知链中各个通知器的顺序,以确保数据流的正确性。
API 变更说明
顾问接口
- 在1.0 M2版本中,有独立的
RequestAdvisor和ResponseAdvisor接口。RequestAdvisor在ChatModel.call和ChatModel.stream方法之前被调用。ResponseAdvisor在以下方法之后被调用。
- 在 1.0 M3 版本中,这些接口已被替换为:
CallAroundAdvisorStreamAroundAdvisor
StreamResponseMode(以前是ResponseAdvisor的一部分)已被移除。- 在 1.0.0 版本中,这些接口已被替换:
CallAroundAdvisor→CallAdvisor,StreamAroundAdvisor→StreamAdvisor,CallAroundAdvisorChain→CallAdvisorChain以及StreamAroundAdvisorChain→StreamAdvisorChain。AdvisedRequest→ChatClientRequest和AdivsedResponse→ChatClientResponse。
上下文映射处理
- 在 1.0 M2 版本中:
- 上下文映射是一个独立的方法参数。
- 该映射是可变的,并沿着链传递。
- 在 1.0 M3 版本中:
- 上下文映射现在是
AdvisedRequest和AdvisedResponse记录的一部分。 - 该映射是不可变的。
- 要更新上下文,请使用
updateContext方法,该方法会创建一个包含更新内容的新不可变映射。
- 上下文映射现在是
递归顾问
什么是递归顾问?

Advisors Recursive
递归顾问是一种特殊类型的顾问,可以多次遍历下游顾问链。 当需要重复调用LLM直到满足特定条件时,此模式非常有用,例如:
- 在循环中执行工具调用,直到没有更多需要调用的工具为止
- 验证结构化输出,并在验证失败时重试
- 使用对请求的修改来实现评估逻辑
- 使用对请求的修改实现重试逻辑
CallAdvisorChain.copy(CallAdvisor after) 方法是实现递归通知器模式的关键工具。 它创建了一个新的通知器链,该链仅包含原始链中指定通知器之后的通知器, 并允许递归通知器根据需要调用此子链。 这种方法确保了:
- 递归顾问可以遍历链中剩余的顾问
- 链中的其他通知器可以观察并拦截每次迭代
- 通知器链保持了正确的顺序和可观测性
- 递归通知器不会重新执行在它之前的通知器
内置递归顾问
Spring AI 提供了两个内置的递归顾问(recursive advisors),用于演示此模式:
工具调用顾问
ToolCallAdvisor 将工具调用循环作为顾问链的一部分来实现,而不是依赖模型的内部工具执行。这使得链中的其他顾问能够拦截并观察工具调用过程。
主要特性:
- 通过设置
setInternalToolExecutionEnabled(false)来禁用模型的内部工具执行 - 遍历顾问链,直到不再存在工具调用为止
- 支持“直接返回”功能 - 当工具执行的返回值为
returnDirect=true时,将中断工具调用循环,并将工具执行结果直接返回给客户端应用,而不是将其发送回大语言模型(LLM) - 使用
callAdvisorChain.copy(this)为递归调用创建子链 - 包含空安全性检查,以处理聊天响应可能为 null 的情况
- 通过
conversationHistoryEnabled支持可配置的对话历史管理
示例用法:
java
var toolCallAdvisor = ToolCallAdvisor.builder()
    .toolCallingManager(toolCallingManager)
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300)
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(toolCallAdvisor)
    .build();
会话历史管理
ToolCallAdvisor 包含一个 conversationHistoryEnabled 配置选项,用于控制在工具调用迭代过程中对话历史的管理方式。
默认情况下( conversationHistoryEnabled=true ),顾问会在工具调用迭代期间在内部维护完整的对话历史。这意味着在工具调用循环中的每次后续LLM调用都会包含所有之前的消息(用户消息、助手回复、工具回复)。
使用 .disableMemory() 方法可禁用内部对话历史管理。禁用后,仅将上一次工具响应消息传递给下一次迭代。这在以下情况下很有用:
- 您在链中的下一个位置已注册了一个聊天记忆顾问,该顾问已负责管理对话历史
- 您希望减少Tokens使用量,避免重复管理历史记录
- 你正在与外部对话记忆系统进行集成
对话历史禁用的示例:
java
var toolCallAdvisor = ToolCallAdvisor.builder()
    .toolCallingManager(toolCallingManager)
    .disableMemory()  // Disable internal history - let ChatMemory handle it
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300)
    .build();

var chatMemoryAdvisor = MessageChatMemoryAdvisor.builder(chatMemory)
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 200)  // Positioned before ToolCallAdvisor
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(chatMemoryAdvisor, toolCallAdvisor)
    .build();
返回直接功能
“直接返回”功能允许工具绕过大语言模型(LLM),将其结果直接返回给客户端应用程序。当满足以下情况时,该功能非常有用:
- 该工具的输出即为最终答案,无需经过大语言模型处理
- 您希望减少延迟,避免额外的大语言模型调用
- 工具结果应原样返回,无需解释
当工具执行结果为 returnDirect=true 时, ToolCallAdvisor 将:
- 正常执行工具调用
- 检测
returnDirect标志的ToolExecutionResult - 跳出工具调用循环
- 直接将工具执行结果以
ChatResponse的形式返回给客户端应用程序,工具的输出作为生成内容
结构化输出验证顾问
StructuredOutputValidationAdvisor 会将结构化的 JSON 输出与生成的 JSON 模式进行验证,如果验证失败,则最多重试指定次数。
主要特性:
- 自动根据预期输出类型生成 JSON 模式
- 根据模式验证LLM的响应
- 如果验证失败,则重试调用,最多可配置指定次数的尝试
- 在重试尝试时,通过添加验证错误消息来增强提示,以帮助大语言模型纠正其输出
- 使用
callAdvisorChain.copy(this)为递归调用创建子链 - 可选地支持为JSON处理指定自定义的
ObjectMapper
示例用法:
java
var validationAdvisor = StructuredOutputValidationAdvisor.builder()
    .outputType(MyResponseType.class)
    .maxRepeatAttempts(3)
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 1000)
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(validationAdvisor)
    .build();
提示
提示是引导AI模型生成特定输出的输入信息。这些提示的设计和措辞极大地影响着模型的响应。
在Spring AI中与AI模型进行交互的最低层级,处理提示的方式有点类似于在Spring MVC中管理“视图”。 这包括创建包含动态内容占位符的大量文本。 这些占位符随后会根据用户请求或应用程序中的其他代码进行替换。 另一个类比是包含某些表达式占位符的SQL语句。
随着Spring AI的发展,它将为与AI模型的交互引入更高级别的抽象。 本节中描述的基础类在角色和功能上可类比于JDBC。 例如, ChatModel 类类似于JDK中的核心JDBC库。 ChatClient 类则可类比于构建在 ChatModel 之上的 JdbcClient ,通过 Advisor 来考虑与模型的过往交互,为提示添加额外的上下文文档,并引入代理行为构造。
AI领域中提示的结构随着时间的推移而发展。 起初,提示仅为简单的字符串。 随着时间的推移,它们开始包含特定输入的占位符,如 "USER:",AI模型能够识别这些占位符。 OpenAI进一步引入了更为结构化的提示处理方式,在AI模型处理之前,将多条消息字符串划分为不同的角色类别。
API概述
提示
在使用 call() 方法时很常见,该方法属于 ChatModel ,它接受一个 Prompt 实例并返回一个 ChatResponse 。
Prompt 类作为一系列有序的 Message 对象和请求 ChatOptions 的容器发挥作用。 每个 Message 在提示中承担着独特角色,其内容和目的各不相同。 这些角色可以包括多种元素,从用户查询到AI生成的响应,再到相关背景信息等。 这种安排使得与AI模型的交互变得复杂而详尽,因为提示由多个消息构建而成,每个消息在对话中被分配了特定的角色。
以下是Prompt类的简化版本,为了简洁起见,省略了构造器和实用方法:
java
public class Prompt implements ModelRequest<List<Message>> {

    private final List<Message> messages;

    private ChatOptions chatOptions;
}
便捷方法
Prompt 类提供了几种通过角色访问消息的便捷方法:
单消息访问:
getUserMessage(): 返回提示中的最后一条用户消息,如果不存在则返回空的UserMessagegetSystemMessage(): 返回提示中的第一条系统消息,如果不存在则返回空的SystemMessagegetLastUserOrToolResponseMessage(): 返回最后一个用户或工具响应消息,有助于保持对话连贯性
多消息访问:
getUserMessages(): 返回提示中的所有用户消息列表,保留它们的顺序getSystemMessages(): 返回提示中的所有系统消息列表,保留它们的顺序
这些方法在处理多轮对话或需要按角色处理消息时特别有用。
消息
Message 接口封装了一个 Prompt 文本内容、一组元数据属性及一个称为 MessageType 的分类。
接口定义如下:
java
public interface Content {

    String getContent();

    Map<String, Object> getMetadata();
}

public interface Message extends Content {

    MessageType getMessageType();
}
多模态消息类型也实现了 MediaContent 接口,提供了 Media 内容对象的列表。
java
public interface MediaContent extends Content {

    Collection<Media> getMedia();

}
Message 接口的不同实现对应于AI模型可以处理的不同类别消息。 模型根据对话角色来区分消息类别。
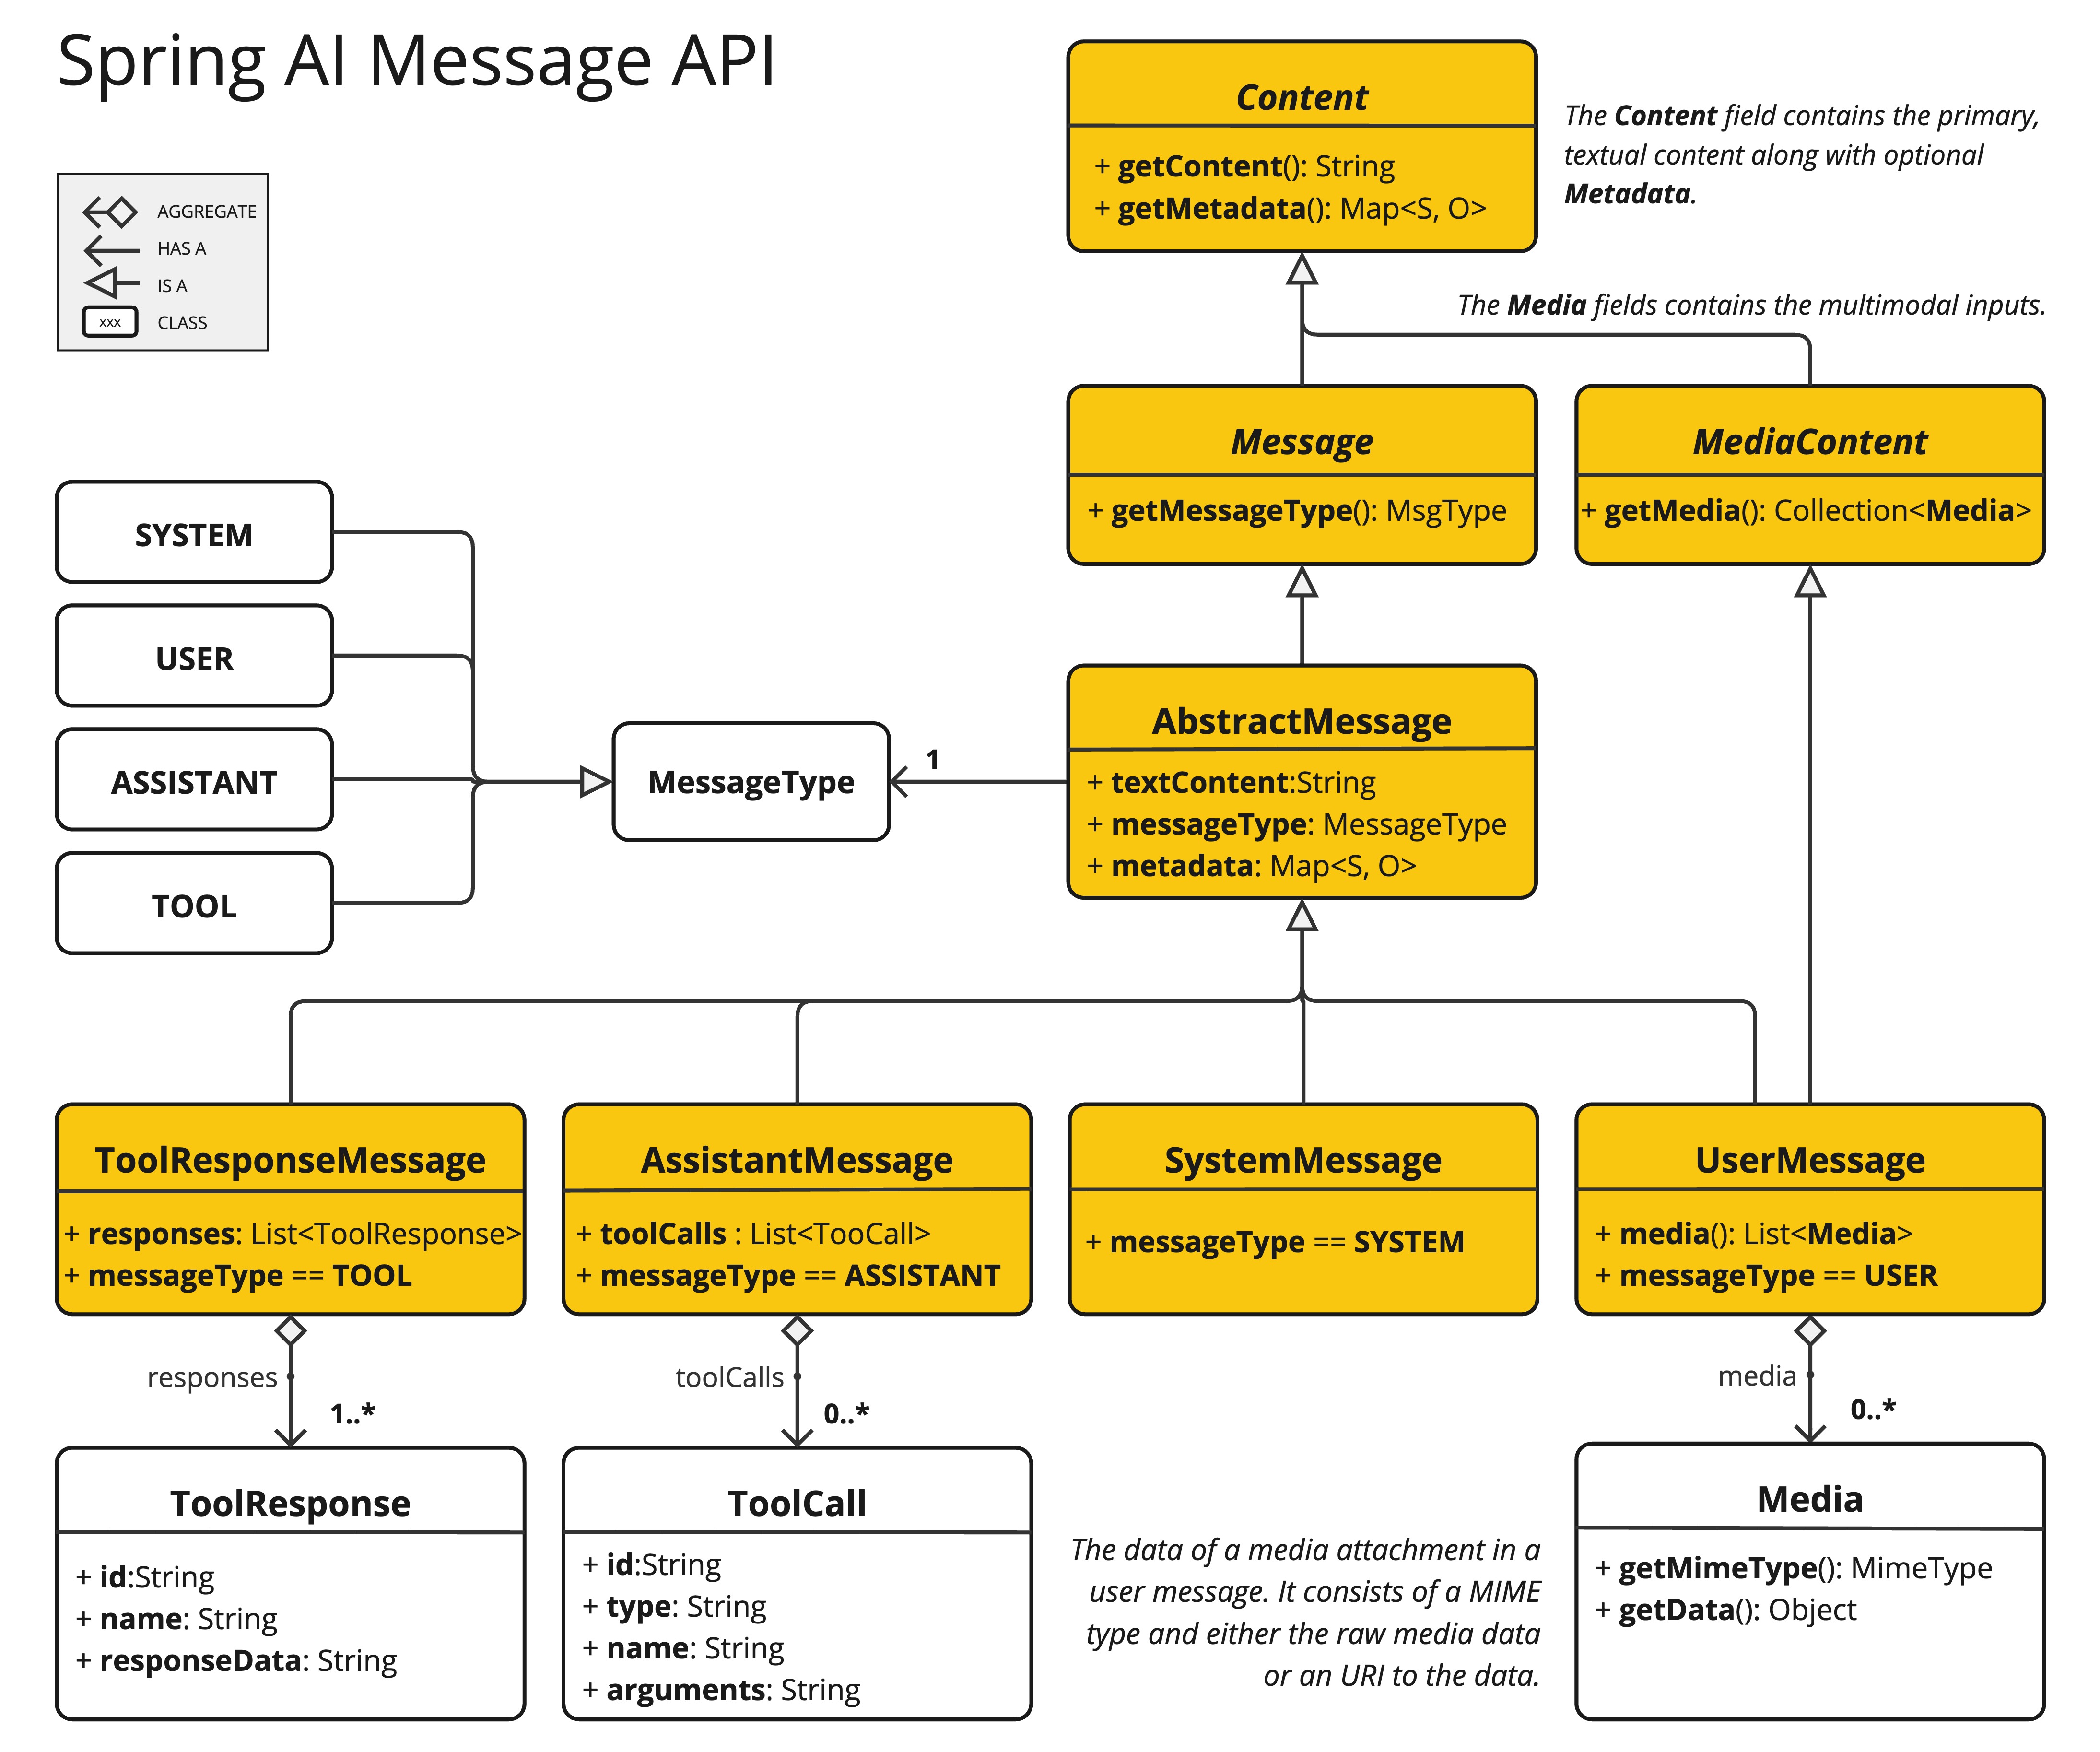
这些角色由 MessageType 有效地映射,如下所述。
角色
每条消息都被赋予了一个特定的角色。 这些角色对消息进行分类,明确了提示中各部分的上下文和目的,以便AI模型理解。 这种结构化的方法增强了与AI沟通的细微度和有效性,因为提示的每一部分都在交互中扮演着独特而明确的角色。
主要角色包括:
- 系统角色:指导AI的行为和回应风格,为AI如何解释和回复输入设定参数或规则。这类似于在开始对话前向AI提供指导说明。
- 用户角色:代表用户的输入——他们向AI提出的问题、命令或陈述。此角色至关重要,因为它构成了AI响应的基础。
- 助手角色:AI针对用户输入的回应。 它不仅仅是一个答案或反应,对于维持对话的流畅性至关重要。 通过追踪AI之前的回应(即其'助手角色'消息),系统确保了互动的一致性和上下文相关性。 助手消息中还可能包含功能工具调用请求信息。 这就像AI中的一项特殊功能,在需要执行特定功能时使用,如计算、获取数据或其他超出简单对话的任务。
- 工具/功能角色:工具/功能角色专注于在响应工具调用助手消息时返回额外信息。
在Spring AI中,角色通过枚举表示,如下所示
java
public enum MessageType {

    USER("user"),

    ASSISTANT("assistant"),

    SYSTEM("system"),

    TOOL("tool");

    ...
}
提示模板
Spring AI中用于快速模板化的核心组件是 PromptTemplate 类,旨在简化结构化提示的创建,这些提示随后被发送给AI模型进行处理
java
public class PromptTemplate implements PromptTemplateActions, PromptTemplateMessageActions {

    // Other methods to be discussed later
}
此类使用 TemplateRenderer API来渲染模板。默认情况下,Spring AI采用基于Terence Parr开发的开源 StringTemplate 引擎的 StTemplateRenderer 实现。模板变量通过 {} 语法标识,但您也可以配置分隔符以使用其他语法。
java
public interface TemplateRenderer extends BiFunction<String, Map<String, Object>, String> {

    @Override
    String apply(String template, Map<String, Object> variables);

}
Spring AI 通过使用 TemplateRenderer 接口来处理将变量实际替换到模板字符串中的操作。 默认实现使用了 [StringTemplate] 。 如果您需要自定义逻辑,可以提供自己的 TemplateRenderer 实现。 对于无需模板渲染的场景(例如,模板字符串已经是完整的),您可以使用提供的 NoOpTemplateRenderer 。
使用自定义StringTemplate渲染器的示例,其中 '<' 和 '>' 用作定界符
java
PromptTemplate promptTemplate = PromptTemplate.builder()
    .renderer(StTemplateRenderer.builder().startDelimiterToken('<').endDelimiterToken('>').build())
    .template("""
            Tell me the names of 5 movies whose soundtrack was composed by <composer>.
            """)
    .build();

String prompt = promptTemplate.render(Map.of("composer", "John Williams"));
此类实现的接口支持提示创建的不同方面:
PromptTemplateStringActions 专注于创建和渲染提示字符串,代表了最基础的提示生成形式。
PromptTemplateMessageActions 专为通过生成和操作 Message 对象来创建提示而设计。
PromptTemplateActions 被设计为返回 Prompt 对象,该对象可传递给 ChatModel 以生成响应。
尽管这些接口在许多项目中可能不会被广泛使用,但它们展示了创建提示的不同方法。
实现的接口有
java
public interface PromptTemplateStringActions {

    String render();

    String render(Map<String, Object> model);

}
方法 String render(): 将提示模板渲染为最终字符串格式,无需外部输入,适用于无占位符或动态内容的模板。
方法 String render(Map<String, Object> model): 增强渲染功能,包含动态内容。它使用一个 Map<String, Object> ,其中映射的键是提示模板中的占位符名称,值是要插入的动态内容。
java
public interface PromptTemplateMessageActions {

    Message createMessage();

    Message createMessage(List<Media> mediaList);

    Message createMessage(Map<String, Object> model);

}
方法 Message createMessage(): 创建一个没有附加数据的 Message 对象,用于静态或预定义的消息内容。
方法 Message createMessage(List<Media> mediaList): 使用静态文本和媒体内容创建一个 Message 对象。
方法 Message createMessage(Map<String, Object> model): 扩展消息创建以集成动态内容,接受一个 Map<String, Object> ,其中每个条目代表消息模板中的占位符及其对应的动态值。
java
public interface PromptTemplateActions extends PromptTemplateStringActions {

    Prompt create();

    Prompt create(ChatOptions modelOptions);

    Prompt create(Map<String, Object> model);

    Prompt create(Map<String, Object> model, ChatOptions modelOptions);

}
方法 Prompt create(): 生成一个 Prompt 对象,无需外部数据输入,适用于静态或预定义的提示。
方法 Prompt create(ChatOptions modelOptions): 生成一个 Prompt 对象,无需外部数据输入,并为聊天请求提供特定选项。
方法 Prompt create(Map<String, Object> model): 扩展了提示创建功能,以包含动态内容,接受一个 Map<String, Object> ,其中每个映射条目都是提示模板中的占位符及其关联的动态值。
方法 Prompt create(Map<String, Object> model, ChatOptions modelOptions): 扩展了提示创建功能,以包含动态内容,接受一个 Map<String, Object> ,其中每个映射条目都是提示模板中的占位符及其关联的动态值,以及聊天请求的具体选项。
示例用法
一个简单的示例,取自 AI工作坊中的PromptTemplates ,如下所示。
java
PromptTemplate promptTemplate = new PromptTemplate("Tell me a {adjective} joke about {topic}");

Prompt prompt = promptTemplate.create(Map.of("adjective", adjective, "topic", topic));

return chatModel.call(prompt).getResult();
另一个来自 AI角色工作坊 的例子如下所示。
java
String userText = """
    Tell me about three famous pirates from the Golden Age of Piracy and why they did.
    Write at least a sentence for each pirate.
    """;

Message userMessage = new UserMessage(userText);

String systemText = """
  You are a helpful AI assistant that helps people find information.
  Your name is {name}
  You should reply to the user's request with your name and also in the style of a {voice}.
  """;

SystemPromptTemplate systemPromptTemplate = new SystemPromptTemplate(systemText);
Message systemMessage = systemPromptTemplate.createMessage(Map.of("name", name, "voice", voice));

Prompt prompt = new Prompt(List.of(userMessage, systemMessage));

List<Generation> response = chatModel.call(prompt).getResults();
这展示了如何使用 Prompt 实例,通过 SystemPromptTemplate 来创建一个带有系统角色的 Message ,并传入占位符值。 接着,具有角色 user 的消息与角色 system 的消息结合,形成提示语。 该提示语随后被传递给ChatModel以获得生成式响应。
使用自定义模板渲染器
可以通过实现 TemplateRenderer 接口并将它传递给 PromptTemplate 构造器来使用自定义的模板渲染器。您也可以继续使用默认的 StTemplateRenderer ,但采用自定义配置。
默认情况下,模板变量通过 {} 语法来标识。如果您计划在提示中包含JSON,可能需要使用不同的语法以避免与JSON语法冲突。例如,您可以使用 < 和 > 作为分隔符。
java
PromptTemplate promptTemplate = PromptTemplate.builder()
    .renderer(StTemplateRenderer.builder().startDelimiterToken('<').endDelimiterToken('>').build())
    .template("""
            Tell me the names of 5 movies whose soundtrack was composed by <composer>.
            """)
    .build();

String prompt = promptTemplate.render(Map.of("composer", "John Williams"));
使用资源而非原始字符串
Spring AI 支持 org.springframework.core.io.Resource 抽象,因此您可以将提示数据放入一个文件中,该文件可直接在 PromptTemplate 中使用。 例如,您可以在 Spring 管理的组件中定义一个字段来检索 Resource 。
java
@Value("classpath:/prompts/system-message.st")
private Resource systemResource;
然后将该资源直接传递给 SystemPromptTemplate 。
java
SystemPromptTemplate systemPromptTemplate = new SystemPromptTemplate(systemResource);提示工程
在生成式AI中,提示的创建是开发者的一项关键任务。 这些提示的质量和结构极大地影响着AI输出的有效性。 投入时间和精力设计周到的提示,可以大大提高AI产生的结果。
在AI领域,分享和讨论提示是一种普遍做法。 这种合作方式不仅创建了共享的学习环境,还促进了高效提示的识别与应用。
该领域的研究常常涉及分析和比较不同的提示语,以评估它们在不同情境下的有效性。 例如,一项重要研究表明,以“深呼吸,一步一步解决这个问题”开始的提示语显著提高了问题解决效率。 这凸显了精心挑选的语言对生成式AI系统性能的影响。
掌握提示的有效使用方法,特别是在人工智能技术的快速发展下,是一个持续的挑战。 您应当认识到提示工程的重要性,并考虑利用社区和研究的洞见来改进提示创建策略。
创建有效提示
在设计提示时,整合以下几个关键要素以确保清晰度和有效性至关重要:
- 指示: 向AI提供清晰直接的指示,就像与人沟通一样。这种清晰度对于帮助AI“理解”期望的内容至关重要。
- 外部上下文: 根据需要包含相关的背景信息或对AI响应的具体指导。这个“外部上下文”构建了提示的框架,帮助AI理解整体场景。
- 用户输入: 这是直接的部分——用户的直接请求或问题,构成了提示的核心。
- 输出指示器: 此方面可能较为棘手。它涉及指定AI响应的期望格式,如JSON。但请注意,AI并不总是严格遵守此格式。例如,它可能会在实际的JSON数据前添加诸如“这是您的JSON”之类的短语,或者有时生成并非完全准确的类JSON结构。
向AI提供预期的问答格式示例在构建提示时非常有益。 这种做法有助于AI“理解”查询的结构和意图,从而产生更精确和相关的响应。 虽然本文档没有深入探讨这些技术,但它们为进一步探索AI提示工程领域提供了一个起点。
以下是进一步研究的资源列表。
简单技巧
- 文本摘要:
将大量文本简化为精炼的摘要,提炼关键要点和主要思想,省略不那么重要的细节。 - 问题回答:
专注于从给定文本中根据用户提出的问题推导出具体答案。这是关于针对查询精确定位并提取相关信息的过程。 - 文本分类:
根据内容对文本进行系统分类,将其归入最合适的预定义类别或组别中。 - 对话:
创建互动对话,使AI能与用户进行来回交流,模拟自然的对话流程。 - 代码生成:
根据特定的用户需求或描述生成功能代码片段,将自然语言指令转化为可执行代码。
高级技术
- 零样本, 少样本学习:
使模型能够仅凭最少甚至不需要特定问题类型的先验示例,就能做出准确的预测或响应,利用学到的一般性知识理解和应对新任务。 - 思考链:
将多次AI响应链接起来,创造出连贯且上下文感知的对话。它帮助AI维持讨论的线索,确保相关性和连贯性。 - ReAct(推理 + 行动):
在此方法中,AI首先分析(对输入进行推理),然后确定最合适的行动方案或响应。它将理解与决策相结合。
Microsoft 指导原则
- 提示创建与优化框架:
微软提供了一种结构化的方法来开发和细化提示。此框架指导用户创建有效的提示,以从AI模型中获得期望的响应,优化交互的清晰度和效率。
token
Tokens在AI模型处理文本的方式中至关重要,它们充当桥梁,将我们理解的词汇转换为AI模型可以处理的格式。 这一转换过程分为两个阶段:输入时,词汇被转换为Tokens;输出时,这些Tokens再被转换回词汇。
分词,即将文本拆分为词语的过程,是AI模型理解和处理语言的基础。 AI模型借助这种分词格式来理解并响应提示。
为了更好地理解Tokens(tokens),可以将它们视为单词的部分。通常,一个Tokens大约代表了一个单词的四分之三。例如,莎士比亚的全部作品,总共有大约90万字,转换成Tokens后将约为120万个。
试验 OpenAI分词器UI ,了解单词是如何转换为分词的。
Tokens在AI处理中的技术角色之外还有实际意义,特别是在计费和模型能力方面:
- 计费:AI模型服务通常根据Tokens使用量进行计费。输入(提示)和输出(响应)都会计入总的Tokens数量,因此更简短的提示在成本效益上更为划算。
- 模型限制:不同的AI模型具有不同的Tokens限制,这些限制定义了它们的“上下文窗口”——即它们一次能处理的最大信息量。例如,GPT-3的限制是4千个Tokens,而其他模型如Claude 2和Meta Llama 2的限制为10万个Tokens,一些研究型模型甚至能处理多达100万个Tokens。
- 上下文窗口:模型的Tokens限制决定了其上下文窗口的大小。超过此限制的输入将不会被模型处理。因此,只发送最有效的、必要的信息集进行处理至关重要。例如,在询问关于“哈姆雷特”的信息时,无需包含莎士比亚其他所有作品的Tokens。
- 响应元数据:来自AI模型的响应元数据包括使用的Tokens数量,这是管理使用量和成本的重要信息。
结构化输出
结构化输出转换器
LLM生成结构化输出的能力对于依赖于可靠解析输出值的下游应用至关重要。 开发者希望快速将AI模型的结果转换为JSON、XML或Java类等数据类型,以便能够传递给其他应用程序函数和方法。
Spring AI Structured Output Converters 助力将LLM输出转换为结构化格式。 如下图所示,此方法围绕LLM文本补全端点运作:
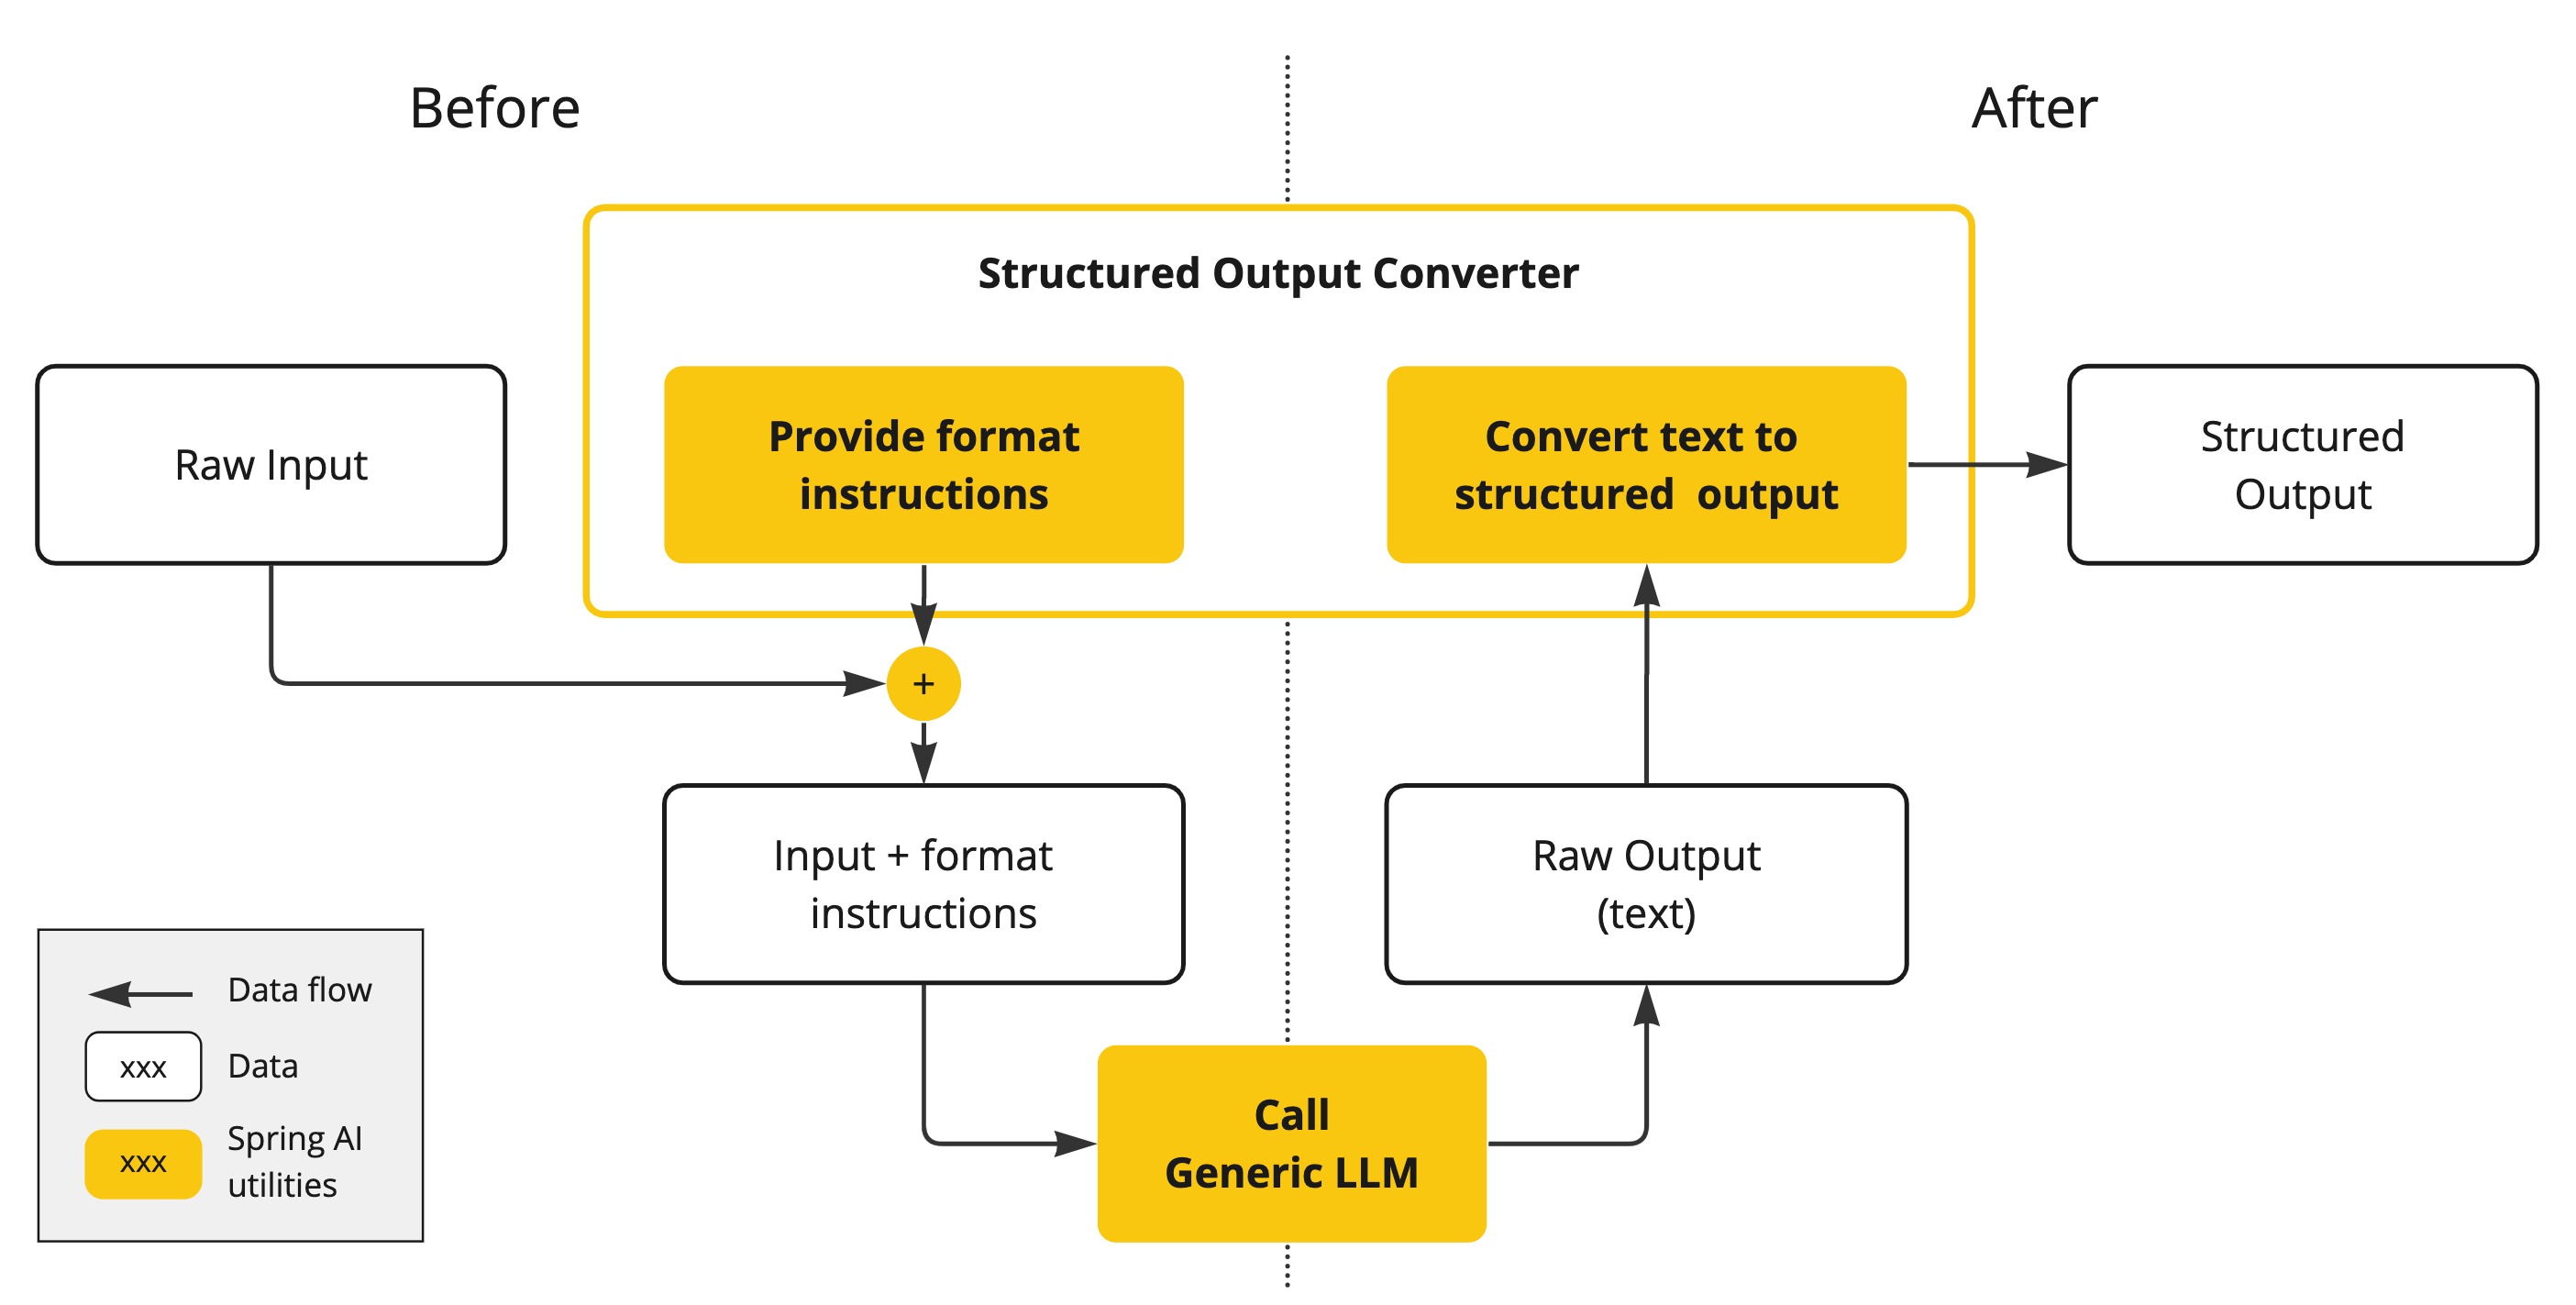
从大型语言模型(LLMs)通过通用完成API生成结构化输出需要对输入和输出进行仔细处理。结构化输出转换器在LLM调用前后扮演着关键角色,确保达到期望的输出结构。
在LLM调用之前,转换器会向提示中追加格式指令,为模型提供明确的指导以生成期望的输出结构。这些指令充当蓝图,塑造模型的响应,使其符合指定的格式。
随着更多AI模型原生支持结构化输出,您可以利用 AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT 中的 原生结构化输出 功能来发挥这一优势。这种方法直接使用生成的JSON模式与模型的原生结构化输出API配合,省去了预提示格式化指令的需要,并提供了更可靠的结果。 |
|---|
LLM调用后,转换器将模型的输出文本转化为结构化类型的实例。此转化过程包括解析原始文本输出,并将其映射到相应的结构化数据表示形式,如JSON、XML或领域特定的数据结构。
数字 StructuredOutputConverter 表示尽最大努力将模型输出转换为结构化输出。 AI模型不保证按请求返回结构化输出。 模型可能无法理解提示或无法按请求生成结构化输出。 请考虑实现验证机制以确保模型输出符合预期。 |
|---|
数字 StructuredOutputConverter 未用于LLM 工具调用 ,因为此功能默认内置提供结构化输出。 |
|---|
结构化输出API
StructuredOutputConverter 接口使您能够获取结构化输出,例如将输出映射到Java类或从基于文本的AI模型输出中提取的值数组。 接口定义为:
java
public interface StructuredOutputConverter<T> extends Converter<String, T>, FormatProvider {

}
它结合了Spring的 Converter<String, T> 接口和 FormatProvider 接口
java
public interface FormatProvider {
    String getFormat();
}
下图展示了使用结构化输出API时的数据流。
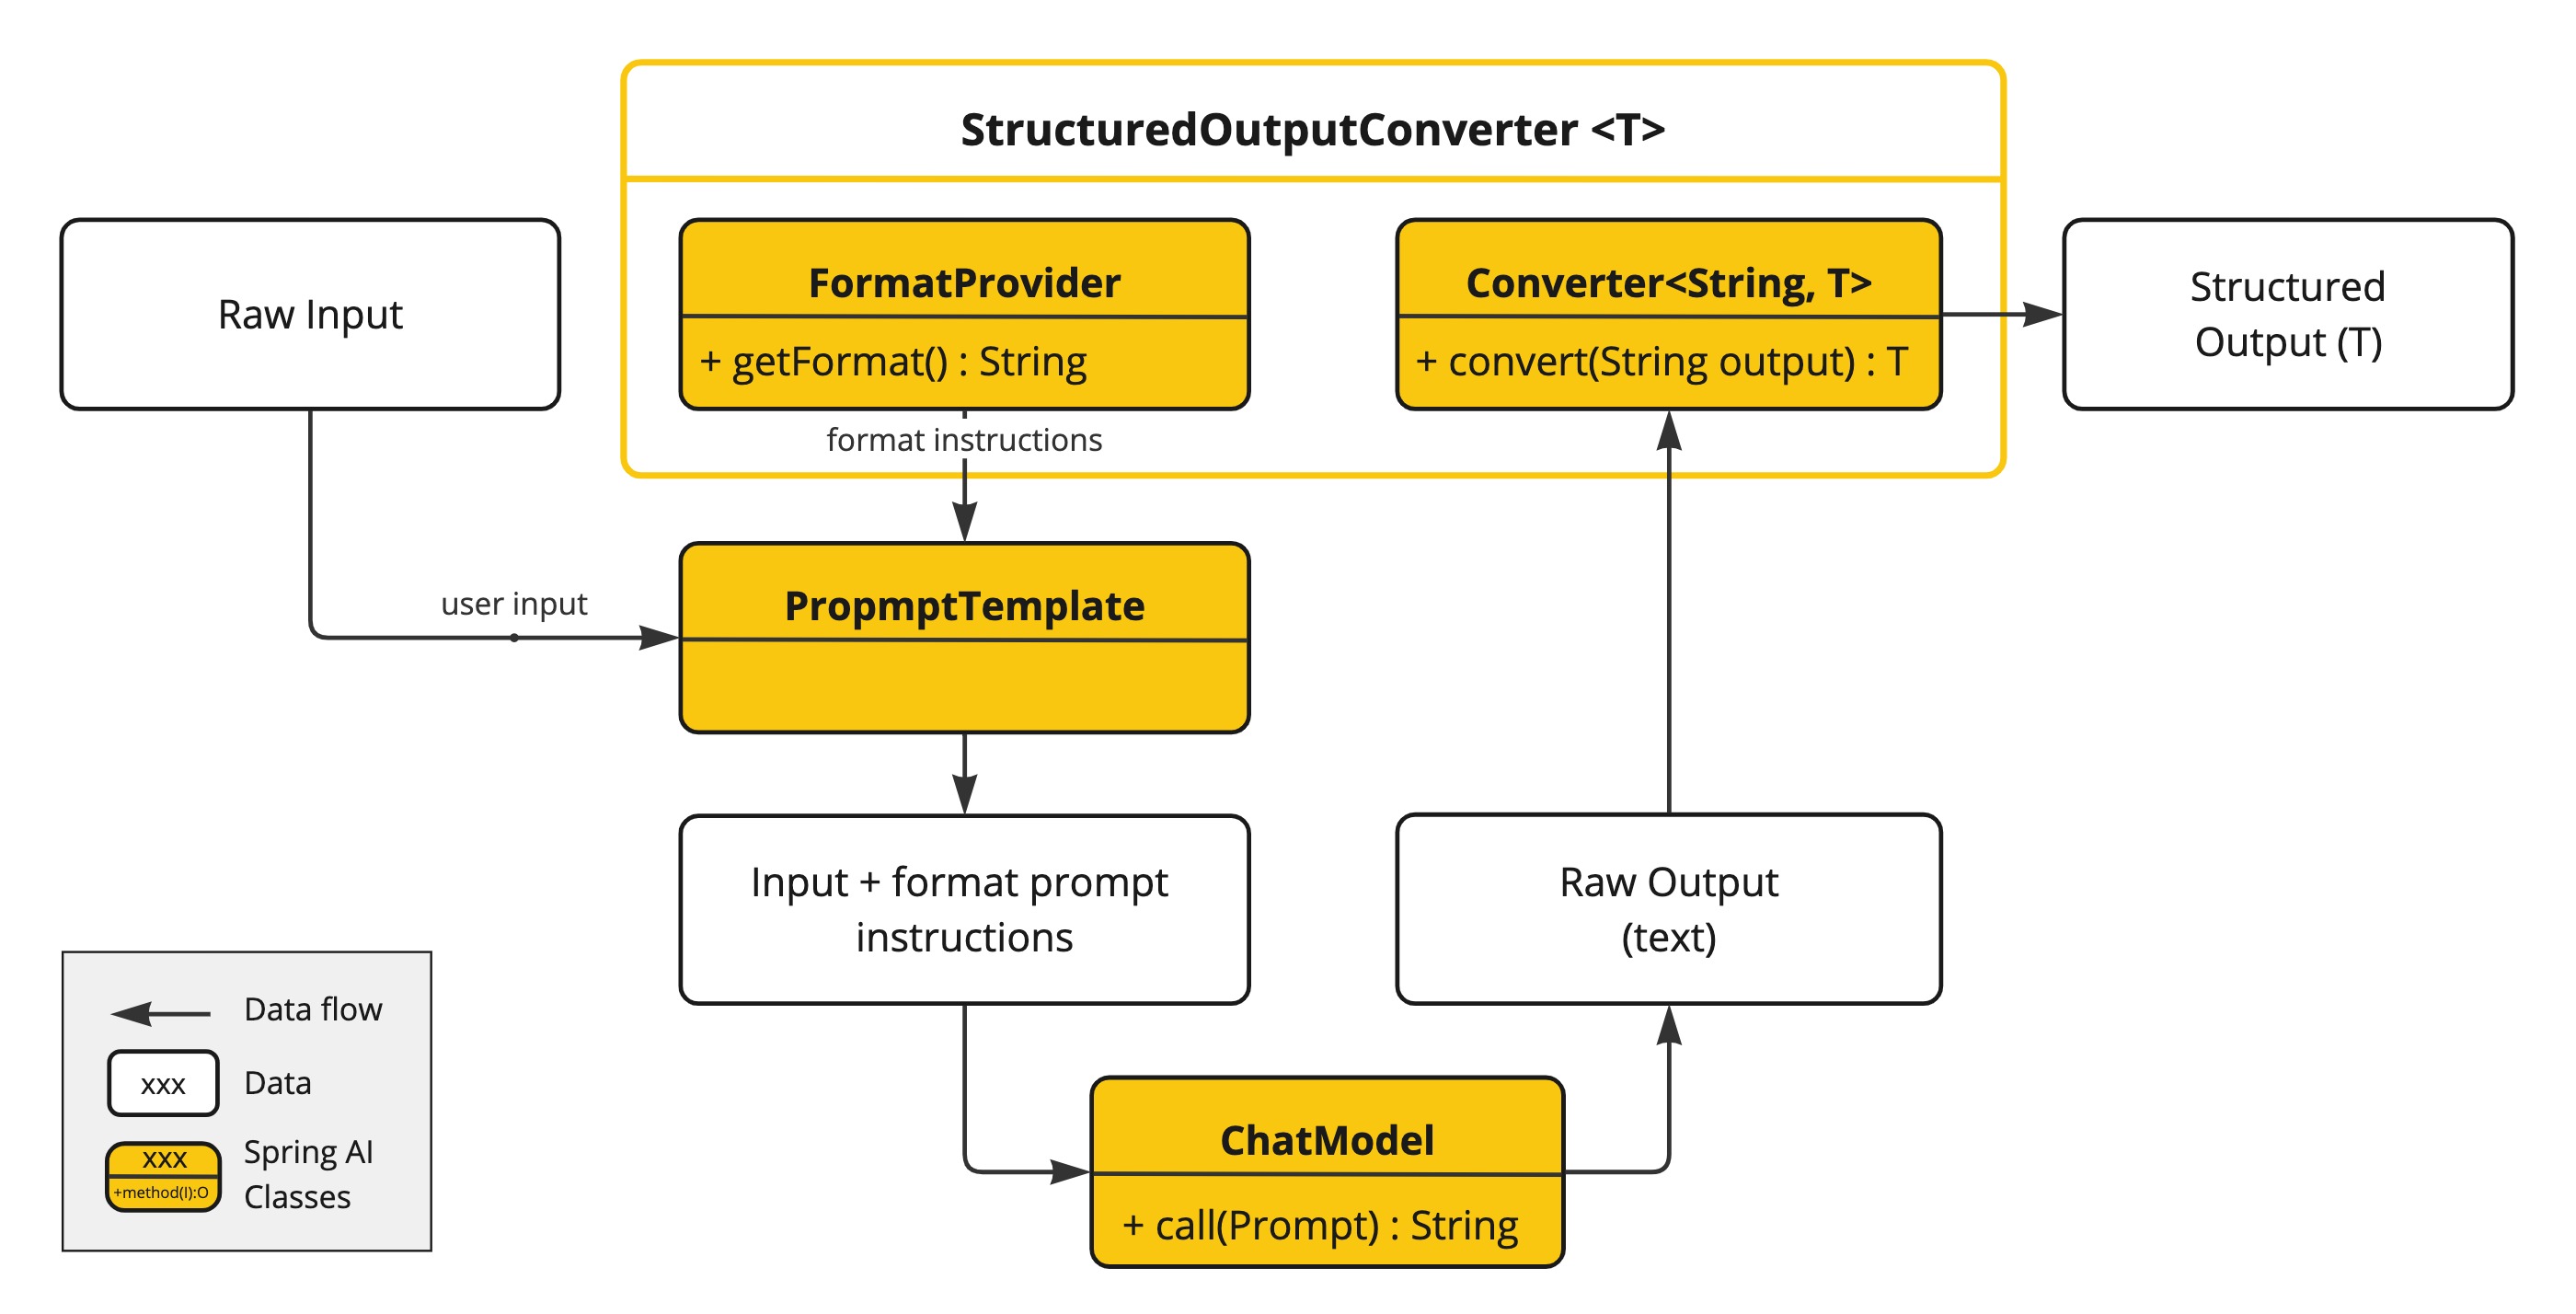
数字 FormatProvider 为AI模型提供了特定的格式化指南,使其生成的文本输出能够通过 Converter 转换为指定的目标类型 T 。以下是一个此类格式化指令的例子:
Your response should be in JSON format.
The data structure for the JSON should match this Java class: java.util.HashMap
Do not include any explanations, only provide a RFC8259 compliant JSON response following this format without deviation.
格式说明通常使用 PromptTemplate 类附加在用户输入的末尾,例如这样:
java
StructuredOutputConverter outputConverter = ...
String userInputTemplate = """
    ... user text input ....
    {format}
    """; // user input with a "format" placeholder.
Prompt prompt = new Prompt(
        PromptTemplate.builder()
                    .template(this.userInputTemplate)
                    .variables(Map.of(..., "format", this.outputConverter.getFormat())) // replace the "format" placeholder with the converter's format.
                    .build().createMessage()
);
转换器<String, T>负责将模型中的输出文本转换为指定类型 T 的实例。
可用转换器
目前,Spring AI提供了 AbstractConversionServiceOutputConverter, AbstractMessageOutputConverter, BeanOutputConverter, MapOutputConverter 和 ListOutputConverter 种实现方式:
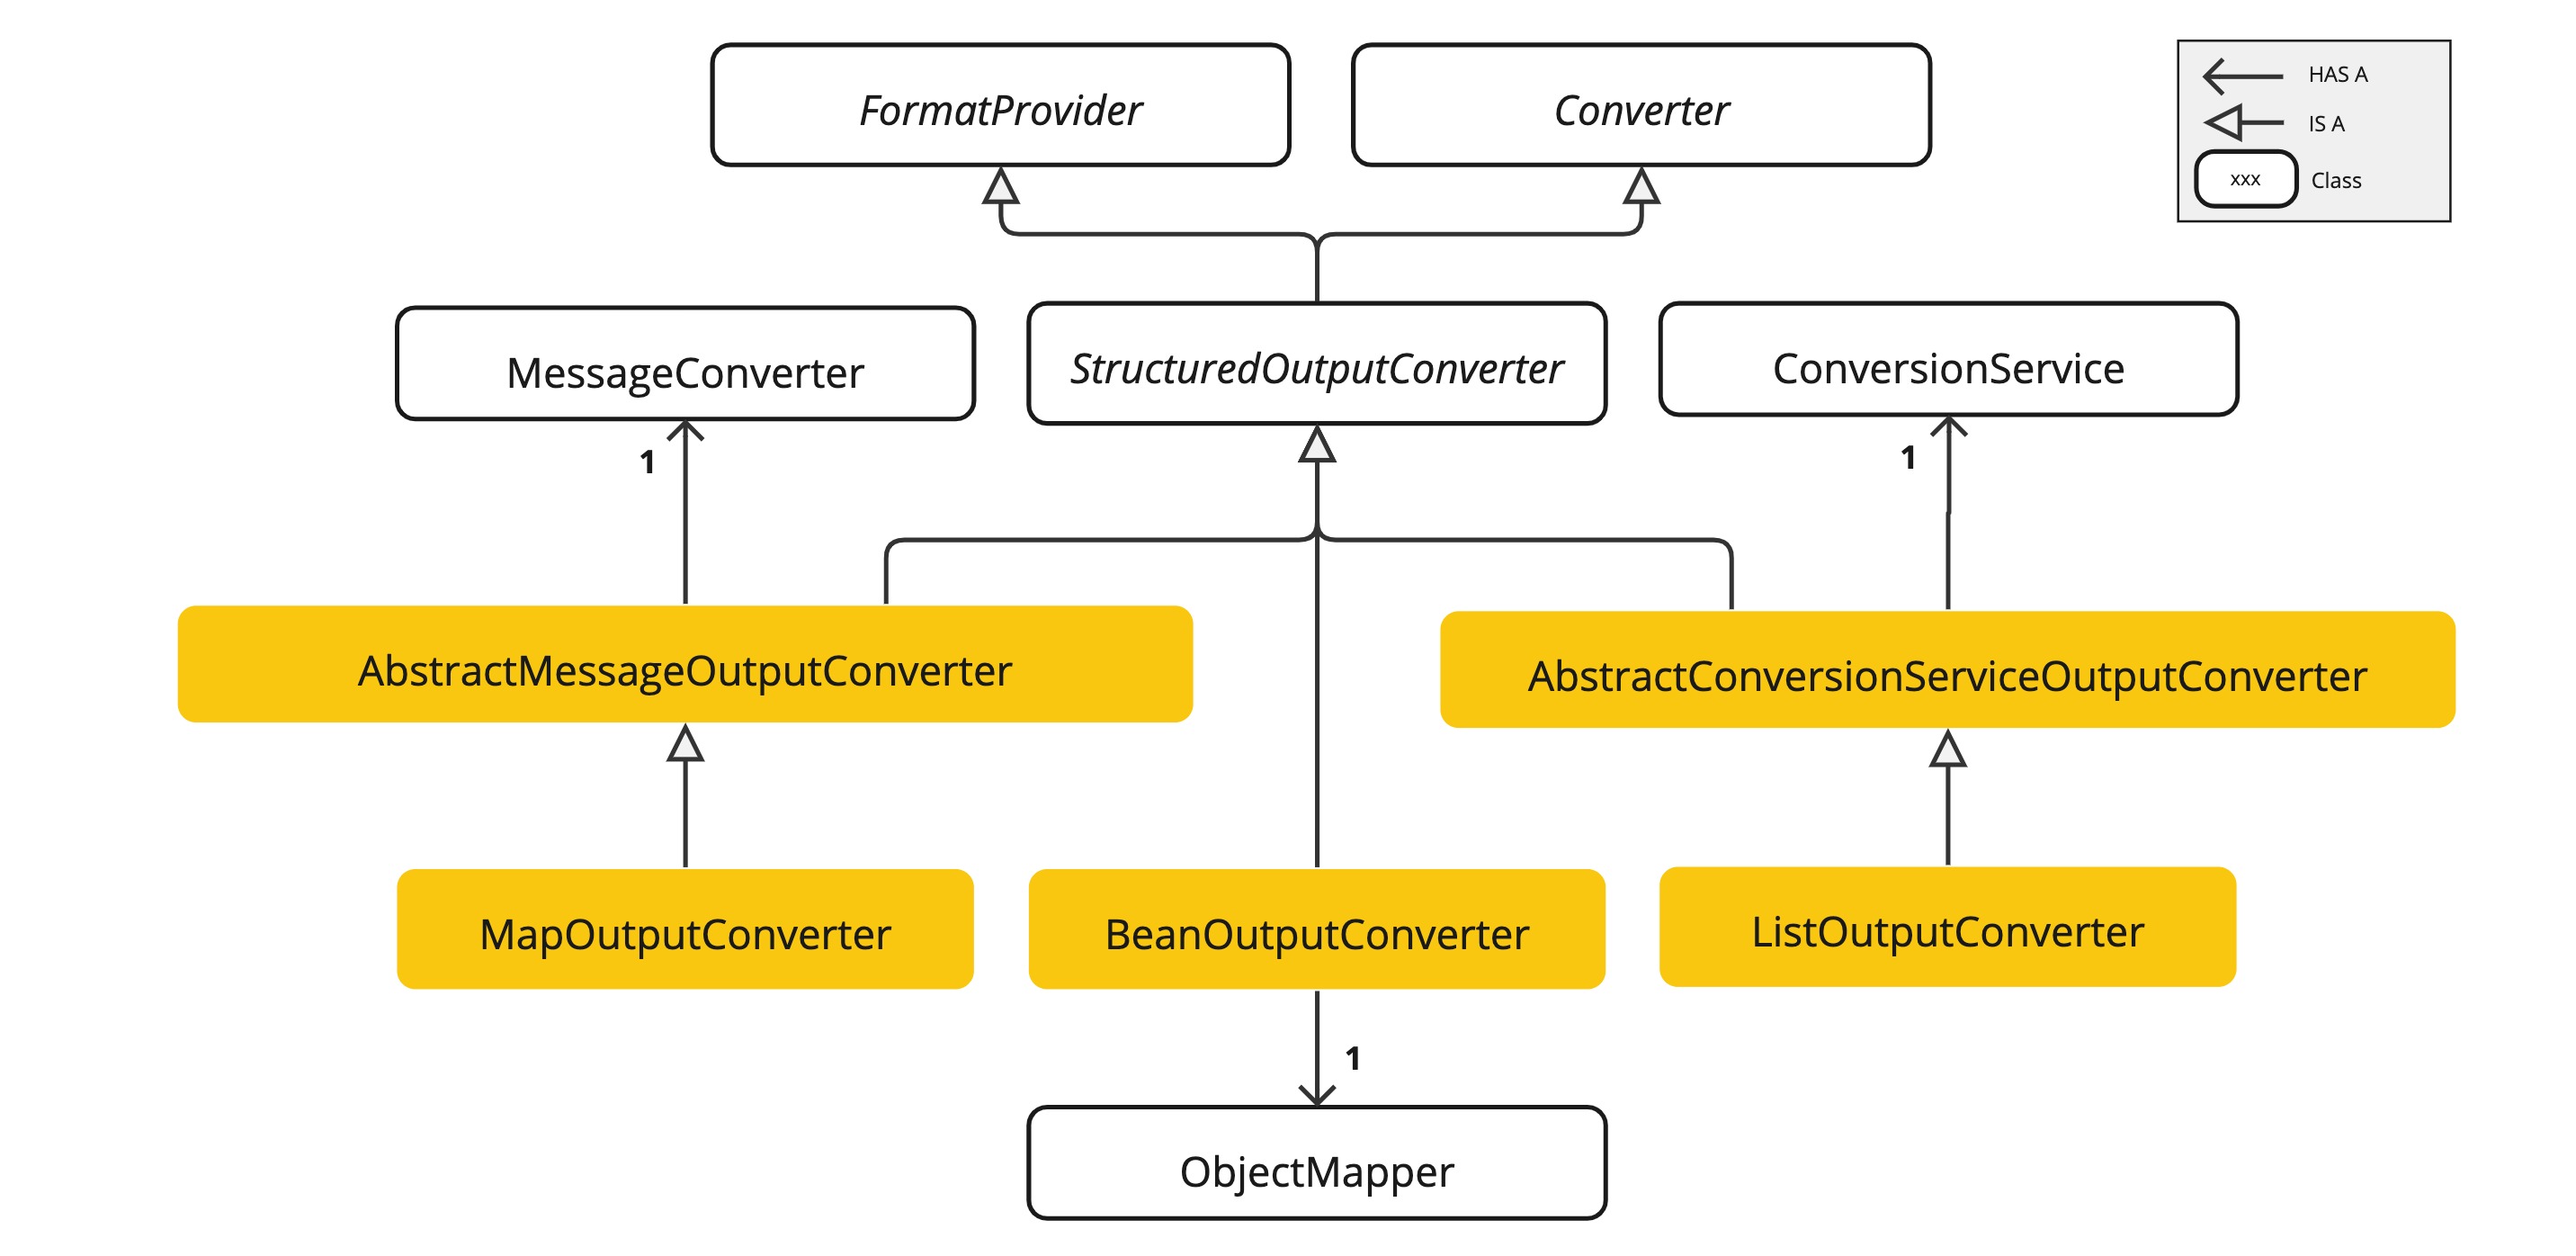
AbstractConversionServiceOutputConverter<T>- 提供了一个预配置的 通用转换服务 ,用于将LLM输出转换为所需格式。没有提供默认的FormatProvider实现。AbstractMessageOutputConverter<T>- 提供了一个预配置的 消息转换器 ,用于将LLM输出转换为所需格式。没有提供默认的FormatProvider实现。BeanOutputConverter<T>- 通过指定的Java类(例如,Bean)或 参数化类型参考 进行配置,此转换器使用FormatProvider实现,该实现指导AI模型生成遵循DRAFT_2020_12、从指定Java类派生的JSON Schema的JSON响应。随后,它使用ObjectMapper将JSON输出反序列化为目标类的Java对象实例。MapOutputConverter- 扩展了AbstractMessageOutputConverter的功能,采用FormatProvider实现方式,引导AI模型生成符合RFC8259标准的JSON响应。此外,它还包含了一个转换器实现,该实现利用提供的MessageConverter将JSON负载转换为java.util.Map<String, Object>实例。ListOutputConverter- 扩展了AbstractConversionServiceOutputConverter并包含了一个针对逗号分隔列表输出量身定制的FormatProvider实现。转换器实现利用提供的ConversionService将模型文本输出转换为java.util.List。
使用转换器
以下各章节提供了如何使用可用的转换器生成结构化输出的指南。
Bean 输出转换器
以下示例展示了如何使用 BeanOutputConverter 来生成演员的电影作品列表。
表示演员影视作品的目标记录:
java
record ActorsFilms(String actor, List<String> movies) {
}
如何使用高级流畅的 ChatClient API 应用 BeanOutputConverter:
java
ActorsFilms actorsFilms = ChatClient.create(chatModel).prompt()
        .user(u -> u.text("Generate the filmography of 5 movies for {actor}.")
                    .param("actor", "Tom Hanks"))
        .call()
        .entity(ActorsFilms.class);
或使用低级别的 ChatModel API 直接进行操作:
java
BeanOutputConverter<ActorsFilms> beanOutputConverter =
    new BeanOutputConverter<>(ActorsFilms.class);

String format = this.beanOutputConverter.getFormat();

String actor = "Tom Hanks";

String template = """
        Generate the filmography of 5 movies for {actor}.
        {format}
        """;

Generation generation = chatModel.call(
    PromptTemplate.builder().template(this.template).variables(Map.of("actor", this.actor, "format", this.format)).build().create()).getResult();

ActorsFilms actorsFilms = this.beanOutputConverter.convert(this.generation.getOutput().getText());
生成架构中的属性排序
在生成的JSON模式中, BeanOutputConverter 支持通过 @JsonPropertyOrder 注解来自定义属性排序。 此注解使您能够指定属性在架构中出现的确切顺序,而不受其在类或记录中的声明顺序影响。
例如,要确保在 ActorsFilms 记录中属性的特定排序:
java
@JsonPropertyOrder({"actor", "movies"})
record ActorsFilms(String actor, List<String> movies) {}
此注解适用于记录(records)和常规Java类。
通用Bean类型
使用 ParameterizedTypeReference 构造函数来指定更复杂的目标类结构。 例如,要表示演员列表及其影视作品集:
java
List<ActorsFilms> actorsFilms = ChatClient.create(chatModel).prompt()
        .user("Generate the filmography of 5 movies for Tom Hanks and Bill Murray.")
        .call()
        .entity(new ParameterizedTypeReference<List<ActorsFilms>>() {});
或使用低级别的 ChatModel API 直接进行操作:
java
BeanOutputConverter<List<ActorsFilms>> outputConverter = new BeanOutputConverter<>(
        new ParameterizedTypeReference<List<ActorsFilms>>() { });

String format = this.outputConverter.getFormat();
String template = """
        Generate the filmography of 5 movies for Tom Hanks and Bill Murray.
        {format}
        """;

Prompt prompt = PromptTemplate.builder().template(this.template).variables(Map.of("format", this.format)).build().create();

Generation generation = chatModel.call(this.prompt).getResult();

List<ActorsFilms> actorsFilms = this.outputConverter.convert(this.generation.getOutput().getText());
Map 输出转换器
以下代码片段展示了如何使用 MapOutputConverter 将模型输出转换为映射中的数字列表。
java
Map<String, Object> result = ChatClient.create(chatModel).prompt()
        .user(u -> u.text("Provide me a List of {subject}")
                    .param("subject", "an array of numbers from 1 to 9 under they key name 'numbers'"))
        .call()
        .entity(new ParameterizedTypeReference<Map<String, Object>>() {});
或使用低级别的 ChatModel API 直接进行操作:
java
MapOutputConverter mapOutputConverter = new MapOutputConverter();

String format = this.mapOutputConverter.getFormat();
String template = """
        Provide me a List of {subject}
        {format}
        """;

Prompt prompt = PromptTemplate.builder().template(this.template)
.variables(Map.of("subject", "an array of numbers from 1 to 9 under they key name 'numbers'", "format", this.format)).build().create();

Generation generation = chatModel.call(this.prompt).getResult();

Map<String, Object> result = this.mapOutputConverter.convert(this.generation.getOutput().getText());
列表输出转换器
以下代码片段展示了如何使用 ListOutputConverter 将模型输出转换为冰淇淋口味的列表。
java
List<String> flavors = ChatClient.create(chatModel).prompt()
                .user(u -> u.text("List five {subject}")
                            .param("subject", "ice cream flavors"))
                .call()
                .entity(new ListOutputConverter(new DefaultConversionService()));
或者直接使用低级别的 ChatModel API:
java
ListOutputConverter listOutputConverter = new ListOutputConverter(new DefaultConversionService());

String format = this.listOutputConverter.getFormat();
String template = """
        List five {subject}
        {format}
        """;

Prompt prompt = PromptTemplate.builder().template(this.template).variables(Map.of("subject", "ice cream flavors", "format", this.format)).build().create();

Generation generation = this.chatModel.call(this.prompt).getResult();

List<String> list = this.listOutputConverter.convert(this.generation.getOutput().getText());
原生结构化输出
许多现代AI模型现原生支持结构化输出,与基于提示的格式化相比,这提供了更可靠的结果。Spring AI通过 原生结构化输出 功能支持这一特性。
在使用原生结构化输出时,由 BeanOutputConverter 生成的JSON模式直接发送到模型的结构化输出API,从而省去了在提示中需要格式指令的步骤。这种方法提供了:
- 更高可靠性: 该模型确保输出符合架构规范
- 清理提示: 无需附加格式说明
- 更佳的性能: 模型可内部优化结构化输出
使用原生结构化输出
要启用原生结构化输出,请使用参数 AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT:
java
ActorsFilms actorsFilms = ChatClient.create(chatModel).prompt()
    .advisors(AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT)
    .user("Generate the filmography for a random actor.")
    .call()
    .entity(ActorsFilms.class);
您也可以使用 defaultAdvisors() 全局设置 ChatClient.Builder :
java
@Bean
ChatClient chatClient(ChatClient.Builder builder) {
    return builder
        .defaultAdvisors(AdvisorParams.ENABLE_NATIVE_STRUCTURED_OUTPUT)
        .build();
}
支持的原生结构化输出模型
以下模型目前支持原生结构化输出:
- OpenAI: GPT-4o及后续模型支持JSON Schema
- Anthropic: Claude 3.5 十四行诗及后续模型
- Vertex AI 双子座: 双子座 1.5 专业版及以后型号
- Mistral AI: Mistral 小型及以后型号支持JSON Schema
| 一些AI模型,如OpenAI,不直接支持在顶级层次使用对象数组。在这种情况下,您可以使用Spring AI的默认结构化输出转换(不使用原生结构化输出顾问)。 |
|---|
内置JSON模式
一些AI模型提供了专门的配置选项,以生成结构化(通常是JSON)输出。
- OpenAI 结构化输出 能确保您的模型生成严格遵循所提供JSON Schema的响应。您可以在以下选项中选择:使用
JSON_OBJECT保证模型生成的有效JSON消息,或者使用JSON_SCHEMA并提供一个模式,以保证模型生成的响应与您提供的模式匹配(还有spring.ai.openai.chat.options.responseFormat选项)。 - Azure OpenAI - 提供了一个
spring.ai.azure.openai.chat.options.responseFormat选项,用于指定模型必须输出的格式。设置为{ "type": "json_object" }启用JSON模式,确保模型生成的消息是有效的JSON格式。 - Ollama - 提供了一个
spring.ai.ollama.chat.options.format选项来指定返回响应的格式。当前,唯一接受的值是json。 - Mistral AI - 提供了一个
spring.ai.mistralai.chat.options.responseFormat选项来指定返回响应的格式。将其设置为{ "type": "json_object" }启用JSON模式,确保模型生成的消息是有效的JSON。此外,将其与提供的架构一起设置为{ "type": "json_schema" }启用了原生结构化输出支持,保证模型生成的响应与您提供的架构相匹配。
多模态API
"All things that are naturally connected ought to be taught in combination" - John Amos Comenius, "Orbis Sensualium Pictus", 1658
人类处理知识的方式,是同时通过多种数据输入模式进行的。 我们的学习方式、我们的体验都是多模态的。 我们不仅仅依赖视觉、听觉或文本。
与这些原则相悖的是,机器学习常常侧重于针对处理单一模态的专用模型。 例如,我们为诸如文本转语音或语音转文本的任务开发了音频模型,以及为对象检测和分类等任务开发了计算机视觉模型。
然而,新的一波多模态大型语言模型开始涌现。其中包括OpenAI的GPT-4o、Google的Vertex AI Gemini 1.5、Anthropic的Claude3,以及开源产品Llama3.2、LLaVA和BakLLaVA,这些模型能够接受多种输入形式,包括文本、图像、音频和视频,并通过整合这些输入来生成文本回应。
| 多模态大型语言模型(LLM)功能使模型能够结合图像、音频或视频等其他模态处理和生成文本。 |
|---|
Spring AI 多模态
多模态是指模型同时理解和处理来自多种来源信息的能力,这些来源包括文本、图像、音频及其他数据格式。
Spring AI 消息 API 提供了支持多模态大型语言模型所需的所有抽象。
UserMessage的 content 字段主要用于文本输入,而可选的 media 字段允许添加一种或多种不同模态的内容,如图片、音频和视频。 MimeType 用于指定模态类型。 根据所使用的LLMs, Media 数据字段可以是作为 Resource 对象的原始媒体内容,或是指向内容的 URI 链接。
媒体字段目前仅适用于用户输入消息(例如, UserMessage )。对于系统消息,它没有意义。包含LLM响应的 AssistantMessage 只提供文本内容。要生成非文本媒体输出,您应使用专用的单一模态模型之一。 |
|---|
例如,我们可以将下图( multimodal.test.png )作为输入,要求LLM解释它所看到的内容。
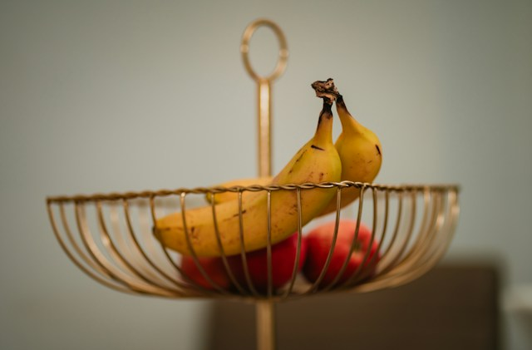
对于大多数多模态大型语言模型,Spring AI 的代码可能会看起来像这样:
java
var imageResource = new ClassPathResource("/multimodal.test.png");

var userMessage = UserMessage.builder()
    .text("Explain what do you see in this picture?") // content
    .media(new Media(MimeTypeUtils.IMAGE_PNG, this.imageResource)) // media
    .build();

ChatResponse response = chatModel.call(new Prompt(this.userMessage));
或使用流畅的 ChatClient API:
java
String response = ChatClient.create(chatModel).prompt()
        .user(u -> u.text("Explain what do you see on this picture?")
                    .media(MimeTypeUtils.IMAGE_PNG, new ClassPathResource("/multimodal.test.png")))
        .call()
        .content();
并生成如下的响应:
This is an image of a fruit bowl with a simple design. The bowl is made of metal with curved wire edges that create an open structure, allowing the fruit to be visible from all angles. Inside the bowl, there are two yellow bananas resting on top of what appears to be a red apple. The bananas are slightly overripe, as indicated by the brown spots on their peels. The bowl has a metal ring at the top, likely to serve as a handle for carrying. The bowl is placed on a flat surface with a neutral-colored background that provides a clear view of the fruit inside.
Spring AI 为以下聊天模型提供了多模态支持:
- Anthropic Claude 3
- AWS Bedrock Converse
- Azure Open AI(例如,GPT-4o模型)
- Mistral AI(例如,Mistral Pixtral模型)
- Ollama(例如 LLaVA、BakLLaVA、Llama3.2 模型)
- OpenAI(例如 GPT-4 和 GPT-4o 模型)
- Vertex AI 双子座(例如,gemini-1.5-pro-001、gemini-1.5-flash-001 模型)
Models
Spring AI API
简介
Spring AI API 涵盖了广泛的功能。每个主要特性都有其独立的专属章节进行详细说明。为了提供一个概览,以下为核心功能:
AI模型API
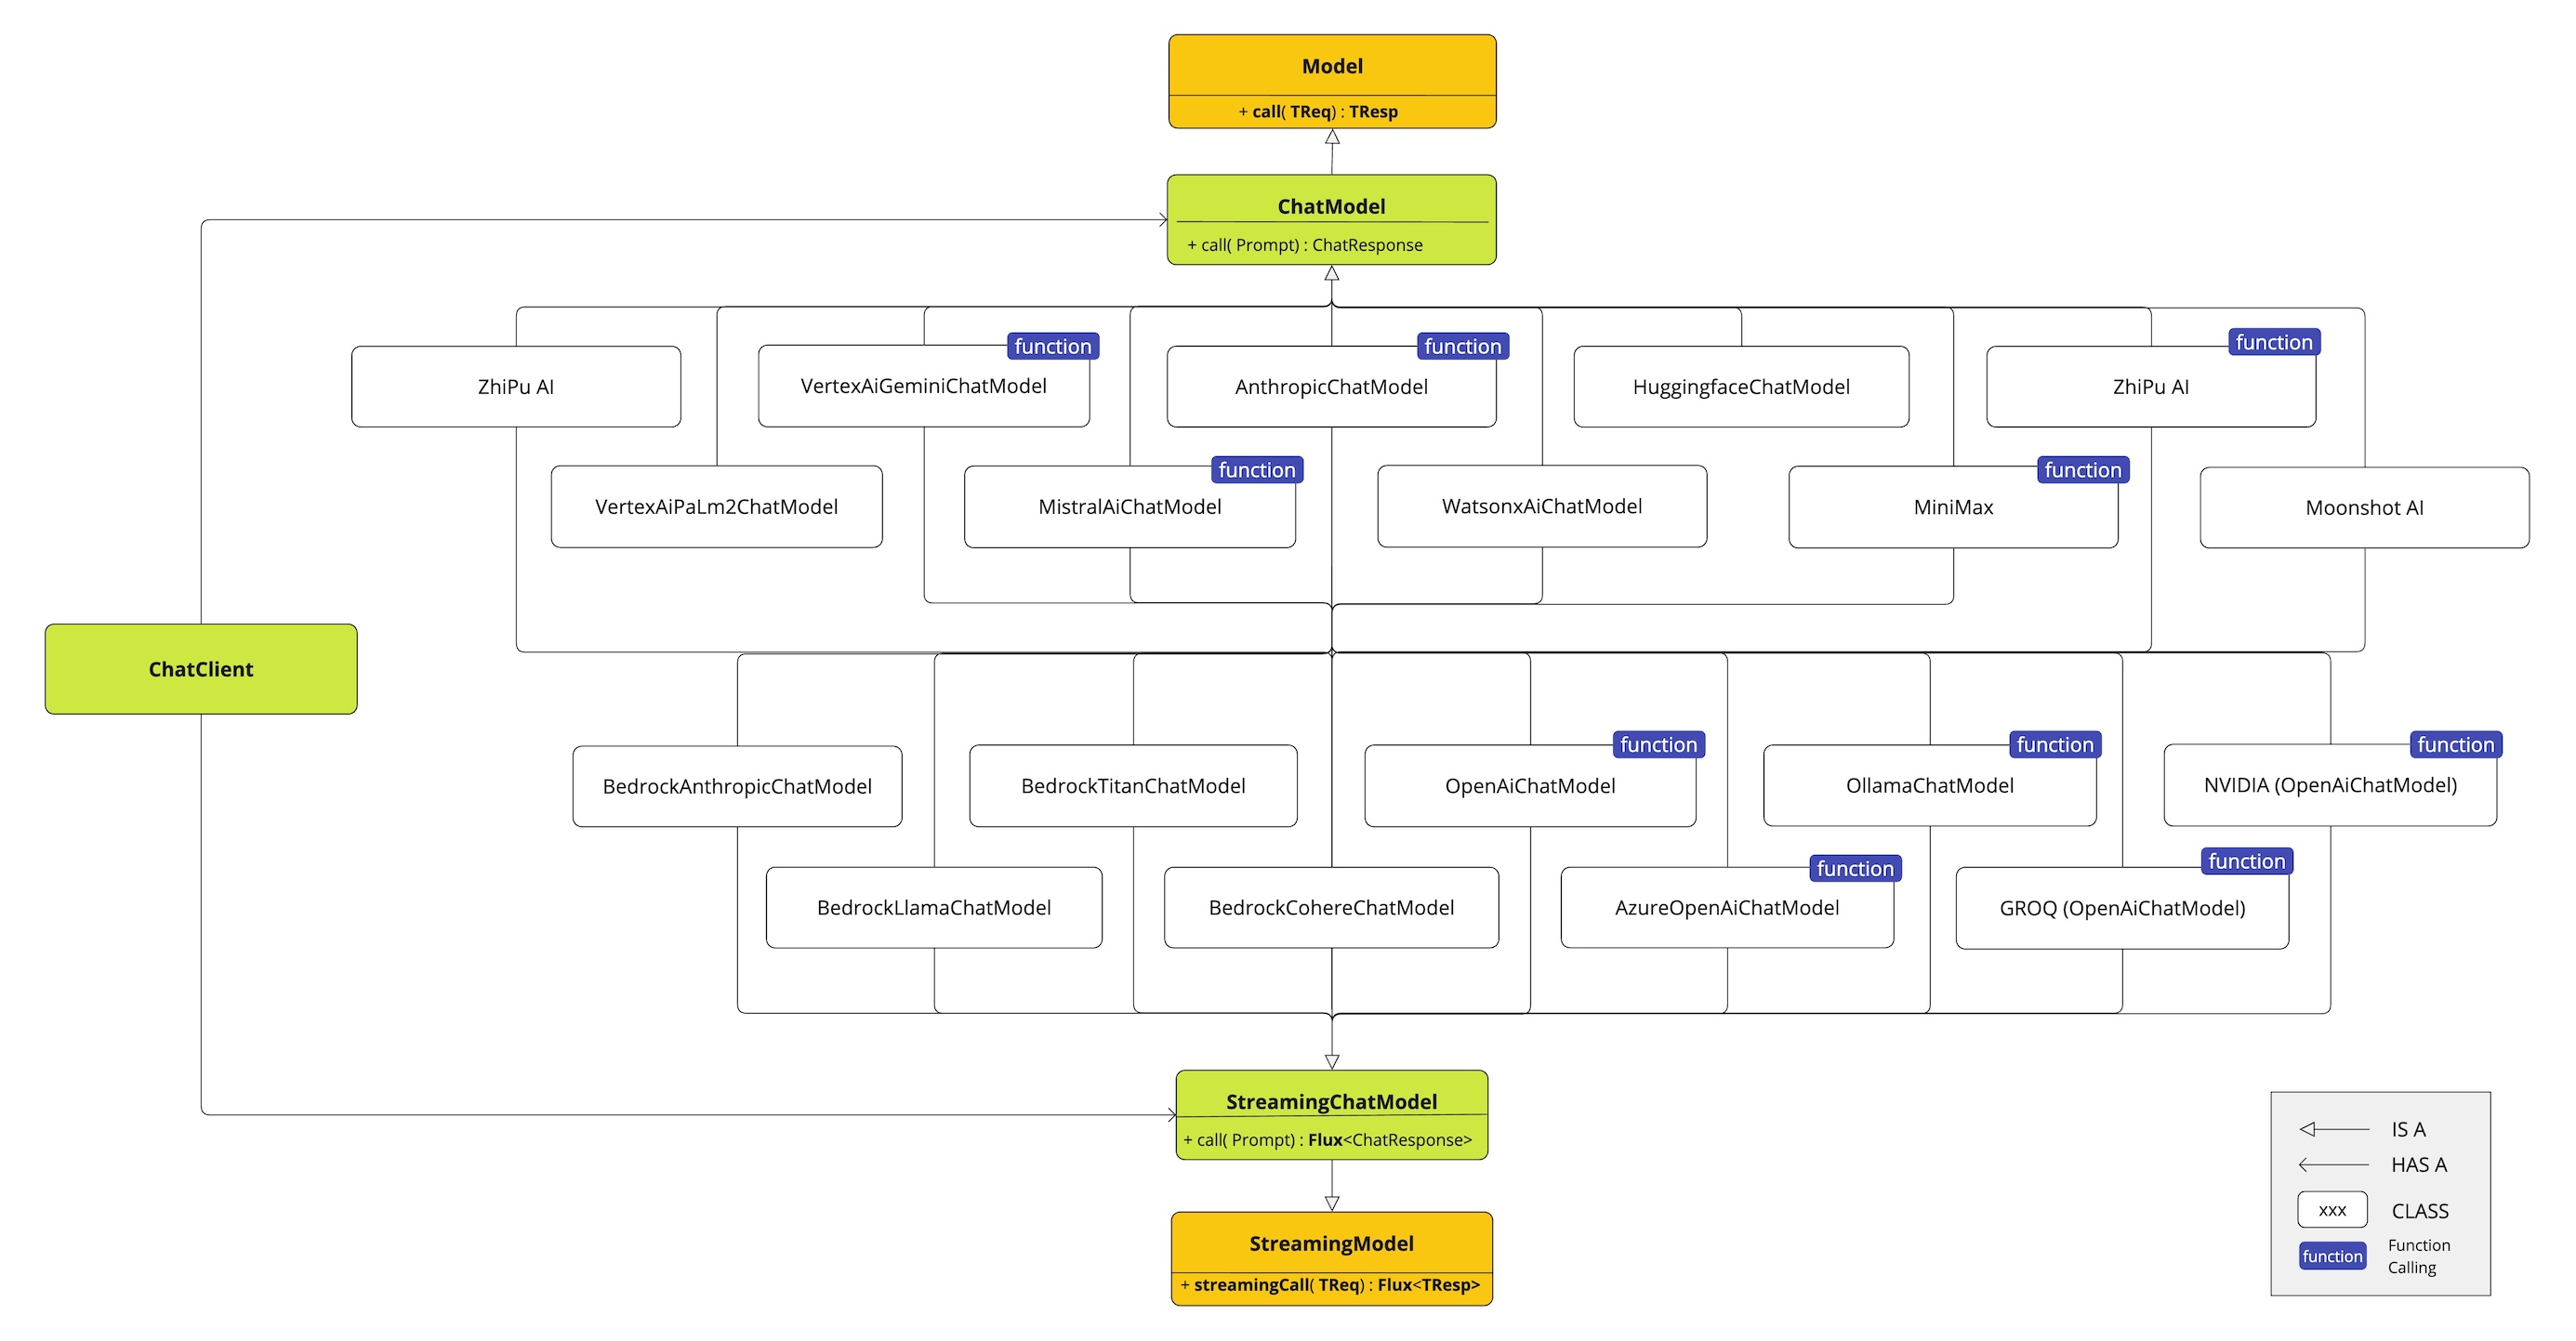
跨AI提供商为 Chat 、 Text to Image 、 Audio Transcription 、 Text to Speech 和 Embedding 模型提供便携式 Model API 。 同时支持 synchronous 和 stream API选项。 向下钻取以访问特定于模型的功能也受支持。

支持来自 OpenAI、Microsoft、Amazon、Google、Amazon Bedrock、Hugging Face 等的 AI 模型。
向量存储API
跨多个提供商可移植的 Vector Store API ,包括一个同样可移植的新型 SQL-like metadata filter API 。支持14个向量数据库可用。
调用API工具
Spring AI 让AI模型轻松调用您的服务,作为带有 @0 注解的方法或POJO java.util.Function 对象。
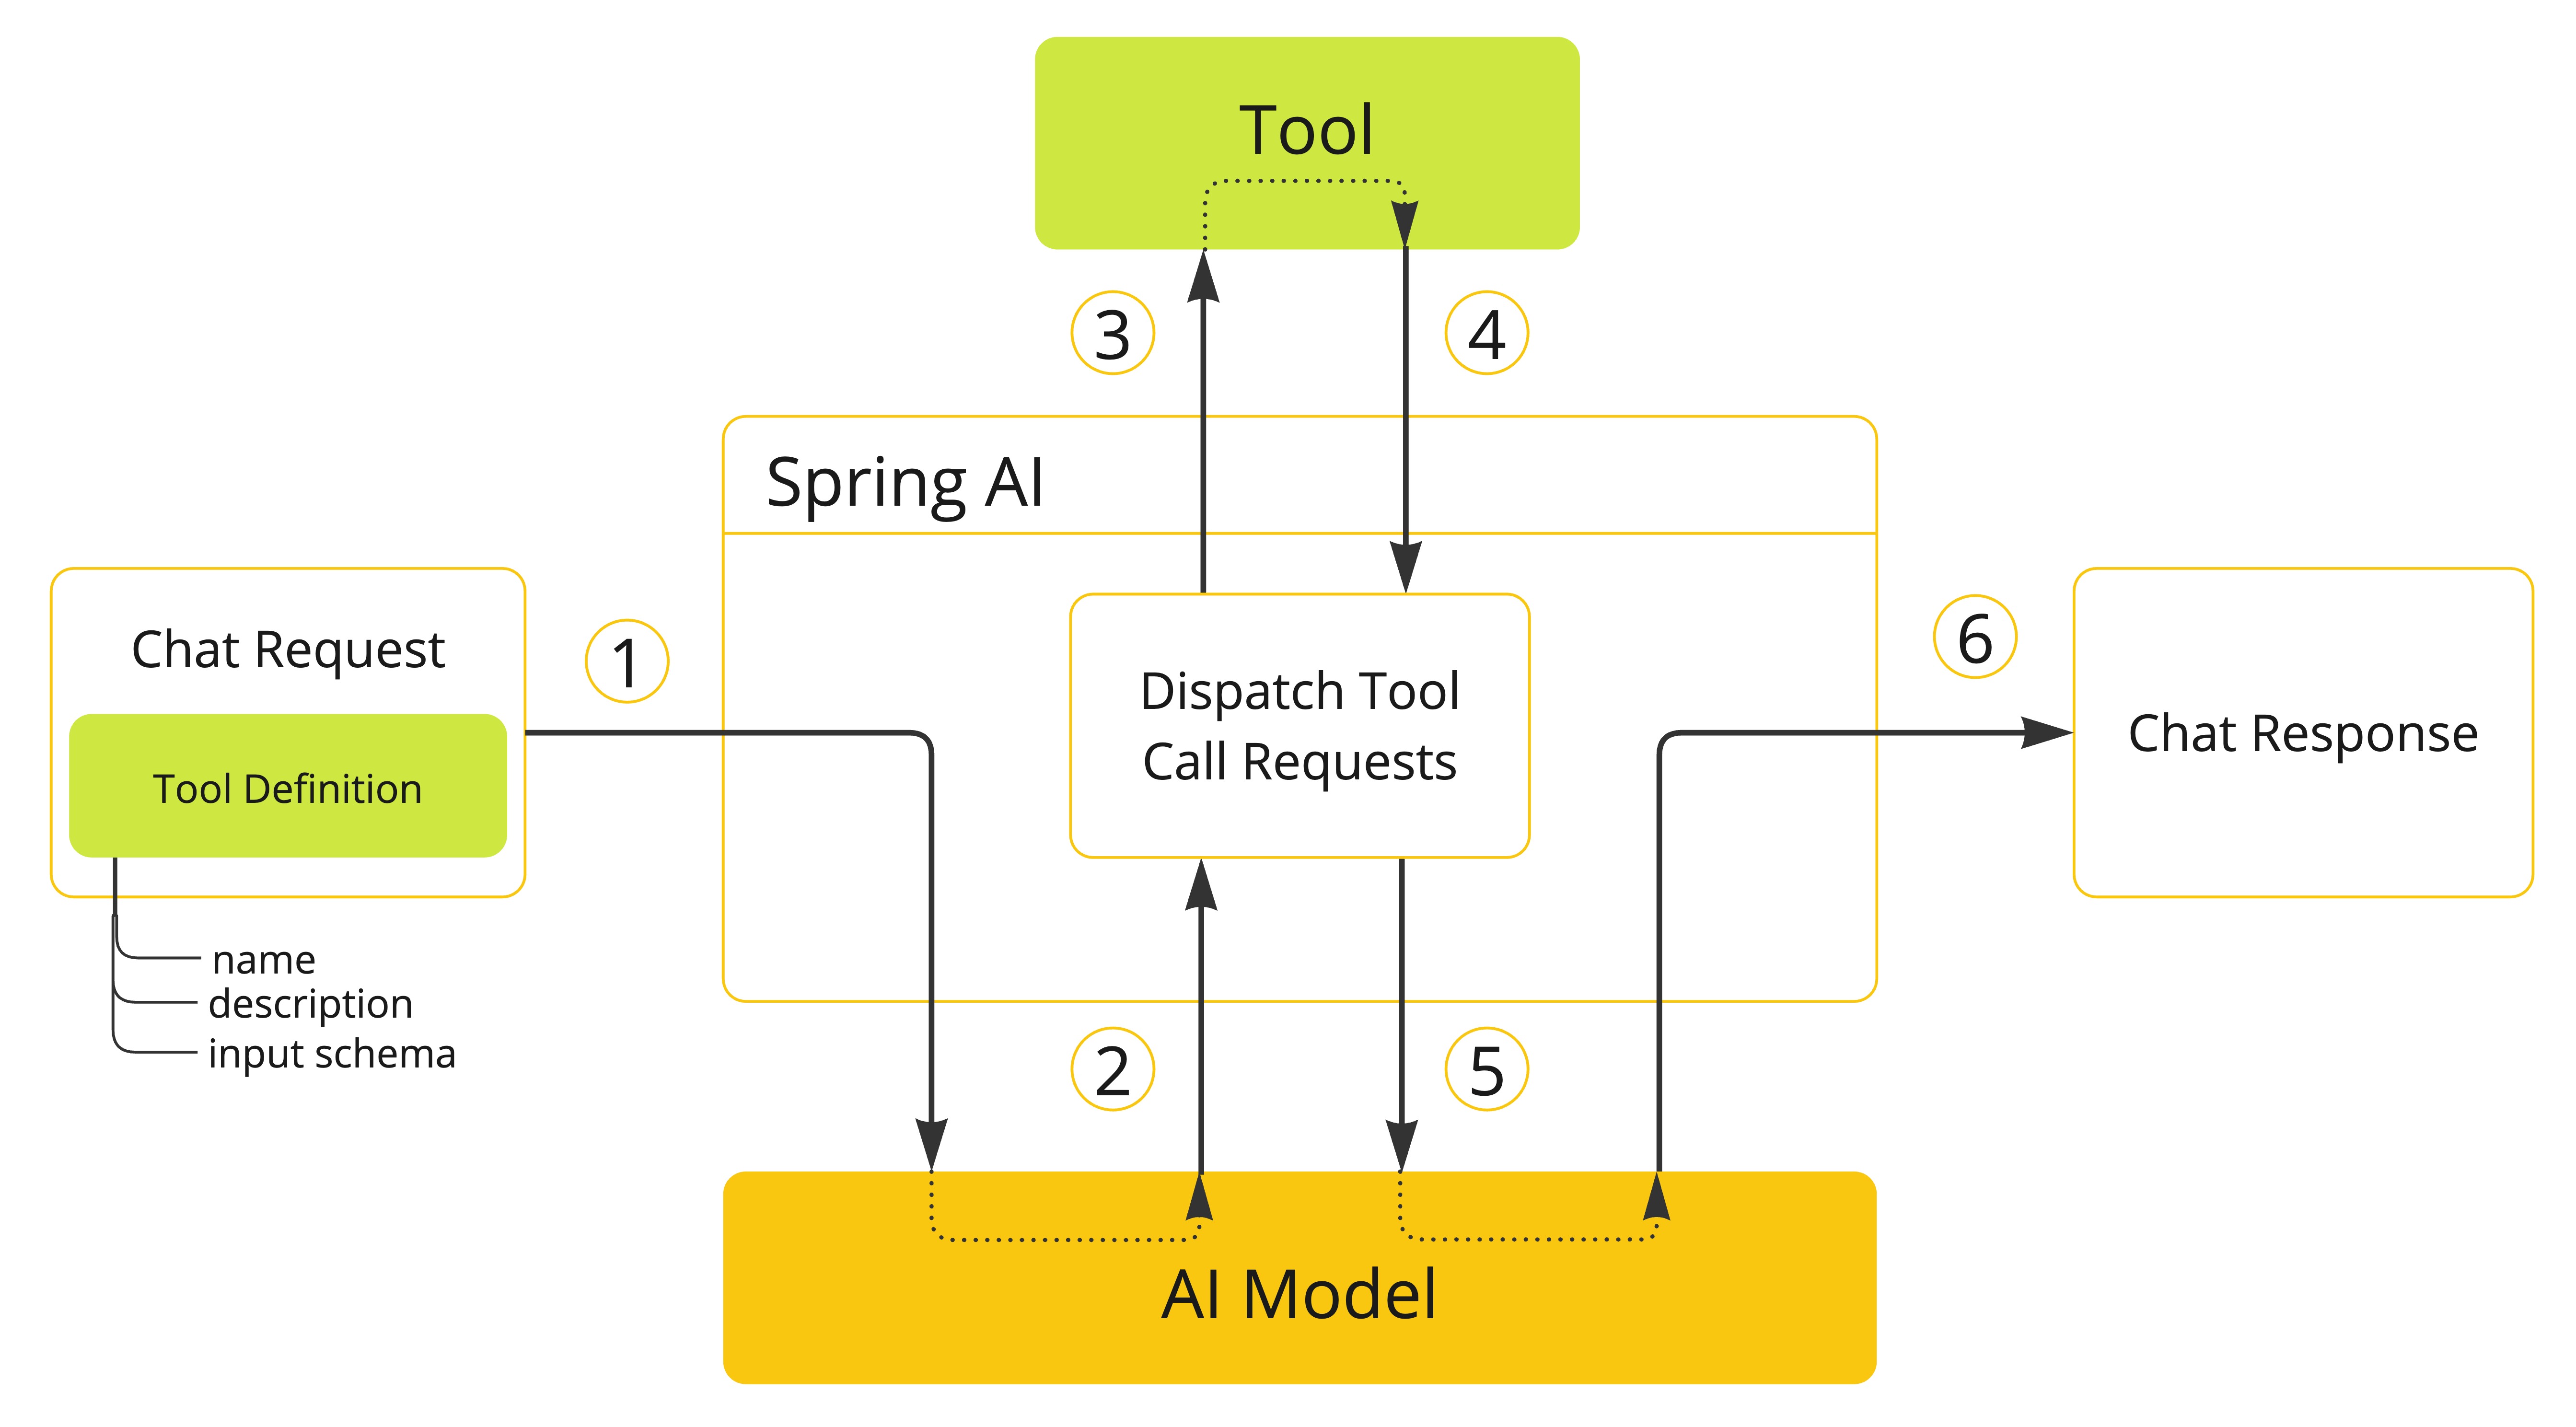
查看Spring AI 工具调用 文档。
自动配置
Spring Boot 对 AI 模型和向量存储的自动配置与Starters。
ETL数据工程
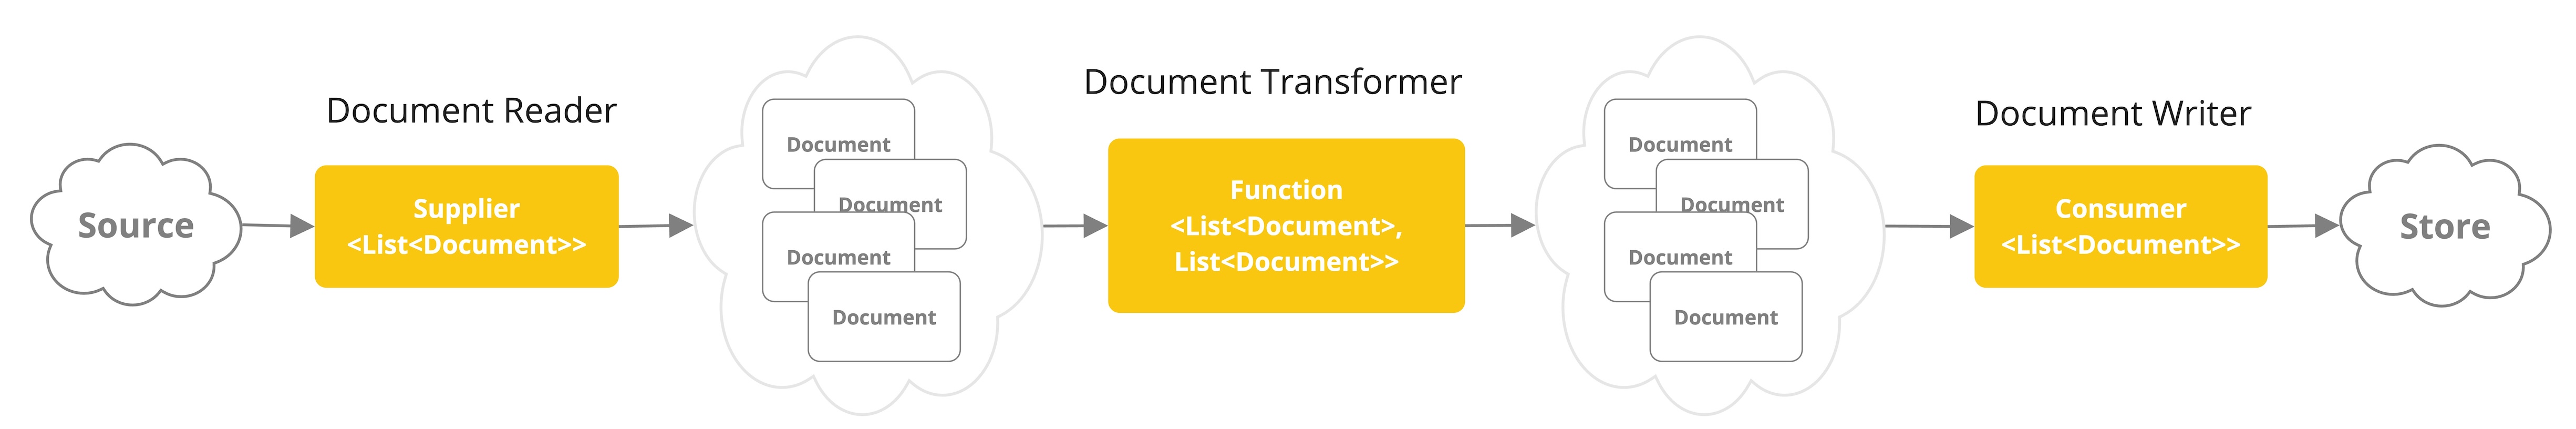
数据工程的ETL框架。这为将数据加载到向量数据库中提供了基础,有助于实现检索增强生成模式,使您能够将数据带给AI模型,融入其响应中。
具体模型
实际看一下官网,没有太必要记录(需要的时候再看了)【有比较多】
- 聊天模型
- 嵌入模型
- 图像模型
- 音频模型
- 审核模型
聊天记忆
大型语言模型(LLMs)是无状态的,这意味着它们不会保留关于先前交互的信息。当你希望在多次交互中保持上下文或状态时,这可能成为一个限制。为了解决这个问题,Spring AI提供了聊天记忆功能,允许你在与LLM的多次交互中存储和检索信息。
ChatMemory 抽象允许您实现多种类型的记忆存储以支持不同的使用场景。消息的底层存储由 ChatMemoryRepository 处理,其唯一职责是存储和检索消息。决定保留哪些消息以及何时移除它们则是由 ChatMemory 实现来决定的。策略示例可能包括保留最后N条消息、保留消息一定时间段,或保留消息直到达到某个Tokens限制。
在选择内存类型之前,理解聊天内存和聊天历史之间的区别是至关重要的。
- 聊天记忆. 大型语言模型在对话过程中保留并使用的,用以维持上下文意识的信息。
- 聊天记录. 包含用户与模型之间所有交换信息的完整对话历史。
ChatMemory 抽象设计用于管理 聊天内存 。它使您能够存储和检索与当前对话上下相关的消息。然而,它并不适合存储 聊天历史记录 。如果您需要维护所有交换消息的完整记录,应考虑使用不同方法,比如依靠Spring Data来高效存储和检索完整的聊天历史记录。
快速开始
Spring AI 会自动配置一个 ChatMemory bean,您可以在应用程序中直接使用。默认情况下,它使用内存存储库来存储消息 (InMemoryChatMemoryRepository) 和一个 MessageWindowChatMemory 实现来管理对话历史。如果已经配置了其他存储库(例如,Cassandra、JDBC 或 Neo4j),Spring AI 将使用那个存储库代替。
java
@Autowired
ChatMemory chatMemory;
以下各节将进一步介绍Spring AI中可用的不同内存类型和存储库。
内存类型
ChatMemory 抽象允许您实现多种类型的内存,以适应不同的使用场景。内存类型的选择会显著影响应用程序的性能和行为。本节描述了Spring AI提供的内置内存类型及其特性。
消息窗口聊天记录
MessageWindowChatMemory 保持一定数量的消息窗口,最多达到指定的最大值。当消息数量超过最大值时,会移除较早的消息,同时保留系统消息。默认的消息窗口大小为20条消息。
java
MessageWindowChatMemory memory = MessageWindowChatMemory.builder()
    .maxMessages(10)
    .build();
这是Spring AI用于自动配置 ChatMemory bean的默认消息类型。
内存存储
Spring AI 为存储聊天记忆提供了 ChatMemoryRepository 抽象。本节描述了 Spring AI 提供的内置存储库及其使用方法,但如有需要,您也可以实现自己的存储库。
内存中存储库
InMemoryChatMemoryRepository 使用 ConcurrentHashMap 在内存中存储消息。
默认情况下,如果没有配置其他仓库,Spring AI 会自动配置一个类型为 ChatMemoryRepository 的 InMemoryChatMemoryRepository bean,您可以在应用程序中直接使用它。
java
@Autowired
ChatMemoryRepository chatMemoryRepository;
如果希望手动创建 InMemoryChatMemoryRepository ,可以按照以下方式操作:
java
ChatMemoryRepository repository = new InMemoryChatMemoryRepository();JdbcChat内存存储库
JdbcChatMemoryRepository 是一个内置实现,使用JDBC将消息存储在关系数据库中。它开箱即支持多种数据库,适用于需要持久化存储聊天记忆的应用程序。
消息按时间戳的升序(从旧到新)检索,这是LLM对话历史记录的预期格式。
首先,将以下依赖项添加到您的项目中:
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-chat-memory-repository-jdbc</artifactId>
</dependency>
Spring AI 为 JdbcChatMemoryRepository 提供了自动配置,您可以在应用程序中直接使用。
java
@Autowired
JdbcChatMemoryRepository chatMemoryRepository;

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
如果希望手动创建 JdbcChatMemoryRepository ,可以通过提供一个 JdbcTemplate 实例和一个 JdbcChatMemoryRepositoryDialect 来实现:
java
ChatMemoryRepository chatMemoryRepository = JdbcChatMemoryRepository.builder()
    .jdbcTemplate(jdbcTemplate)
    .dialect(new PostgresChatMemoryRepositoryDialect())
    .build();

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
支持的数据库和方言抽象
Spring AI 通过方言抽象支持多种关系型数据库。开箱即支持以下数据库:
- PostgreSQL
- MySQL / MariaDB
- SQL Server
- HSQLDB
- Oracle数据库
当使用 JdbcChatMemoryRepositoryDialect.from(DataSource) 时,可以从JDBC URL自动检测正确的方言。您可以通过实现 JdbcChatMemoryRepositoryDialect 接口来扩展对其他数据库的支持。
配置属性
| 属性 | 描述 | 默认值 |
|---|---|---|
spring.ai.chat.memory.repository.jdbc.initialize-schema | 控制何时初始化架构。值: embedded (默认), always , never 。 | embedded |
spring.ai.chat.memory.repository.jdbc.schema | 要使用的架构脚本初始化的位置。支持 classpath:个URL和平台占位符。 | classpath:org/springframework/ai/chat/memory/repository/jdbc/schema-@@platform@@.sql |
spring.ai.chat.memory.repository.jdbc.platform | 如果初始化脚本中使用了 @@platform@@ 占位符,应使用的平台。 | auto-detected |
架构初始化
自动配置将在启动时自动创建 SPRING_AI_CHAT_MEMORY 表,使用针对您的数据库的特定于提供商的SQL脚本。默认情况下,架构初始化仅对嵌入式数据库(H2、HSQL、Derby等)运行。
您可以使用 spring.ai.chat.memory.repository.jdbc.initialize-schema 属性来控制模式初始化:
properties
spring.ai.chat.memory.repository.jdbc.initialize-schema=embedded # Only for embedded DBs (default)
spring.ai.chat.memory.repository.jdbc.initialize-schema=always   # Always initialize
spring.ai.chat.memory.repository.jdbc.initialize-schema=never    # Never initialize (useful with Flyway/Liquibase)
要覆盖架构脚本的位置,请使用:
properties
spring.ai.chat.memory.repository.jdbc.schema=classpath:/custom/path/schema-mysql.sql扩展方言
要为新数据库添加支持,实现 MessageSourceDialect 接口并提供用于选择、插入和删除消息的SQL。之后,您可以将自定义方言传递给仓库构建器。
java
ChatMemoryRepository chatMemoryRepository = JdbcChatMemoryRepository.builder()
    .jdbcTemplate(jdbcTemplate)
    .dialect(new MyCustomDbDialect())
    .build();
卡桑德拉聊天内存存储库
CassandraChatMemoryRepository 使用Apache Cassandra存储消息。它适用于需要持久化存储聊天记录的应用程序,特别是在需要高可用性、持久性、可扩展性以及利用时间存活期(TTL)功能的场景下。
CassandraChatMemoryRepository 具有时间序列模式,记录了所有过往的聊天窗口,对于管理和审计非常有价值。建议设置存活时间为某个值,例如三年。
消息按时间戳的升序(从旧到新)检索,这是LLM对话历史记录的预期格式。
要使用 CassandraChatMemoryRepository 首先,将依赖项添加到您的项目中:
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-chat-memory-repository-cassandra</artifactId>
</dependency>
Spring AI 为 CassandraChatMemoryRepository 提供了自动配置,您可以在应用程序中直接使用。
java
@Autowired
CassandraChatMemoryRepository chatMemoryRepository;

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
如果希望手动创建 CassandraChatMemoryRepository ,可以通过提供一个 CassandraChatMemoryRepositoryConfig 实例来实现:
java
ChatMemoryRepository chatMemoryRepository = CassandraChatMemoryRepository
    .create(CassandraChatMemoryRepositoryConfig.builder().withCqlSession(cqlSession));

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
配置属性
| 属性 | 描述 | 默认值 |
|---|---|---|
spring.cassandra.contactPoints | 要进行集群发现的主机(s) | 127.0.0.1 |
spring.cassandra.port | 连接到Cassandra原生协议的端口 | 9042 |
spring.cassandra.localDatacenter | 要连接的Cassandra数据中心 | datacenter1 |
spring.ai.chat.memory.cassandra.time-to-live | 在Cassandra中写入消息的生存时间(TTL) | |
spring.ai.chat.memory.cassandra.keyspace | Cassandra 键空间 | springframework |
spring.ai.chat.memory.cassandra.messages-column | Cassandra中消息的列名称 | springframework |
spring.ai.chat.memory.cassandra.table | Cassandra 表 | ai_chat_memory |
spring.ai.chat.memory.cassandra.initialize-schema | 是否在启动时初始化数据库模式。 | true |
架构初始化
自动配置将自动创建表 ai_chat_memory 。
可以通过将属性 spring.ai.chat.memory.repository.cassandra.initialize-schema 设置为 false 来禁用架构初始化。
Neo4j 聊天记忆库实现
Neo4jChatMemoryRepository 是一个内置实现,使用Neo4j将聊天消息作为节点和关系存储在属性图数据库中。它适用于希望利用Neo4j的图功能来持久化聊天记忆的应用程序。
消息按升序的消息索引顺序(从旧到新)检索,这是LLM对话历史记录的预期格式。
首先,将以下依赖项添加到您的项目中:
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-chat-memory-repository-neo4j</artifactId>
</dependency>
Spring AI 为 Neo4jChatMemoryRepository 提供了自动配置,您可以在应用程序中直接使用。
java
@Autowired
Neo4jChatMemoryRepository chatMemoryRepository;

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
如果希望手动创建 Neo4jChatMemoryRepository ,可以通过提供一个Neo4j Driver 实例来实现:
java
ChatMemoryRepository chatMemoryRepository = Neo4jChatMemoryRepository.builder()
    .driver(driver)
    .build();

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
配置属性
| 属性 | 描述 | 默认值 |
|---|---|---|
spring.ai.chat.memory.repository.neo4j.sessionLabel | 存储对话会话的节点标签 | Session |
spring.ai.chat.memory.repository.neo4j.messageLabel | 存储消息的节点标签 | Message |
spring.ai.chat.memory.repository.neo4j.toolCallLabel | 存储工具调用(例如,在助手消息中)的节点标签 | ToolCall |
spring.ai.chat.memory.repository.neo4j.metadataLabel | 存储消息元数据的节点标签 | Metadata |
spring.ai.chat.memory.repository.neo4j.toolResponseLabel | 存储工具响应的节点标签 | ToolResponse |
spring.ai.chat.memory.repository.neo4j.mediaLabel | 与消息关联的媒体存储节点的标签 | Media |
索引初始化
Neo4j仓库将自动确保为会话ID和消息索引创建索引,以优化性能。如果您使用自定义标签,也将为这些标签创建索引。无需进行架构初始化,但您应确保您的Neo4j实例对应用程序是可访问的。
CosmosDB聊天内存存储库
CosmosDBChatMemoryRepository 是一个内置实现,使用Azure Cosmos DB NoSQL API来存储消息。它适用于需要全球分布、高度可扩展的文档数据库来持久化聊天记忆的应用程序。仓库使用会话ID作为分区键,以确保数据的有效分布和快速检索。
消息按时间戳的升序(从旧到新)检索,这是LLM对话历史记录的预期格式。
首先,将以下依赖项添加到您的项目中:
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-chat-memory-repository-cosmos-db</artifactId>
</dependency>
Spring AI 为 CosmosDBChatMemoryRepository 提供了自动配置,您可以在应用程序中直接使用。
java
@Autowired
CosmosDBChatMemoryRepository chatMemoryRepository;

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
如果希望手动创建 CosmosDBChatMemoryRepository ,可以通过提供一个 CosmosDBChatMemoryRepositoryConfig 实例来实现:
java
ChatMemoryRepository chatMemoryRepository = CosmosDBChatMemoryRepository
    .create(CosmosDBChatMemoryRepositoryConfig.builder()
        .withCosmosClient(cosmosAsyncClient)
        .withDatabaseName("chat-memory-db")
        .withContainerName("conversations")
        .build());

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
配置属性
| 属性 | 描述 | 默认值 |
|---|---|---|
spring.ai.chat.memory.repository.cosmosdb.endpoint | Azure Cosmos DB 终端URI。自动配置所需。 | |
spring.ai.chat.memory.repository.cosmosdb.key | Azure Cosmos DB的主密钥或辅助密钥。如果未提供,将使用Azure身份验证。 | |
spring.ai.chat.memory.repository.cosmosdb.connection-mode | Cosmos DB客户端的连接模式( direct 或 gateway )。 | gateway |
spring.ai.chat.memory.repository.cosmosdb.database-name | Cosmos DB数据库的名称。 | SpringAIChatMemory |
spring.ai.chat.memory.repository.cosmosdb.container-name | Cosmos DB容器的名称。 | ChatMemory |
spring.ai.chat.memory.repository.cosmosdb.partition-key-path | 容器的分区键路径。 | /conversationId |
身份验证
Cosmos DB 聊天内存存储库支持两种身份验证方法:
- 基于密钥的身份验证: 请使用
spring.ai.chat.memory.repository.cosmosdb.key属性提供您的Cosmos DB主密钥或辅助密钥。 - Azure 身份验证: 当未提供密钥时,存储库使用 Azure Identity (
DefaultAzureCredential) 通过托管标识、服务主体或其他 Azure 凭据源进行身份验证。
架构初始化
如果尚不存在,自动配置将自动创建指定的数据库和容器。容器配置使用会话ID作为分区键( /conversationId ),以确保聊天内存操作的最佳性能。无需手动设置架构。
您可以使用上述配置属性来自定义数据库和容器名称。
MongoChat内存存储库
MongoChatMemoryRepository 是一个内置实现,使用MongoDB存储消息。它适用于需要灵活的、面向文档的数据库来持久化聊天记录的应用程序。
消息按时间戳的升序(从旧到新)检索,这是LLM对话历史记录所需的格式。这种排序方式在所有聊天记忆存储实现中保持一致。
首先,将以下依赖项添加到您的项目中:
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-chat-memory-repository-mongodb</artifactId>
</dependency>
Spring AI 为 MongoChatMemoryRepository 提供了自动配置,您可以在应用程序中直接使用。
java
@Autowired
MongoChatMemoryRepository chatMemoryRepository;

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
如果希望手动创建 MongoChatMemoryRepository ,可以通过提供一个 MongoTemplate 实例来实现:
java
ChatMemoryRepository chatMemoryRepository = MongoChatMemoryRepository.builder()
    .mongoTemplate(mongoTemplate)
    .build();

ChatMemory chatMemory = MessageWindowChatMemory.builder()
    .chatMemoryRepository(chatMemoryRepository)
    .maxMessages(10)
    .build();
配置属性
| 属性 | 描述 | 默认值 |
|---|---|---|
spring.ai.chat.memory.repository.mongo.create-indices | 是否应在启动时自动创建或重新创建索引。注意:更改*TTL*值将删除TTL索引并重新创建它。 | false |
spring.ai.chat.memory.repository.mongo.ttl | MongoDB中写入消息的生存时间(TTL),以秒为单位。如果不设置,消息将无限期存储。 | 0 |
集合初始化
自动配置将在启动时自动创建集合 ai_chat_memory ,如果它尚不存在的话。
聊天客户端中的内存
在使用ChatClient API时,您可以提供一个 ChatMemory 实现来跨多个交互维护会话上下文。
Spring AI 提供了一些内置的顾问,您可以根据需要使用它们来配置 ChatClient 的内存行为。
| 目前,在执行工具调用时与大型语言模型交换的中间消息并未存储在内存中。这是当前实现的一个限制,将在未来的版本中得到解决。如果您需要存储这些消息,请参考 用户控制的工具执行 指南。 |
|---|
MessageChatMemoryAdvisor. 此顾问使用提供的ChatMemory实现来管理对话记忆。在每次交互中,它从内存中检索对话历史,并将其作为消息集合包含在提示中。PromptChatMemoryAdvisor. 此顾问使用所提供的ChatMemory实现来管理对话记忆。在每次交互中,它从内存中检索对话历史,并将其作为纯文本追加到系统提示中。VectorStoreChatMemoryAdvisor. 此顾问使用所提供的VectorStore实现来管理对话记忆。在每次交互中,它从向量存储中检索对话历史,并将其作为纯文本附加到系统消息中。
例如,如果你想在 MessageWindowChatMemory 中使用 MessageChatMemoryAdvisor ,你可以这样配置:
java
ChatMemory chatMemory = MessageWindowChatMemory.builder().build();

ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(MessageChatMemoryAdvisor.builder(chatMemory).build())
    .build();
在调用 ChatClient 时,内存将由 MessageChatMemoryAdvisor 自动管理。根据指定的会话ID,会话历史记录将从内存中检索:
java
String conversationId = "007";

chatClient.prompt()
    .user("Do I have license to code?")
    .advisors(a -> a.param(ChatMemory.CONVERSATION_ID, conversationId))
    .call()
    .content();
即时聊天内存顾问
自定义模板
数字 PromptChatMemoryAdvisor 使用默认模板增强系统消息,包含检索到的对话记忆。您可以通过.promptTemplate() 构建器方法提供自定义的 PromptTemplate 对象来定制此行为。
提供的 PromptTemplate 在这里定制了顾问如何将检索到的内存与系统消息合并。这与在 ChatClient 本身上配置 TemplateRenderer (使用.templateRenderer() )不同,后者影响顾问运行 前 初始用户/系统提示内容的渲染。有关客户端级模板渲染的更多详细信息,请参见 ChatClient 提示模板 。 |
|---|
自定义的 PromptTemplate 可以使用任何 TemplateRenderer 实现(默认情况下,它使用基于 StringTemplate 引擎的 StPromptTemplate )。关键要求是模板必须包含以下两个占位符:
- 一个
instructions占位符,用于接收原始系统消息。 - 一个
memory占位符,用于接收检索到的会话记忆。
向量存储聊天记忆顾问
自定义模板
数字 VectorStoreChatMemoryAdvisor 使用默认模板增强系统消息,包含检索到的对话记忆。您可以通过.promptTemplate() 构建器方法提供自定义的 PromptTemplate 对象来定制此行为。
提供的 PromptTemplate 在这里定制了顾问如何将检索到的内存与系统消息合并。这与在 ChatClient 本身上配置 TemplateRenderer (使用.templateRenderer() )不同,后者影响顾问运行 前 初始用户/系统提示内容的渲染。有关客户端级模板渲染的更多详细信息,请参见 ChatClient 提示模板 。 |
|---|
自定义的 PromptTemplate 可以使用任何 TemplateRenderer 实现(默认情况下,它使用基于 StringTemplate 引擎的 StPromptTemplate )。关键要求是模板必须包含以下两个占位符:
- 一个
instructions占位符,用于接收原始系统消息。 - 一个
long_term_memory占位符,用于接收检索到的会话记忆。
聊天模型中的内存
如果您直接处理的是 ChatModel 而不是 ChatClient ,您可以显式管理内存:
java
// Create a memory instance
ChatMemory chatMemory = MessageWindowChatMemory.builder().build();
String conversationId = "007";

// First interaction
UserMessage userMessage1 = new UserMessage("My name is James Bond");
chatMemory.add(conversationId, userMessage1);
ChatResponse response1 = chatModel.call(new Prompt(chatMemory.get(conversationId)));
chatMemory.add(conversationId, response1.getResult().getOutput());

// Second interaction
UserMessage userMessage2 = new UserMessage("What is my name?");
chatMemory.add(conversationId, userMessage2);
ChatResponse response2 = chatModel.call(new Prompt(chatMemory.get(conversationId)));
chatMemory.add(conversationId, response2.getResult().getOutput());

// The response will contain "James Bond"
工具调用
工具调用 (也称为 函数调用 )是AI应用程序中的一种常见模式,允许模型与一组API或 工具 交互,从而增强其功能。
工具主要用于:
- 信息检索 。此类工具可用于从外部源检索信息,如数据库、网络服务、文件系统或网页搜索引擎。目的是增强模型的知识,使其能够回答否则无法回答的问题。因此,它们可以用于检索增强生成(RAG)场景。例如,一个工具可用于查询给定位置的当前天气、检索最新新闻文章或查询数据库以获取特定记录。
- 执行操作 。此类别中的工具可用于在软件系统中执行操作,如发送电子邮件、在数据库中创建新记录、提交表单或触发工作流。目标是自动化那些原本需要人工干预或显式编程的任务。例如,一个工具可以用来为与聊天机器人交互的客户预订航班、填写网页上的表单,或在代码生成场景中根据自动测试(TDD)实现Java类。
尽管我们通常将 工具调用 称为模型功能,但实际上它取决于客户端应用程序来提供工具调用逻辑。模型只能请求工具调用并提供输入参数,而执行工具调用并返回结果的责任在于应用程序。模型永远不会访问作为工具提供的任何API,这是至关重要的安全考虑因素。
Spring AI 为定义工具、从模型中解析工具调用请求以及执行工具调用提供了便捷的API。以下部分概述了Spring AI中的工具调用功能。
| 查看 聊天模型对比 ,了解哪些AI模型支持工具调用功能。 |
|---|
| 遵循指南从已弃用的 FunctionCallback 迁移到ToolCallback API。 |
|---|
快速开始
让我们看看如何在Spring AI中开始使用工具调用。我们将实现两个简单的工具:一个用于信息检索,另一个用于执行动作。信息检索工具将用于获取用户时区中的当前日期和时间。动作工具将用于设置指定时间的闹钟。
信息检索
AI模型无法获取实时信息。任何假设模型知晓诸如当前日期或天气预报等信息的问题都无法得到解答。但是,我们可以提供一个工具来检索这些信息,并在需要获取实时信息时让模型调用这个工具。
让我们实现一个工具,用于获取用户时区中的当前日期和时间,在 DateTimeTools 类中。该工具将不接受任何参数。Spring框架的 LocaleContextHolder 可以提供用户的时区。该工具将被定义为一个使用 @Tool 注解的方法。为了帮助模型理解是否以及何时调用此工具,我们将提供有关工具功能的详细描述。
java
import java.time.LocalDateTime;
import org.springframework.ai.tool.annotation.Tool;
import org.springframework.context.i18n.LocaleContextHolder;

class DateTimeTools {

    @Tool(description = "Get the current date and time in the user's timezone")
    String getCurrentDateTime() {
        return LocalDateTime.now().atZone(LocaleContextHolder.getTimeZone().toZoneId()).toString();
    }

}
接下来,让我们使该工具对模型可用。在此示例中,我们将使用 ChatClient 与模型进行交互。我们通过 tools() 方法传递一个 DateTimeTools 实例,以此向模型提供该工具。当模型需要知道当前日期和时间时,它将请求调用该工具。内部地, ChatClient 将调用该工具并将结果返回给模型,模型随后会使用工具调用的结果来生成对原始问题的最终响应。
java
ChatModel chatModel = ...

String response = ChatClient.create(chatModel)
        .prompt("What day is tomorrow?")
        .tools(new DateTimeTools())
        .call()
        .content();

System.out.println(response);
输出将会是这样的形式:
Tomorrow is 2015-10-21.您可以再次尝试提出相同的问题。这次,请不要向模型提供工具。输出内容将会是这样的:
I am an AI and do not have access to real-time information. Please provide the current date so I can accurately determine what day tomorrow will be.如果没有该工具,模型无法回答问题,因为它没有能力确定当前的日期和时间。
执行操作
AI模型可以用于生成实现特定目标的计划。例如,一个模型可以生成一个预订前往丹麦旅行的计划。然而,模型本身并不具备执行该计划的能力。这时工具就派上用场了:它们可以用来执行模型所生成的计划。
在上一个示例中,我们使用了一个工具来确定当前的日期和时间。在这个示例中,我们将定义第二个工具,用于在特定时间设置闹钟。目标是设置一个从现在起10分钟后的闹钟,所以我们需要将这两个工具都提供给模型以完成此任务。
我们将把新工具添加到之前相同的 DateTimeTools 类中。新工具将接受一个参数,即ISO-8601格式的时间。然后,该工具将向控制台打印一条消息,指示已为给定时间设置了闹钟。与之前一样,该工具被定义为使用 @Tool 注解的方法,我们也用它来提供详细描述,以帮助模型理解何时以及如何使用该工具。
java
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import org.springframework.ai.tool.annotation.Tool;
import org.springframework.context.i18n.LocaleContextHolder;

class DateTimeTools {

    @Tool(description = "Get the current date and time in the user's timezone")
    String getCurrentDateTime() {
        return LocalDateTime.now().atZone(LocaleContextHolder.getTimeZone().toZoneId()).toString();
    }

    @Tool(description = "Set a user alarm for the given time, provided in ISO-8601 format")
    void setAlarm(String time) {
        LocalDateTime alarmTime = LocalDateTime.parse(time, DateTimeFormatter.ISO_DATE_TIME);
        System.out.println("Alarm set for " + alarmTime);
    }

}
接下来,让我们使这两个工具对模型可用。我们将使用 ChatClient 与模型进行交互。通过 tools() 方法传递 DateTimeTools 的实例,我们将这些工具提供给模型。当要求从现在起10分钟后设置闹钟时,模型首先需要知道当前的日期和时间。然后,它将使用当前的日期和时间来计算闹钟时间。最后,它将使用闹钟工具来设置闹钟。在内部, ChatClient 将处理模型发出的任何工具调用请求,并将任何工具调用执行结果返回给模型,以便模型生成最终响应。
java
ChatModel chatModel = ...

String response = ChatClient.create(chatModel)
        .prompt("Can you set an alarm 10 minutes from now?")
        .tools(new DateTimeTools())
        .call()
        .content();

System.out.println(response);
在应用程序日志中,您可以检查警报是否已在正确的时间设置。
概述
Spring AI 通过一套灵活的抽象支持工具调用,使您能够以一致的方式定义、解析和执行工具。本节概述了 Spring AI 中工具调用的主要概念和组件。
- 当我们希望将一个工具提供给模型时,我们会将其定义包含在聊天请求中。每个工具定义包含名称、描述和输入参数的schema。
- 当模型决定调用工具时,它会发送一个响应,包含工具名称和基于定义的模式的输入参数。
- 这个应用负责使用工具名来识别并执行工具,并带有提供的输入参数。
- 工具调用的结果将由应用程序处理。
- 应用程序将工具调用的结果返回给模型。
- 该模型使用工具调用结果作为额外的上下文来生成最终响应。
工具是调用工具的基石,它们通过 ToolCallback 接口进行建模。Spring AI为从方法和函数中指定 ToolCallback (s)提供了内置支持,但您始终可以定义自己的 ToolCallback 实现来支持更多使用场景。
ChatModel 实现透明地将工具调用请求分派给相应的 ToolCallback 实现,并将工具调用结果返回给模型,后者最终生成最终响应。它们通过使用 ToolCallingManager 接口来完成这一过程,该接口负责管理工具执行的生命周期。
数字 ChatClient 和 ChatModel 均接受一个包含 ToolCallback 个对象的列表,以便将工具提供给模型及最终执行它们的 ToolCallingManager 。
除了直接传递 ToolCallback 对象,您还可以传递工具名称列表,这些名称将通过 ToolCallbackResolver 接口动态解析。
以下各节将更详细地介绍所有这些概念和API,包括如何定制和扩展它们以支持更多应用场景。
方法作为工具
Spring AI 为通过两种方式从方法中指定工具(即 ToolCallback (s))提供了内置支持:
- 使用
@0注解声明式地 - 通过编程方式,使用低级别的
MethodToolCallback实现。
声明式规范: @Tool
可以通过使用 @0 注解将一个方法转换为工具方法。
java
class DateTimeTools {

    @Tool(description = "Get the current date and time in the user's timezone")
    String getCurrentDateTime() {
        return LocalDateTime.now().atZone(LocaleContextHolder.getTimeZone().toZoneId()).toString();
    }

}
@Tool 注解允许您提供关于工具的关键信息:
name: 工具名称。如未提供,将使用方法名。AI模型在调用工具时使用此名称来识别工具。因此,在同一类中不允许存在两个同名的工具。该名称必须在针对特定聊天请求的模型可用的所有工具中是唯一的。description: 工具的描述,模型可以使用此描述来理解何时以及如何调用工具。如果不提供,将使用方法名作为工具描述。但是,强烈建议提供详细的描述,因为这对于模型理解工具的目的及使用方法至关重要。未能提供良好的描述可能导致模型在应当使用工具时未使用,或错误地使用工具。returnDirect: 工具结果是否应直接返回给客户端或传回模型。详情请参阅 直接返回 。resultConverter: 用于将工具调用结果转换为发送回AI模型的String object的ToolCallResultConverter实现。更多详细信息,请参见 结果转换 。
该方法既可以是静态的也可以是实例的,并且可以具有任何可见性(公共、受保护、包私有或私有)。包含该方法的类既可以是顶级类也可以是嵌套类,并且它也可以具有任何可见性(只要在您计划实例化它的位置可访问即可)。
Spring AI 为标注有 @Tool 的方法提供了内置的 AOT 编译支持,只要包含这些方法的类是 Spring Bean(例如 @Component )。否则,您需要向 GraalVM 编译器提供必要的配置。例如,通过使用 @RegisterReflection(memberCategories = MemberCategory.INVOKE_DECLARED_METHODS) 注解该类。 |
|---|
您可以为方法定义任意数量的参数(包括不带参数),支持多种类型(基本类型、POJO、枚举、列表、数组、映射等)。同样,方法也可以返回多种类型,包括 void 。如果方法有返回值,其返回类型必须是可序列化的,因为结果将被序列化并发送回模型。
| 某些类型不被支持。详情请参阅 方法工具限制 。 |
|---|
Spring AI 将自动为带有 @0 注解的方法的输入参数生成JSON模式。该模式被模型用来理解如何调用工具及准备工具请求。使用 @1 注解可以提供关于输入参数的额外信息,如描述、参数是否为必需或可选。默认情况下,所有输入参数都被视为必需。
java
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import org.springframework.ai.tool.annotation.Tool;
import org.springframework.ai.tool.annotation.ToolParam;

class DateTimeTools {

    @Tool(description = "Set a user alarm for the given time")
    void setAlarm(@ToolParam(description = "Time in ISO-8601 format") String time) {
        LocalDateTime alarmTime = LocalDateTime.parse(time, DateTimeFormatter.ISO_DATE_TIME);
        System.out.println("Alarm set for " + alarmTime);
    }

}
@ToolParam 注解允许您提供关于工具参数的关键信息:
description: 参数的描述,模型可以使用它来更好地理解如何使用该参数。例如,参数应采用的格式,允许的值等。required: 参数是否必需或可选。默认情况下,所有参数都被视为必需。
如果参数被注解为 @Nullable ,除非使用 @ToolParam 注解明确标记为必需,否则它将被视为可选。
除了使用 @ToolParam 注解,您还可以使用Swagger提供的 @Schema 注解或Jackson的 @JsonProperty 注解。更多详情,请参见 JSON Schema 。
向ChatClient添加工具
在使用声明式规范方法时,您可以在调用 ChatClient 时将工具类实例传递给 tools() 方法。这些工具仅对添加了它们的特定聊天请求可用。
java
ChatClient.create(chatModel)
    .prompt("What day is tomorrow?")
    .tools(new DateTimeTools())
    .call()
    .content();
实际上, ChatClient 将从工具类实例中每个带有 @Tool 注解的方法生成一个 ToolCallback ,并将其传递给模型。如果您更倾向于自己生成 ToolCallback (s),可以使用 ToolCallbacks 辅助类。
java
ToolCallback[] dateTimeTools = ToolCallbacks.from(new DateTimeTools());向ChatClient添加默认工具
在使用声明式规范方法时,您可以通过将工具类实例传递给 ChatClient.Builder 的 defaultTools() 方法来向其添加默认工具。如果同时提供了默认工具和运行时工具,那么运行时工具将完全覆盖默认工具。
默认工具在由相同 ChatClient.Builder 构建的所有 ChatClient 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具很有用,但如果不小心使用,也可能有危险,可能会导致在不应该的情况下使它们可用。 |
|---|
java
ChatModel chatModel = ...
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultTools(new DateTimeTools())
    .build();
向ChatModel添加工具
在使用声明式规范方法时,您可以将工具类实例传递给用于调用 ChatModel 的 ToolCallingChatOptions 的 toolCallbacks() 方法。这些工具仅对添加了它们的具体聊天请求可用。
java
ChatModel chatModel = ...
ToolCallback[] dateTimeTools = ToolCallbacks.from(new DateTimeTools());
ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolCallbacks(dateTimeTools)
    .build();
Prompt prompt = new Prompt("What day is tomorrow?", chatOptions);
chatModel.call(prompt);
向ChatModel添加默认工具
在使用声明式规范方法时,您可以在构建时通过将工具类实例传递给用于创建 ChatModel 的 ToolCallingChatOptions 实例的 toolCallbacks() 方法,向 ChatModel 添加默认工具。 如果同时提供了默认工具和运行时工具,那么运行时工具将完全覆盖默认工具。
默认工具在由该 ChatModel 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具非常有用,但如果使用不当也可能存在危险,可能会导致在不应可用时使它们变得可用。 |
|---|
java
ToolCallback[] dateTimeTools = ToolCallbacks.from(new DateTimeTools());
ChatModel chatModel = OllamaChatModel.builder()
    .ollamaApi(OllamaApi.builder().build())
    .defaultOptions(ToolCallingChatOptions.builder()
            .toolCallbacks(dateTimeTools)
            .build())
    .build();
程序化规范: MethodToolCallback
可以通过编程方式构建一个 MethodToolCallback ,将方法转化为工具。
java
class DateTimeTools {

    String getCurrentDateTime() {
        return LocalDateTime.now().atZone(LocaleContextHolder.getTimeZone().toZoneId()).toString();
    }

}
数字 MethodToolCallback.Builder 使您能够构建一个 MethodToolCallback 实例,并提供关于该工具的关键信息:
toolDefinition: 定义工具名称、描述和输入架构的ToolDefinition实例。您可以使用ToolDefinition.Builder类来构建。必需。toolMetadata: 定义了额外设置(如结果是否应直接返回给客户端以及使用的结果转换器)的ToolMetadata实例。您可以使用ToolMetadata.Builder类来构建它。toolMethod: 表示工具方法的Method实例。必填。toolObject: 包含工具方法的对象实例。如果该方法是静态的,您可以省略此参数。toolCallResultConverter: 用于将工具调用结果转换为String对象以返回给AI模型的ToolCallResultConverter实例。如果不提供,默认转换器将被使用(DefaultToolCallResultConverter)。
数字 ToolDefinition.Builder 使您能够构建一个 ToolDefinition 实例并定义工具名称、描述以及输入架构:
name: 工具名称。如未提供,将使用方法名。AI模型在调用工具时使用此名称来识别工具。因此,在同一类中不允许存在两个同名的工具。该名称必须在针对特定聊天请求的模型可用的所有工具中是唯一的。description: 工具的描述,模型可以使用此描述来理解何时以及如何调用工具。如果不提供,将使用方法名作为工具描述。但是,强烈建议提供详细的描述,因为这对于模型理解工具的目的及使用方法至关重要。未能提供良好的描述可能导致模型在应当使用工具时未使用,或错误地使用工具。inputSchema: 工具输入参数的JSON模式。如果不提供,模式将根据方法参数自动生成。您可以使用@ToolParam注解来提供关于输入参数的额外信息,如描述或参数是必需还是可选。默认情况下,所有输入参数都被视为必需。更多详细信息,请参见 JSON模式 。
数字 ToolMetadata.Builder 使您能够构建一个 ToolMetadata 实例并为工具定义额外的设置:
returnDirect: 工具结果是否应直接返回给客户端或传回模型。详情请参阅 直接返回 。
java
Method method = ReflectionUtils.findMethod(DateTimeTools.class, "getCurrentDateTime");
ToolCallback toolCallback = MethodToolCallback.builder()
    .toolDefinition(ToolDefinitions.builder(method)
            .description("Get the current date and time in the user's timezone")
            .build())
    .toolMethod(method)
    .toolObject(new DateTimeTools())
    .build();
该方法既可以是静态的也可以是实例的,并且可以具有任何可见性(公共、受保护、包私有或私有)。包含该方法的类既可以是顶级类也可以是嵌套类,并且它也可以具有任何可见性(只要在您计划实例化它的位置可访问即可)。
Spring AI 对工具方法提供了内置的支持进行AOT编译,只要包含这些方法的类是一个Spring Bean(例如 @Component )。否则,您需要向GraalVM编译器提供必要的配置。例如,通过使用 @RegisterReflection(memberCategories = MemberCategory.INVOKE_DECLARED_METHODS) 注解该类。 |
|---|
您可以为方法定义任意数量的参数(包括不带参数),支持多种类型(基本类型、POJO、枚举、列表、数组、映射等)。同样,方法也可以返回多种类型,包括 void 。如果方法有返回值,其返回类型必须是可序列化的,因为结果将被序列化并发送回模型。
| 某些类型不被支持。详情请参阅 方法工具限制 。 |
|---|
如果方法是静态的,您可以省略 toolObject() 方法,因为不需要它。
java
class DateTimeTools {

    static String getCurrentDateTime() {
        return LocalDateTime.now().atZone(LocaleContextHolder.getTimeZone().toZoneId()).toString();
    }

}
java
Method method = ReflectionUtils.findMethod(DateTimeTools.class, "getCurrentDateTime");
ToolCallback toolCallback = MethodToolCallback.builder()
    .toolDefinition(ToolDefinitions.builder(method)
            .description("Get the current date and time in the user's timezone")
            .build())
    .toolMethod(method)
    .build();
Spring AI 将自动为方法的输入参数生成JSON模式。该模式被模型用于理解如何调用工具及准备工具请求。使用 @Parameter 注解可以提供关于输入参数的额外信息,如描述或参数是必需还是可选。默认情况下,所有输入参数都被视为必需。
java
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import org.springframework.ai.tool.annotation.ToolParam;

class DateTimeTools {

    void setAlarm(@ToolParam(description = "Time in ISO-8601 format") String time) {
        LocalDateTime alarmTime = LocalDateTime.parse(time, DateTimeFormatter.ISO_DATE_TIME);
        System.out.println("Alarm set for " + alarmTime);
    }

}
@ToolParam 注解允许您提供关于工具参数的关键信息:
description: 参数的描述,模型可以使用它来更好地理解如何使用该参数。例如,参数应采用的格式,允许的值等。required: 参数是否必需或可选。默认情况下,所有参数都被视为必需。
如果参数被注解为 @Nullable ,除非使用 @ToolParam 注解明确标记为必需,否则它将被视为可选。
除了使用 @ToolParam 注解,您还可以使用Swagger提供的 @Schema 注解或Jackson的 @JsonProperty 注解。更多详情,请参见 JSON Schema 。
向ChatClient和ChatModel添加工具
当使用编程式指定方式时,您可以将 MethodToolCallback 实例传递给 toolCallbacks() 方法的 ChatClient 。 该工具将仅对添加了特定聊天请求的情况可用。
java
ToolCallback toolCallback = ...
ChatClient.create(chatModel)
    .prompt("What day is tomorrow?")
    .toolCallbacks(toolCallback)
    .call()
    .content();
向ChatClient添加默认工具
在使用编程式规范方法时,您可以通过将 ChatClient.Builder 实例传递给 defaultToolCallbacks() 方法向 ChatClient.Builder 添加默认工具。如果同时提供了默认工具和运行时工具,运行时工具将完全覆盖默认工具。
默认工具在由相同 ChatClient.Builder 构建的所有 ChatClient 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具很有用,但如果不小心使用,也可能有危险,可能会导致在不应该的情况下使它们可用。 |
|---|
java
ChatModel chatModel = ...
ToolCallback toolCallback = ...
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultToolCallbacks(toolCallback)
    .build();
向ChatModel添加工具
在使用编程式规范方法时,您可以将 MethodToolCallback 实例传递给 toolCallbacks() 方法,此方法位于您用于调用 ChatModel 的 ToolCallingChatOptions 中。该工具将仅对添加了它的特定聊天请求可用。
java
ChatModel chatModel = ...
ToolCallback toolCallback = ...
ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolCallbacks(toolCallback)
    .build();
Prompt prompt = new Prompt("What day is tomorrow?", chatOptions);
chatModel.call(prompt);
向ChatModel添加默认工具
在使用编程式规范方法时,您可以在构建时通过将 ChatModel 实例传递给用于创建 ChatModel 的 ToolCallingChatOptions 实例的 toolCallbacks() 方法,向 ChatModel 添加默认工具。 如果同时提供了默认工具和运行时工具,那么运行时工具将完全覆盖默认工具。
默认工具在由该 ChatModel 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具非常有用,但如果使用不当也可能存在危险,可能会导致在不应可用时使它们变得可用。 |
|---|
java
ToolCallback toolCallback = ...
ChatModel chatModel = OllamaChatModel.builder()
    .ollamaApi(OllamaApi.builder().build())
    .defaultOptions(ToolCallingChatOptions.builder()
            .toolCallbacks(toolCallback)
            .build())
    .build();
方法工具限制
以下类型目前不支持作为工具方法使用的参数或返回类型:
Optional- 异步类型(例如
CompletableFuture,Future) - 响应式类型(例如
Flow,Mono,Flux) - 函数类型(例如
Function,Supplier,Consumer).
函数式类型通过基于函数的工具规范方法得到支持。详情请参阅 函数作为工具 。
函数作为工具
Spring AI 为从函数中指定工具提供了内置支持,既可以使用低级 FunctionToolCallback 实现以编程方式指定,也可以作为运行时解析的 @Bean (s) 动态指定。
程序化规范: FunctionToolCallback
可以通过编程方式构建一个 FunctionToolCallback ,将功能类型( Function 、 Supplier 、 Consumer 或 BiFunction )转化为工具。
java
public class WeatherService implements Function<WeatherRequest, WeatherResponse> {
    public WeatherResponse apply(WeatherRequest request) {
        return new WeatherResponse(30.0, Unit.C);
    }
}

public enum Unit { C, F }
public record WeatherRequest(String location, Unit unit) {}
public record WeatherResponse(double temp, Unit unit) {}
数字 FunctionToolCallback.Builder 使您能够构建一个 FunctionToolCallback 实例,并提供关于该工具的关键信息:
name: 工具名称。AI模型在调用工具时使用此名称来识别工具。因此,在同一上下文中不允许存在两个同名的工具。对于模型针对特定聊天请求可访问的所有工具,该名称必须是唯一的。必填项。toolFunction: 表示工具方法的功能对象(Function,Supplier,Consumer, 或BiFunction)。必需。description: 工具的描述,模型可以使用此描述来理解何时以及如何调用工具。如果不提供,将使用方法名作为工具描述。但是,强烈建议提供详细的描述,因为这对于模型理解工具的目的及使用方法至关重要。未能提供良好的描述可能导致模型在应当使用工具时未使用,或错误地使用工具。inputType: 函数输入的类型。必需。inputSchema: 工具输入参数的JSON模式。如果不提供,模式将根据inputType自动生成。您可以使用@ToolParam注解来提供关于输入参数的额外信息,如描述或参数是必需还是可选。默认情况下,所有输入参数都被视为必需。更多详细信息,请参阅 JSON模式 。toolMetadata: 定义了额外设置(如结果是否应直接返回给客户端以及使用的结果转换器)的ToolMetadata实例。您可以使用ToolMetadata.Builder类来构建它。toolCallResultConverter: 用于将工具调用结果转换为String对象以返回给AI模型的ToolCallResultConverter实例。如果不提供,默认转换器将被使用(DefaultToolCallResultConverter)。
数字 ToolMetadata.Builder 使您能够构建一个 ToolMetadata 实例并为工具定义额外的设置:
returnDirect: 工具结果是否应直接返回给客户端或传回模型。详情请参阅 直接返回 。
java
ToolCallback toolCallback = FunctionToolCallback
    .builder("currentWeather", new WeatherService())
    .description("Get the weather in location")
    .inputType(WeatherRequest.class)
    .build();
函数的输入和输出可以是 Void 或POJO(普通Java对象)。输入和输出的POJO必须是可序列化的,因为结果会被序列化并发送回模型。函数及其输入和输出类型必须是公共的。
| 某些类型不被支持。详情请参阅 函数工具限制 。 |
|---|
向ChatClient添加工具
当使用编程式指定方式时,您可以将 FunctionToolCallback 实例传递给 toolCallbacks() 方法的 ChatClient 。 该工具将仅对添加了特定聊天请求的情况可用。
java
ToolCallback toolCallback = ...
ChatClient.create(chatModel)
    .prompt("What's the weather like in Copenhagen?")
    .toolCallbacks(toolCallback)
    .call()
    .content();
向ChatClient添加默认工具
在使用编程式规范方法时,您可以通过将 ChatClient.Builder 实例传递给 defaultToolCallbacks() 方法向 ChatClient.Builder 添加默认工具。如果同时提供了默认工具和运行时工具,运行时工具将完全覆盖默认工具。
默认工具在由相同 ChatClient.Builder 构建的所有 ChatClient 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具很有用,但如果不小心使用,也可能有危险,可能会导致在不应该的情况下使它们可用。 |
|---|
java
ChatModel chatModel = ...
ToolCallback toolCallback = ...
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultToolCallbacks(toolCallback)
    .build();
向ChatModel添加工具
当使用编程式指定方式时,您可以将 FunctionToolCallback 实例传递给 toolCallbacks() 方法的 ToolCallingChatOptions 。 该工具将仅对添加了特定聊天请求的情况可用。
java
ChatModel chatModel = ...
ToolCallback toolCallback = ...
ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolCallbacks(toolCallback)
    .build();
Prompt prompt = new Prompt("What's the weather like in Copenhagen?", chatOptions);
chatModel.call(prompt);
向ChatModel添加默认工具
在使用编程式规范方法时,您可以在构建时通过将 ChatModel 实例传递给用于创建 ChatModel 的 ToolCallingChatOptions 实例的 toolCallbacks() 方法,向 ChatModel 添加默认工具。 如果同时提供了默认工具和运行时工具,那么运行时工具将完全覆盖默认工具。
默认工具在由该 ChatModel 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具非常有用,但如果使用不当也可能存在危险,可能会导致在不应可用时使它们变得可用。 |
|---|
java
ToolCallback toolCallback = ...
ChatModel chatModel = OllamaChatModel.builder()
    .ollamaApi(OllamaApi.builder().build())
    .defaultOptions(ToolCallingChatOptions.builder()
            .toolCallbacks(toolCallback)
            .build())
    .build();
动态规范: @Bean
相比于编程式指定工具,您可以将工具定义为Spring Bean,并让Spring AI在运行时通过 ToolCallbackResolver 接口(借助 SpringBeanToolCallbackResolver 实现)动态解析它们。此选项使您能够将任何 Function 、 Supplier 、 Consumer 或 BiFunction Bean作为工具使用。Bean名称将用作工具名称,并且可以使用Spring框架中的 @Description 注解来为工具提供描述,模型将根据这些描述来理解何时以及如何调用工具。如果您不提供描述,则方法名称将用作工具描述。然而,强烈建议提供详细的描述,因为这对于模型理解工具的目的及其使用方式至关重要。未能提供良好的描述可能导致模型在应当使用工具时未使用,或错误地使用工具。
java
@Configuration(proxyBeanMethods = false)
class WeatherTools {

    WeatherService weatherService = new WeatherService();

    @Bean
    @Description("Get the weather in location")
    Function<WeatherRequest, WeatherResponse> currentWeather() {
        return weatherService;
    }

}| 某些类型不被支持。详情请参阅 函数工具限制 。 |
|---|
工具的输入参数的JSON模式将自动生成。您可以使用 @ToolParam 注解来提供关于输入参数的额外信息,如描述或参数是必需还是可选。默认情况下,所有输入参数都被视为必需。更多详细信息,请参见 JSON Schema 。
java
record WeatherRequest(@ToolParam(description = "The name of a city or a country") String location, Unit unit) {}此工具规范方法的缺点是不能保证类型安全,因为工具解析是在运行时完成的。为了减轻这一问题,您可以使用 @0 注解显式指定工具名称,并将其值存储在常量中,以便在聊天请求中使用它,而不是硬编码工具名称。
java
@Configuration(proxyBeanMethods = false)
class WeatherTools {

    public static final String CURRENT_WEATHER_TOOL = "currentWeather";

    @Bean(CURRENT_WEATHER_TOOL)
    @Description("Get the weather in location")
    Function<WeatherRequest, WeatherResponse> currentWeather() {
        ...
    }

}
向ChatClient添加工具
在使用动态指定方式时,您可以将工具名称(即函数bean名称)传递给 toolNames() 方法的 ChatClient 。 该工具仅对添加到的特定聊天请求可用。
java
ChatClient.create(chatModel)
    .prompt("What's the weather like in Copenhagen?")
    .toolNames("currentWeather")
    .call()
    .content();
向ChatClient添加默认工具
在使用动态规范方法时,您可以通过将工具名称传递给 ChatClient.Builder 方法,向 ChatClient.Builder 添加默认工具。如果同时提供了默认工具和运行时工具,那么运行时工具将完全覆盖默认工具。
默认工具在由相同 ChatClient.Builder 构建的所有 ChatClient 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具很有用,但如果不小心使用,也可能有危险,可能会导致在不应该的情况下使它们可用。 |
|---|
java
ChatModel chatModel = ...
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultToolNames("currentWeather")
    .build();
向ChatModel添加工具
在使用动态规范方法时,您可以将工具名称传递给用于调用 ChatModel 的 ToolCallingChatOptions 对象的 toolNames() 方法。该工具将仅对添加到的特定聊天请求可用。
java
ChatModel chatModel = ...
ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolNames("currentWeather")
    .build();
Prompt prompt = new Prompt("What's the weather like in Copenhagen?", chatOptions);
chatModel.call(prompt);
向ChatModel添加默认工具
在使用动态规范方法时,您可以在构建时通过将工具名称传递给用于创建 ChatModel 的 ToolCallingChatOptions 实例的 toolNames() 方法,向 ChatModel 添加默认工具。 如果同时提供了默认工具和运行时工具,那么运行时工具将完全覆盖默认工具。
默认工具在由该 ChatModel 实例执行的所有聊天请求中共享。它们对于跨不同聊天请求常用工具非常有用,但如果使用不当也可能存在危险,可能会导致在不应可用时使它们变得可用。 |
|---|
java
ChatModel chatModel = OllamaChatModel.builder()
    .ollamaApi(OllamaApi.builder().build())
    .defaultOptions(ToolCallingChatOptions.builder()
            .toolNames("currentWeather")
            .build())
    .build();
功能工具限制
以下类型目前不支持作为用作工具的函数的输入或输出类型:
- 原始类型
Optional- 集合类型(例如
List,Map,Array,Set) - 异步类型(例如
CompletableFuture,Future) - 响应式类型(例如
Flow,Mono,Flux).
基本类型和集合支持使用基于方法的工具规范方法。详情请参阅 将方法作为工具 。
工具规范
在Spring AI中,工具通过 Tool 接口进行建模。在前面的部分中,我们已经了解了如何使用Spring AI提供的内置支持,从方法和函数定义工具(参见 将方法作为工具 和 将函数作为工具 )。本节将更深入地探讨工具规范以及如何定制和扩展它以支持更多用例。
工具回调
ToolCallback 接口提供了一种定义工具的方法,该工具可被AI模型调用,包括定义和执行逻辑。当您想从头开始定义一个工具时,这是主要实现的接口。例如,您可以使用MCP客户端(采用模型上下文协议)定义一个 ToolCallback ,或定义一个 ChatClient (来构建模块化的代理应用程序)。
该接口提供了以下方法:
java
public interface ToolCallback {

    /**
     * Definition used by the AI model to determine when and how to call the tool.
     */
    ToolDefinition getToolDefinition();

    /**
     * Metadata providing additional information on how to handle the tool.
     */
    ToolMetadata getToolMetadata();

    /**
     * Execute tool with the given input and return the result to send back to the AI model.
     */
    String call(String toolInput);

    /**
     * Execute tool with the given input and context, and return the result to send back to the AI model.
     */
    String call(String toolInput, ToolContext tooContext);

}
Spring AI 为工具方法( MethodToolCallback )和工具函数( FunctionToolCallback )提供了内置实现。
工具定义
ToolDefinition 接口提供了AI模型所需的信息,以便了解工具的可用性,包括工具名称、描述和输入架构。每个 ToolCallback 实现必须提供一个 ToolDefinition 实例来定义工具。
该接口提供了以下方法:
java
public interface ToolDefinition {

    /**
     * The tool name. Unique within the tool set provided to a model.
     */
    String name();

    /**
     * The tool description, used by the AI model to determine what the tool does.
     */
    String description();

    /**
     * The schema of the parameters used to call the tool.
     */
    String inputSchema();

}| 参见 JSON Schema 以获取输入模式的更多详细信息。 |
|---|
数字 ToolDefinition.Builder 允许您使用默认实现 (DefaultToolDefinition) 构建一个 ToolDefinition 实例。
java
ToolDefinition toolDefinition = ToolDefinition.builder()
    .name("currentWeather")
    .description("Get the weather in location")
    .inputSchema("""
        {
            "type": "object",
            "properties": {
                "location": {
                    "type": "string"
                },
                "unit": {
                    "type": "string",
                    "enum": ["C", "F"]
                }
            },
            "required": ["location", "unit"]
        }
    """)
    .build();
方法工具定义
在从方法构建工具时, ToolDefinition 会自动为您生成。如果您更倾向于自己生成 ToolDefinition ,可以使用这个便捷的构建器。
java
Method method = ReflectionUtils.findMethod(DateTimeTools.class, "getCurrentDateTime");
ToolDefinition toolDefinition = ToolDefinitions.from(method);
由方法生成的 ToolDefinition 包含方法名作为工具名称,方法名作为工具描述,以及方法输入参数的JSON模式。如果方法使用 @Tool 进行了注解,则会从注解中(如果已设置)获取工具名称和描述。
| 查看 方法作为工具 以获取更多详细信息。 |
|---|
如需显式提供某些或全部属性,您可以使用 ToolDefinition.Builder 来构建自定义的 ToolDefinition 实例。
java
Method method = ReflectionUtils.findMethod(DateTimeTools.class, "getCurrentDateTime");
ToolDefinition toolDefinition = ToolDefinitions.builder(method)
    .name("currentDateTime")
    .description("Get the current date and time in the user's timezone")
    .inputSchema(JsonSchemaGenerator.generateForMethodInput(method))
    .build();
函数工具定义
在从函数构建工具时, ToolDefinition 会自动为您生成。当您使用 FunctionToolCallback.Builder 来构建 FunctionToolCallback 实例时,您可以提供将用于生成 ToolDefinition 的工具名称、描述和输入架构。有关更多详细信息,请参阅 函数作为工具 。
JSON模式
当向AI模型提供工具时,模型需要了解调用该工具的输入类型的架构。此架构用于理解如何调用工具及准备工具请求。Spring AI通过 JsonSchemaGenerator 类为工具的输入类型自动生成JSON架构提供了内置支持。该架构作为 ToolDefinition 的一部分提供。
参见 工具定义 以获取有关 ToolDefinition 的更多详细信息,以及如何将输入架构传递给它。 |
|---|
JsonSchemaGenerator 类在后台用于根据在 方法作为工具 和 函数作为工具 中描述的任何策略,为方法或函数的输入参数生成 JSON 模式。JSON 模式生成逻辑支持一系列注解,您可以在方法和函数的输入参数上使用这些注解来自定义最终的模式。
本节描述了在为工具的输入参数生成JSON模式时,您可以自定义的两个主要选项:描述和必填状态。
描述
除了为工具本身提供描述之外,您还可以为工具的输入参数提供描述。此描述可用于提供关于输入参数的关键信息,例如参数应采用的格式、允许的值等。这对于帮助模型理解输入架构及如何使用它非常有用。Spring AI 内置了对使用以下注解之一生成输入参数描述的支持:
@ToolParam(description = "…")来自Spring AI@JsonClassDescription(description = "…")来自 Jackson@JsonPropertyDescription(description = "…")来自 Jackson@Schema(description = "…")从 Swagger 获取。
此方法既适用于方法也适用于函数,并且您可以对其嵌套类型进行递归使用。
java
import java.time.LocalDateTime;
import java.time.format.DateTimeFormatter;
import org.springframework.ai.tool.annotation.Tool;
import org.springframework.ai.tool.annotation.ToolParam;
import org.springframework.context.i18n.LocaleContextHolder;

class DateTimeTools {

    @Tool(description = "Set a user alarm for the given time")
    void setAlarm(@ToolParam(description = "Time in ISO-8601 format") String time) {
        LocalDateTime alarmTime = LocalDateTime.parse(time, DateTimeFormatter.ISO_DATE_TIME);
        System.out.println("Alarm set for " + alarmTime);
    }

}
必需/可选
默认情况下,每个输入参数都被视为必需,这要求AI模型在调用工具时为其提供一个值。但是,您可以使用以下注解之一(按优先级顺序)将输入参数设为可选:
@ToolParam(required = false)来自Spring AI@JsonProperty(required = false)来自 Jackson@Schema(required = false)从 Swagger@Nullable来自Spring框架。
此方法既适用于方法也适用于函数,并且您可以对其嵌套类型进行递归使用。
java
class CustomerTools {

    @Tool(description = "Update customer information")
    void updateCustomerInfo(Long id, String name, @ToolParam(required = false) String email) {
        System.out.println("Updated info for customer with id: " + id);
    }

}
为输入参数定义正确的必填状态对于缓解幻觉风险并确保模型在调用工具时提供正确输入至关重要。在上一个示例中, email 参数是可选的,这意味着模型可以在不为它提供值的情况下调用工具。如果该参数是必需的,则模型在调用工具时必须为其提供一个值。如果没有值存在,模型可能会编造一个,从而导致幻觉。 |
|---|
结果转换
工具调用的结果通过使用 ToolCallResultConverter 进行序列化,然后返回给AI模型。 ToolCallResultConverter 接口提供了一种将工具调用的结果转换为 String 对象的方法。
该接口提供了以下方法:
java
@FunctionalInterface
public interface ToolCallResultConverter {

    /**
     * Given an Object returned by a tool, convert it to a String compatible with the
     * given class type.
     */
    String convert(@Nullable Object result, @Nullable Type returnType);

}
结果必须是可序列化的类型。默认情况下,结果使用Jackson( DefaultToolCallResultConverter )序列化为JSON,但您可以通过提供自定义的 ToolCallResultConverter 实现来定制序列化过程。
Spring AI 依赖于方法和函数工具中的 ToolCallResultConverter 。
方法工具调用结果转换
在使用声明式方法构建工具时,您可以通过设置 @Tool 注解的 resultConverter() 属性来提供自定义的 ToolCallResultConverter 以供工具使用。
java
class CustomerTools {

    @Tool(description = "Retrieve customer information", resultConverter = CustomToolCallResultConverter.class)
    Customer getCustomerInfo(Long id) {
        return customerRepository.findById(id);
    }

}
如果采用编程方式,您可以通过设置 SpringApplication 的 banner 属性来提供自定义的横幅 Banner 实例。
查看 方法作为工具 以获取更多详细信息。
函数工具调用结果转换
在使用编程方式从函数构建工具时,您可以通过设置 FunctionToolCallback.Builder 的 resultConverter() 属性来提供自定义的 ToolCallResultConverter 以供工具使用。
了解更多详情,请参见 函数作为工具 。
工具上下文
Spring AI支持通过 ToolContext API向工具传递额外的上下文信息。此功能使您能够提供额外的、用户提供的数据,这些数据可以在工具执行时与AI模型传递的工具参数一起使用。
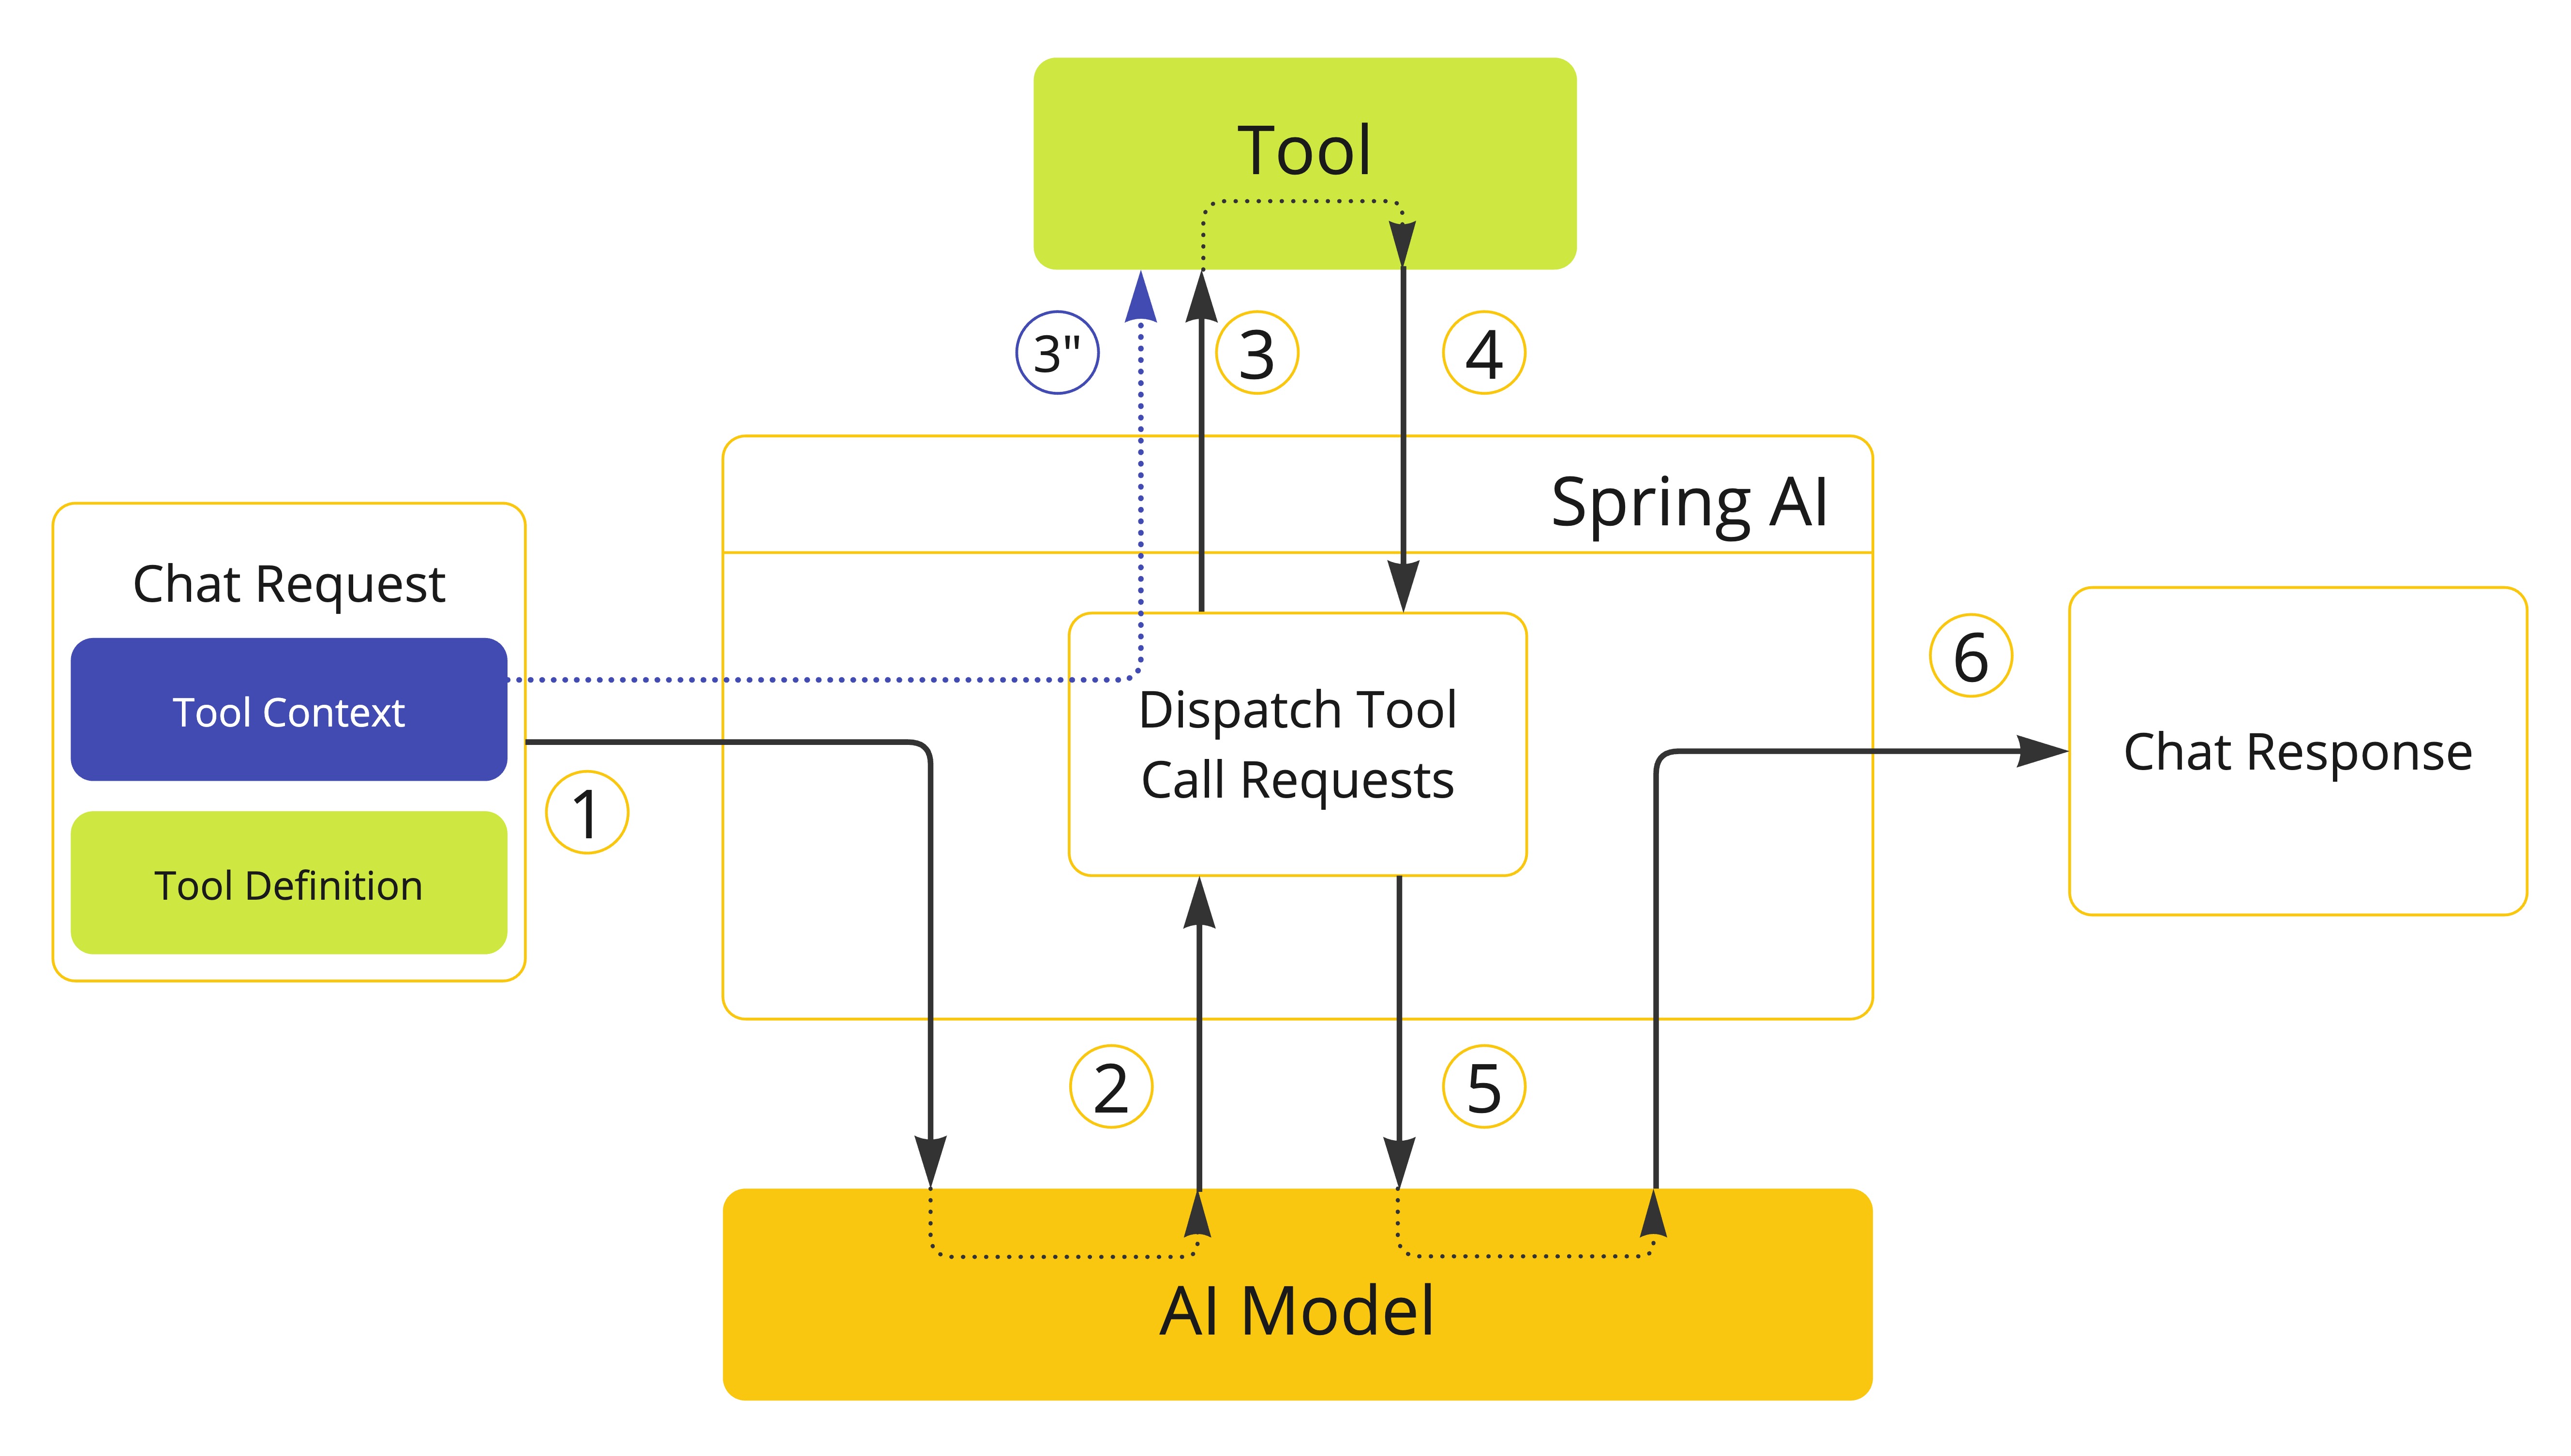
java
class CustomerTools {

    @Tool(description = "Retrieve customer information")
    Customer getCustomerInfo(Long id, ToolContext toolContext) {
        return customerRepository.findById(id, toolContext.getContext().get("tenantId"));
    }

}
数字 ToolContext 由用户在调用 ChatClient 时提供的数据填充。
java
ChatModel chatModel = ...

String response = ChatClient.create(chatModel)
        .prompt("Tell me more about the customer with ID 42")
        .tools(new CustomerTools())
        .toolContext(Map.of("tenantId", "acme"))
        .call()
        .content();

System.out.println(response);
AI模型不会接收到 ToolContext 中提供的任何数据。 |
|---|
同样,当直接调用 ChatModel 时,您可以定义工具上下文数据。
java
ChatModel chatModel = ...
ToolCallback[] customerTools = ToolCallbacks.from(new CustomerTools());
ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolCallbacks(customerTools)
    .toolContext(Map.of("tenantId", "acme"))
    .build();
Prompt prompt = new Prompt("Tell me more about the customer with ID 42", chatOptions);
chatModel.call(prompt);
如果在默认选项和运行时选项中都设置了 toolContext 选项,那么最终的 ToolContext 将是两者的合并结果, 其中运行时选项优先于默认选项。
直接返回
默认情况下,工具调用的结果会作为响应发送回模型。随后,模型可以使用该结果来继续对话。
在某些情况下,您可能希望直接将结果返回给调用者,而不是将其发送回模型。例如,如果您构建了一个依赖于RAG工具的代理,您可能希望直接将结果返回给调用者,而不是将其发送回模型进行不必要的后处理。或者,您可能拥有某些工具,这些工具应当终止代理的推理循环。
每个 ToolCallback 实现都可以定义工具调用的结果应该是直接返回给调用者还是发送回模型。默认情况下,结果会发送回模型。但您可以针对每个工具更改此行为。
负责管理工具执行生命周期的 ToolCallingManager ,负责处理与工具相关的 returnDirect 属性。如果该属性设置为 true ,则直接将工具调用的结果返回给调用者。否则,结果会被发送回模型。
如果同时请求多个工具调用,必须将 async 属性设置为 true ,以便所有工具直接将结果返回给调用者。否则,结果将被发送回模型。 |
|---|
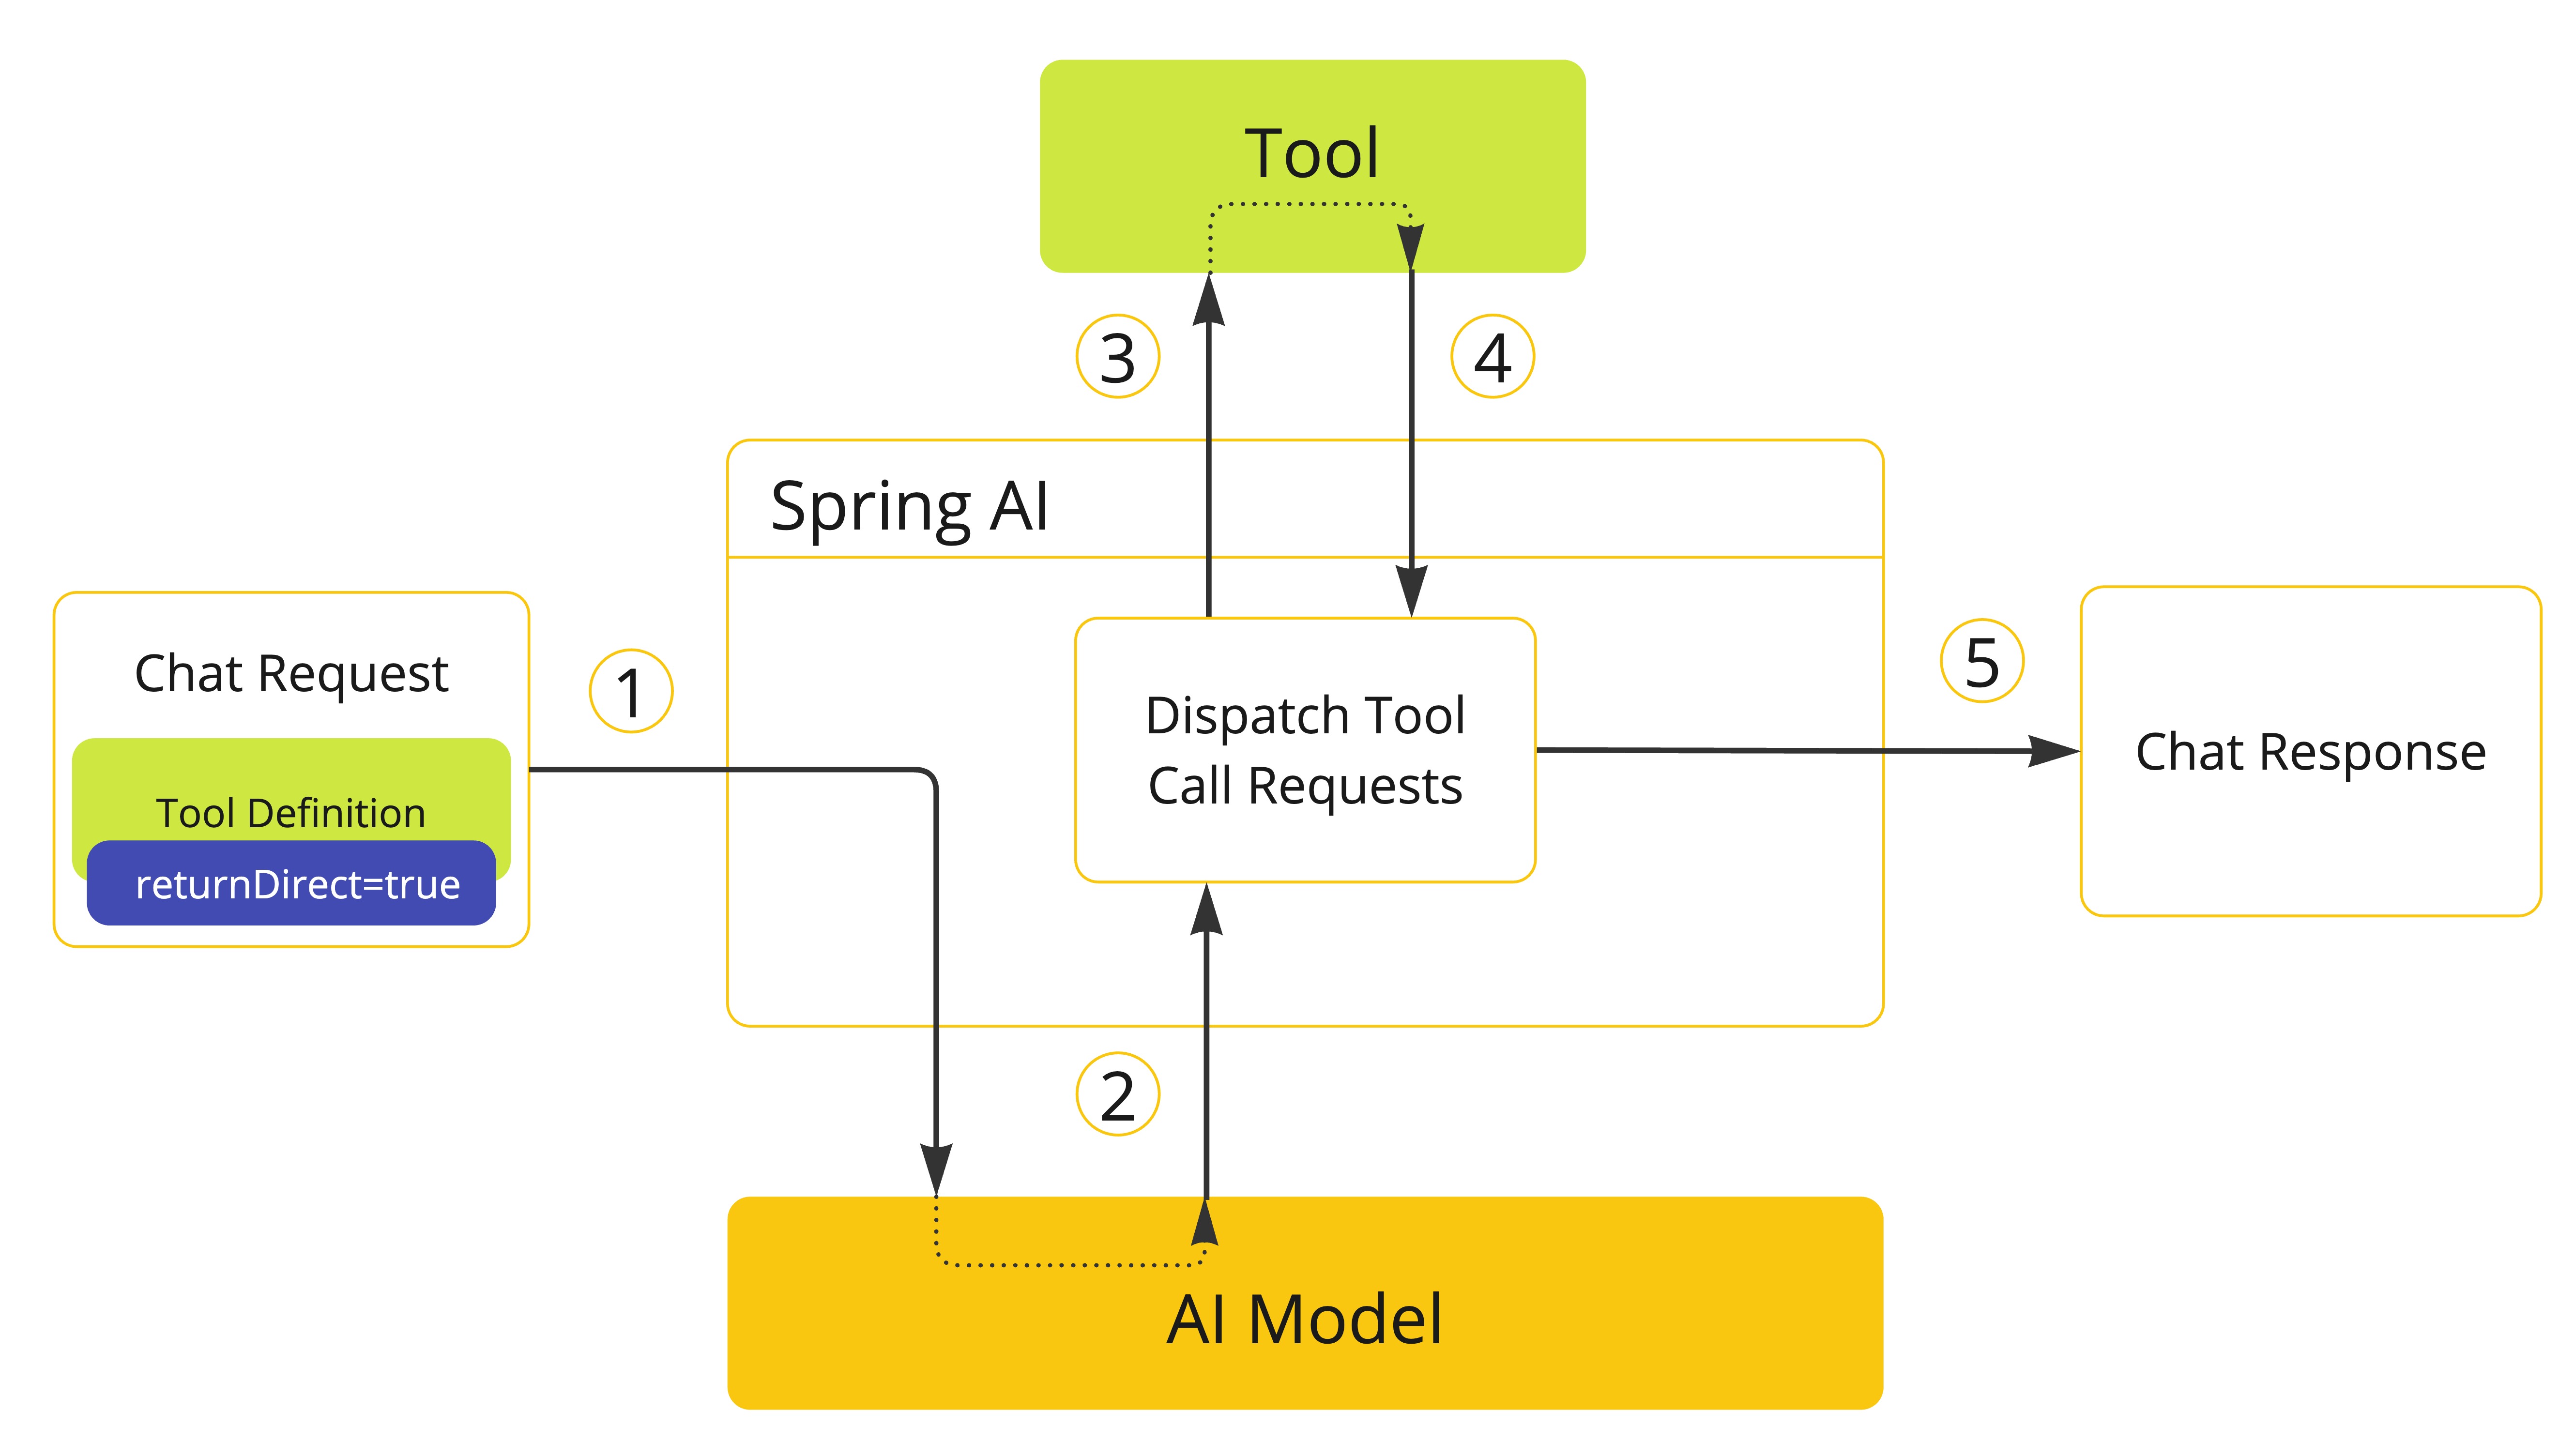
- 当我们要使一个工具对模型可用时,我们将其定义包含在聊天请求中。如果我们希望工具执行的结果直接返回给调用者,我们将
silent属性设置为true。 - 当模型决定调用工具时,它会发送一个响应,包含工具名称和基于定义的模式的输入参数。
- 这个应用负责使用工具名来识别并执行工具,并带有提供的输入参数。
- 工具调用的结果将由应用程序处理。
- 应用程序直接将工具调用结果发送给调用者,而不是返回到模型。
方法直接返回
在使用声明式方法构建工具时,您可以通过将 returnDirect 属性的 @Tool 注解设置为 true ,来标记一个工具直接将结果返回给调用者。
java
class CustomerTools {

    @Tool(description = "Retrieve customer information", returnDirect = true)
    Customer getCustomerInfo(Long id) {
        return customerRepository.findById(id);
    }

}
如果采用编程方式,可以通过 returnDirect 接口设置 returnDirect 属性,并将其传递给 MethodToolCallback.Builder 。
java
ToolMetadata toolMetadata = ToolMetadata.builder()
    .returnDirect(true)
    .build();
查看 方法作为工具 以获取更多详细信息。
函数直接返回
在使用编程方式从函数构建工具时,您可以透过 Builder 接口设置 stepSize 属性,并将其传递给 StepFunction 。
java
ToolMetadata toolMetadata = ToolMetadata.builder()
    .returnDirect(true)
    .build();
了解更多详情,请参见 函数作为工具 。
工具执行
工具执行是使用提供的输入参数调用工具并返回结果的过程。工具执行由 ToolCallingManager 接口处理,该接口负责管理工具执行的生命周期。
java
public interface ToolCallingManager {

    /**
     * Resolve the tool definitions from the model's tool calling options.
     */
    List<ToolDefinition> resolveToolDefinitions(ToolCallingChatOptions chatOptions);

    /**
     * Execute the tool calls requested by the model.
     */
    ToolExecutionResult executeToolCalls(Prompt prompt, ChatResponse chatResponse);

}
如果您正在使用Spring AI Spring Boot Starters中的任何一项, DefaultToolCallingManager 是 ToolCallingManager 接口的自动配置实现。您可以通过提供自定义的 ToolCallingManager Bean来定制工具执行行为。
java
@Bean
ToolCallingManager toolCallingManager() {
    return ToolCallingManager.builder().build();
}
默认情况下,Spring AI会为您从每个 ChatModel 实现内部透明地管理工具执行生命周期。但您可以选择不使用此行为,并自行控制工具执行。本节描述这两种场景。
框架控制的工具执行
在使用默认行为时,Spring AI将自动拦截来自模型的任何工具调用请求,调用工具并将结果返回给模型。所有这些都由每个 ChatModel 实现使用 ToolCallingManager 为您透明地完成。
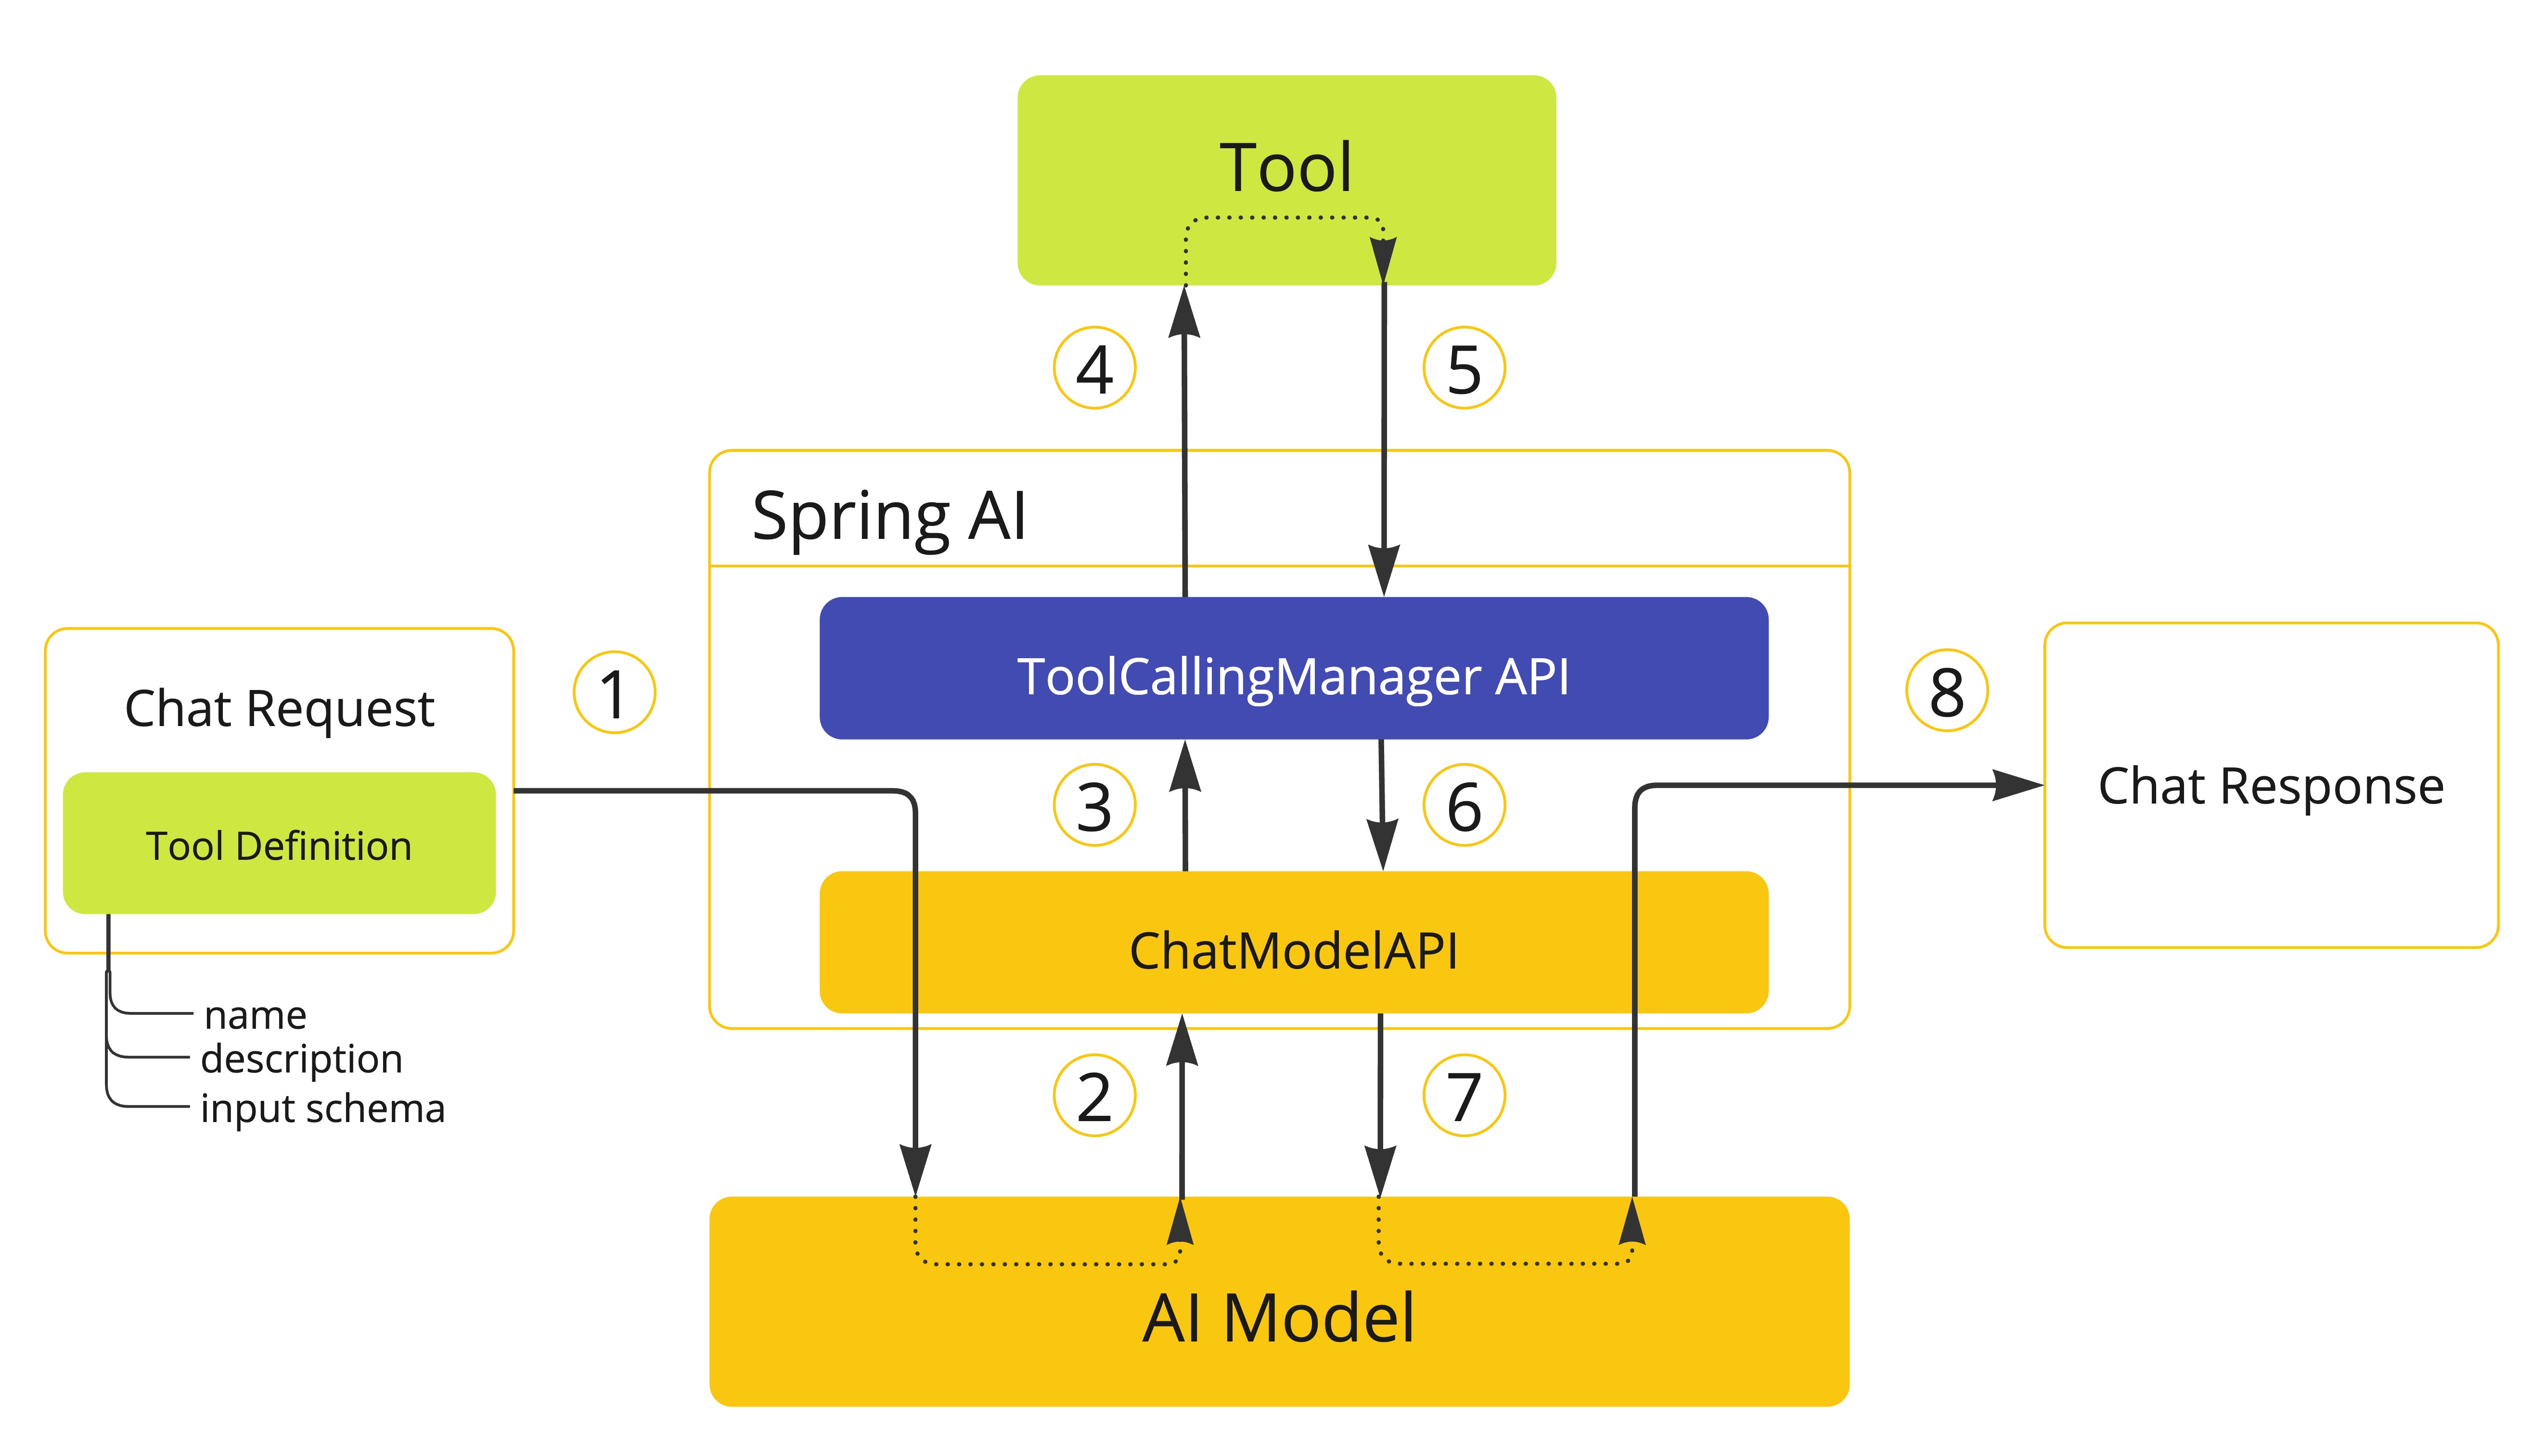
- 当我们希望将一个工具提供给模型时,我们会在聊天请求中包含它的定义(
Prompt)并调用ChatModelAPI,该API将请求发送给AI模型。 - 当模型决定调用一个工具时,它会发送一个响应(
ChatResponse),其中包含工具名称及按照定义的模式建模的输入参数。 - 数字
ChatModel向ToolCallingManagerAPI发送工具调用请求。 - 数字
ToolCallingManager用于标识要调用的工具并使用提供的输入参数执行它。 - 工具调用的结果返回到
ToolCallingManager处。 - 数字
ToolCallingManager将工具执行结果返回给ChatModel。 - 数字
ChatModel将工具执行结果返回给AI模型(ToolResponseMessage)。 - AI模型利用工具调用结果作为附加上下文生成最终响应,并通过
ChatClient将其发送回调用者(ChatResponse)。
| 目前,与模型之间关于工具执行的内部消息交换并未向用户公开。如需访问这些消息,您应采用用户控制的工具执行方法。 |
|---|
决定工具调用是否符合执行条件的逻辑由 TaskExecutorDecider 接口处理。默认情况下,工具执行的符合条件是通过检查 TaskExecution 的 enabled 属性是否设置为 true (默认值),以及 TaskContext 是否包含任何工具调用来确定的。
java
public class DefaultToolExecutionEligibilityPredicate implements ToolExecutionEligibilityPredicate {

    @Override
    public boolean test(ChatOptions promptOptions, ChatResponse chatResponse) {
        return ToolCallingChatOptions.isInternalToolExecutionEnabled(promptOptions) && chatResponse != null
                && chatResponse.hasToolCalls();
    }

}
在创建 ChatModel bean时,您可以提供自定义的 ToolExecutionEligibilityPredicate 实现。
使用ToolCallAdvisor控制的工具执行
作为框架控制工具执行的替代方案,您可以使用 ToolCallAdvisor 作为 顾问链 的一部分来实现工具调用。这种方法提供了几个优势:
- 可观察性: 链中的其他顾问可以拦截并观察每次工具调用的迭代
- 与聊天记忆集成: 无缝对接聊天记忆助手,实现对话历史管理
- 可扩展性: 顾问可以扩展以自定义工具调用行为
数字 ToolCallAdvisor 实现了工具调用循环,并禁用了模型内部的工具执行。当模型请求工具调用时,顾问执行该工具并将结果返回给模型,如此继续直至不再需要更多的工具调用。
java
var toolCallAdvisor = ToolCallAdvisor.builder()
    .toolCallingManager(toolCallingManager)
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300)
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(toolCallAdvisor)
    .build();

String response = chatClient.prompt("What day is tomorrow?")
    .tools(new DateTimeTools())
    .call()
    .content();
配置选项
数字 ToolCallAdvisor.Builder 支持以下配置选项:
toolCallingManager: 用于执行工具调用的ToolCallingManager实例。如果未提供,将使用默认实例。advisorOrder: 顾问在链中应用的顺序。必须在BaseAdvisor.HIGHEST_PRECEDENCE和BaseAdvisor.LOWEST_PRECEDENCE之间。conversationHistoryEnabled: 控制顾问在工具调用迭代期间是否在内部维护对话历史。默认值为true。
会话历史管理
默认情况下( conversationHistoryEnabled=true ), ToolCallAdvisor 在工具调用迭代期间内部维护完整的对话历史。每次后续的LLM调用都包含所有之前的消息。
使用 .disableMemory() 方法来禁用内部对话历史管理。当禁用时,只有上一个工具响应消息会传递给下一次迭代。这在与已管理对话历史的聊天记忆顾问集成时非常有用:
java
var toolCallAdvisor = ToolCallAdvisor.builder()
    .toolCallingManager(toolCallingManager)
    .disableMemory()  // Let ChatMemory handle history
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 300)
    .build();

var chatMemoryAdvisor = MessageChatMemoryAdvisor.builder(chatMemory)
    .advisorOrder(BaseAdvisor.HIGHEST_PRECEDENCE + 200)  // Before ToolCallAdvisor
    .build();

var chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(chatMemoryAdvisor, toolCallAdvisor)
    .build();
直接返回
代码 ToolCallAdvisor 支持“直接返回”特性,允许工具绕过LLM,直接将结果返回给客户端。当工具执行具有 returnDirect=true 时,顾问会跳出工具调用循环,并直接返回工具结果。
有关 ToolCallAdvisor 的更多详细信息,请参阅 递归顾问 - ToolCallAdvisor 。
用户控制的工具执行
有时您可能希望亲自控制工具执行的生命周期。您可以通过将 spring-boot-starter-actuator 的 management.endpoint.shutdown.enabled 属性设置为 true 来实现这一点。
当您使用此选项调用 ChatModel 时,工具执行将委托给调用者,使您能够完全控制工具执行的生命周期。您有责任在 ChatResponse 中检查工具调用,并使用 ToolCallingManager 执行它们。
以下示例展示了用户控制的工具执行方法的最小实现:
java
ChatModel chatModel = ...
ToolCallingManager toolCallingManager = ToolCallingManager.builder().build();

ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolCallbacks(new CustomerTools())
    .internalToolExecutionEnabled(false)
    .build();
Prompt prompt = new Prompt("Tell me more about the customer with ID 42", chatOptions);

ChatResponse chatResponse = chatModel.call(prompt);

while (chatResponse.hasToolCalls()) {
    ToolExecutionResult toolExecutionResult = toolCallingManager.executeToolCalls(prompt, chatResponse);

    prompt = new Prompt(toolExecutionResult.conversationHistory(), chatOptions);

    chatResponse = chatModel.call(prompt);
}

System.out.println(chatResponse.getResult().getOutput().getText());
在选择用户控制的工具执行方式时,我们建议使用 ToolCallingManager 来管理工具调用操作。这样,您可以充分利用Spring AI对工具执行提供的内置支持。但是,这并不妨碍您实现自己的工具执行逻辑。 |
|---|
下一个示例展示了结合使用用户控制的工具执行方法与 ChatMemory API的最小实现:
java
ToolCallingManager toolCallingManager = DefaultToolCallingManager.builder().build();
ChatMemory chatMemory = MessageWindowChatMemory.builder().build();
String conversationId = UUID.randomUUID().toString();

ChatOptions chatOptions = ToolCallingChatOptions.builder()
    .toolCallbacks(ToolCallbacks.from(new MathTools()))
    .internalToolExecutionEnabled(false)
    .build();
Prompt prompt = new Prompt(
        List.of(new SystemMessage("You are a helpful assistant."), new UserMessage("What is 6 * 8?")),
        chatOptions);
chatMemory.add(conversationId, prompt.getInstructions());

Prompt promptWithMemory = new Prompt(chatMemory.get(conversationId), chatOptions);
ChatResponse chatResponse = chatModel.call(promptWithMemory);
chatMemory.add(conversationId, chatResponse.getResult().getOutput());

while (chatResponse.hasToolCalls()) {
    ToolExecutionResult toolExecutionResult = toolCallingManager.executeToolCalls(promptWithMemory,
            chatResponse);
    chatMemory.add(conversationId, toolExecutionResult.conversationHistory()
        .get(toolExecutionResult.conversationHistory().size() - 1));
    promptWithMemory = new Prompt(chatMemory.get(conversationId), chatOptions);
    chatResponse = chatModel.call(promptWithMemory);
    chatMemory.add(conversationId, chatResponse.getResult().getOutput());
}

UserMessage newUserMessage = new UserMessage("What did I ask you earlier?");
chatMemory.add(conversationId, newUserMessage);

ChatResponse newResponse = chatModel.call(new Prompt(chatMemory.get(conversationId)));
异常处理
当工具调用失败时,异常会以 ToolExecutionException 的形式传播,可以捕获它来处理错误。 使用 ToolExecutionExceptionProcessor 可以处理 ToolExecutionException 的两种结果:要么生成错误消息回传给AI模型,要么抛出异常由调用者处理。
java
@FunctionalInterface
public interface ToolExecutionExceptionProcessor {

    /**
     * Convert an exception thrown by a tool to a String that can be sent back to the AI
     * model or throw an exception to be handled by the caller.
     */
    String process(ToolExecutionException exception);

}
如果您正在使用Spring AI Spring Boot Starters中的任何一个, DefaultToolExecutionExceptionProcessor 是 ToolExecutionExceptionProcessor 接口的自动配置实现。默认情况下, RuntimeException 的错误信息会被发送回模型,而已检查的异常和错误(例如, IOException , OutOfMemoryError )总是被抛出。通过 DefaultToolExecutionExceptionProcessor 构造函数,您可以将 alwaysThrow 属性设置为 true 或 false 。如果 true ,则会抛出异常,而不是将错误信息发送回模型。
您可以使用 `spring.ai.tools.throw-exception-on-error 属性来控制 DefaultToolExecutionExceptionProcessor bean的行为:
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.tools.throw-exception-on-error | 如果值为 true ,工具调用错误会作为异常抛出,由调用者处理。如果值为 false ,错误会被转换为消息并发送回AI模型,使模型能够处理并响应错误。 | false |
java
@Bean
ToolExecutionExceptionProcessor toolExecutionExceptionProcessor() {
    return new DefaultToolExecutionExceptionProcessor(true);
}
如果您定义了自己的 ToolCallback 实现,请确保在工具执行逻辑中,当 call() 方法中发生错误时抛出一个 ToolExecutionException 。 |
|---|
数字 ToolExecutionExceptionProcessor 被默认的 ToolCallingManager ( DefaultToolCallingManager )在工具执行期间内部使用以处理异常。有关工具执行生命周期的更多详细信息,请参阅 工具执行 。
工具分辨率
向模型传递工具的主要方法是在调用 ToolCallback (s)时提供 ChatClient 或 ChatModel , 使用 方法作为工具 和 函数作为工具 中描述的一种策略。
然而,Spring AI同时也支持在运行时动态解析工具,使用的是 ToolCallbackResolver 接口。
java
public interface ToolCallbackResolver {

    /**
     * Resolve the {@link ToolCallback} for the given tool name.
     */
    @Nullable
    ToolCallback resolve(String toolName);

}
在采用此方法时:
- 在客户端,您需要向
ChatClient或ChatModel提供工具名称,而不是向ToolCallback(s)提供。 - 在服务器端,一个
ToolCallbackResolver实现负责将工具名称解析为对应的ToolCallback实例。
Spring AI默认依赖于一个 DelegatingToolCallbackResolver ,该对象将工具解析委托给一系列 ToolCallbackResolver 实例:
- 类型为
SpringBeanToolCallbackResolver的工具从Spring beans中解析类型为Function、Supplier、Consumer或BiFunction的工具。更多详细信息,请参见 动态规范:@Bean。 - 数字
StaticToolCallbackResolver从一个静态的ToolCallback实例列表中解析工具。当使用Spring Boot自动配置时,此解析器会自动配置应用程序上下文中定义的所有类型为ToolCallback的bean。
如果您依赖于Spring Boot自动配置,可以通过提供自定义的 ToolCallbackResolver bean来定制解析逻辑。
java
@Bean
ToolCallbackResolver toolCallbackResolver(List<FunctionCallback> toolCallbacks) {
    StaticToolCallbackResolver staticToolCallbackResolver = new StaticToolCallbackResolver(toolCallbacks);
    return new DelegatingToolCallbackResolver(List.of(staticToolCallbackResolver));
}
数字 ToolCallbackResolver 被 ToolCallingManager 框架内部使用,以便在运行时动态解析工具,同时支持 框架控制的工具执行 和 用户控制的工具执行 。
工具参数增强
Spring AI为工具输入模式的 动态增强 提供了实用程序,可附加额外的参数。这允许在不修改底层工具实现的情况下捕获模型的额外信息,如推理或元数据。
常见使用场景包括:
- 内部思考/推理: 在执行工具之前,捕获模型的逐步推理过程
- 记忆增强: 提取洞察以存储至长期记忆
- 分析与跟踪: 收集元数据、用户意图或使用模式
- 多智能体协调: 传递智能体标识符或协调信号
快速开始
定义增强参数 为一个Java Record:
java
public record AgentThinking(
    @ToolParam(description = "Your reasoning for calling this tool", required = true)
    String innerThought,

    @ToolParam(description = "Confidence level (low, medium, high)", required = false)
    String confidence
) {}
将您的工具 包装在 AugmentedToolCallbackProvider 中:
java
AugmentedToolCallbackProvider<AgentThinking> provider = AugmentedToolCallbackProvider
    .<AgentThinking>builder()
    .toolObject(new MyTools())  // Your @Tool annotated class
    .argumentType(AgentThinking.class)
    .argumentConsumer(event -> {
        AgentThinking thinking = event.arguments();
        log.info("Tool: {} | Reasoning: {}", event.toolDefinition().name(), thinking.innerThought());
    })
    .removeExtraArgumentsAfterProcessing(true)
.build();与ChatClient配合使用:
java
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultToolCallbacks(provider)
    .build();
LLM会看到带有您附加字段的增强模式。您的消费者将接收到 AgentThinking 记录,而原始工具仅接收其预期的参数。
核心组件
AugmentedToolCallbackProvider<T>- 包装工具对象或提供者,为所有工具添加指定的记录类型AugmentedToolCallback<T>- 封装单个ToolCallback实例AugmentedArgumentEvent<T>- 包含toolDefinition(),rawInput(), 和arguments()对于消费者ToolInputSchemaAugmenter- 架构操作的低级实用工具
配置
removeExtraArgumentsAfterProcessing 选项控制是否将增强参数传递给原始工具:
true(默认)- 在调用工具前移除增强参数false- 在输入中保留增强的参数(如果工具可以忽略额外字段)
可观察性
工具调用包含使用spring.ai.tool观察的可观察性支持,用于测量完成时间和传播跟踪信息。参见 工具调用可观察性 。
可选地,Spring AI能够导出工具调用的参数和结果作为span属性,出于敏感性原因,默认禁用。详细信息: 工具调用参数及结果数据 。
日志
工具调用功能的所有主要操作都会被记录在 DEBUG 级别。您可以通过将日志级别设置为 DEBUG ,针对 org.springframework.ai 包来启用日志记录。
模型上下文协议(MCP)
| 初次接触MCP? 请从我们的 MCP入门指南 开始,了解快速介绍和实战示例。 |
|---|
模型上下文协议(MCP)是一种标准化协议,使AI模型能够以结构化方式与外部工具和资源进行交互。 把它想象成连接AI模型与现实世界的桥梁——使它们能够通过一致的接口访问数据库、API、文件系统和其他外部服务。 它支持多种传输机制,以适应不同环境的灵活性。
MCP Java SDK (模型上下文协议的Java实现) 提供了模型上下文协议的Java实现,通过同步和异步通信模式支持与AI模型及工具的标准交互。
Spring AI 通过专用的 Boot Starters 和 MCP Java 注解全面支持 MCP,使得构建能够无缝连接到外部系统的复杂人工智能应用程序变得前所未有的简单。 这意味着 Spring 开发者可以参与 MCP 生态系统的两端——创建使用 MCP 服务器的人工智能应用,以及构建向更广泛的人工智能社区暴露基于 Spring 服务的 MCP 服务器。 使用 Spring Initializer 初始化带有 MCP 支持的人工智能应用。
Java SDK架构
| 本节提供 MCP Java SDK架构 的概述。 关于Spring AI MCP集成,请参阅 Spring AI MCP Boot Starters 文档。 |
|---|
Java MCP 实现遵循三层架构,以分离关注点,确保可维护性和灵活性:

图1. MCP堆栈架构
客户端/服务器层(顶层)
顶层负责主要的应用逻辑和协议操作:
- McpClient - 管理客户端操作和服务器连接
- Mcp服务器 - 处理服务器端协议操作和客户端请求
- 这两个组件都利用了下方的会话层来进行通信管理。
会话层(中层)
中间层负责管理通信模式并维护连接状态:
- McpSession - 核心会话管理接口
- McpClientSession - 针对客户端的会话实现
- Mcp服务器会话 - 服务器特定的会话实现
传输层(底部)
最底层负责实际的消息传输和序列化处理:
- McpTransport - 管理JSON-RPC消息的序列化与反序列化
- 支持多种传输实现(STDIO、HTTP/SSE、可流式处理的HTTP等)。
- 为所有高级通信提供基础支持
| MCP客户端 | |
|---|---|
| MCP客户端是模型上下文协议(MCP)架构中的一个关键组件,负责与MCP服务器建立及管理连接。它实现了协议的客户端部分,处理包括: - 协议版本协商,确保与服务器的兼容性 - 功能协商以确定可用特性 - 消息传输与JSON-RPC通信 - 工具发现与执行 - 资源访问与管理 - 系统交互提示 - 可选功能: - 根管理 - 采样支持 - 同步和异步操作 - 传输选项: - 基于 Stdio 的进程间通信传输 - 基于 Java HttpClient 的 SSE 客户端传输 - WebFlux SSE 客户端传输,用于响应式 HTTP 流式传输 | 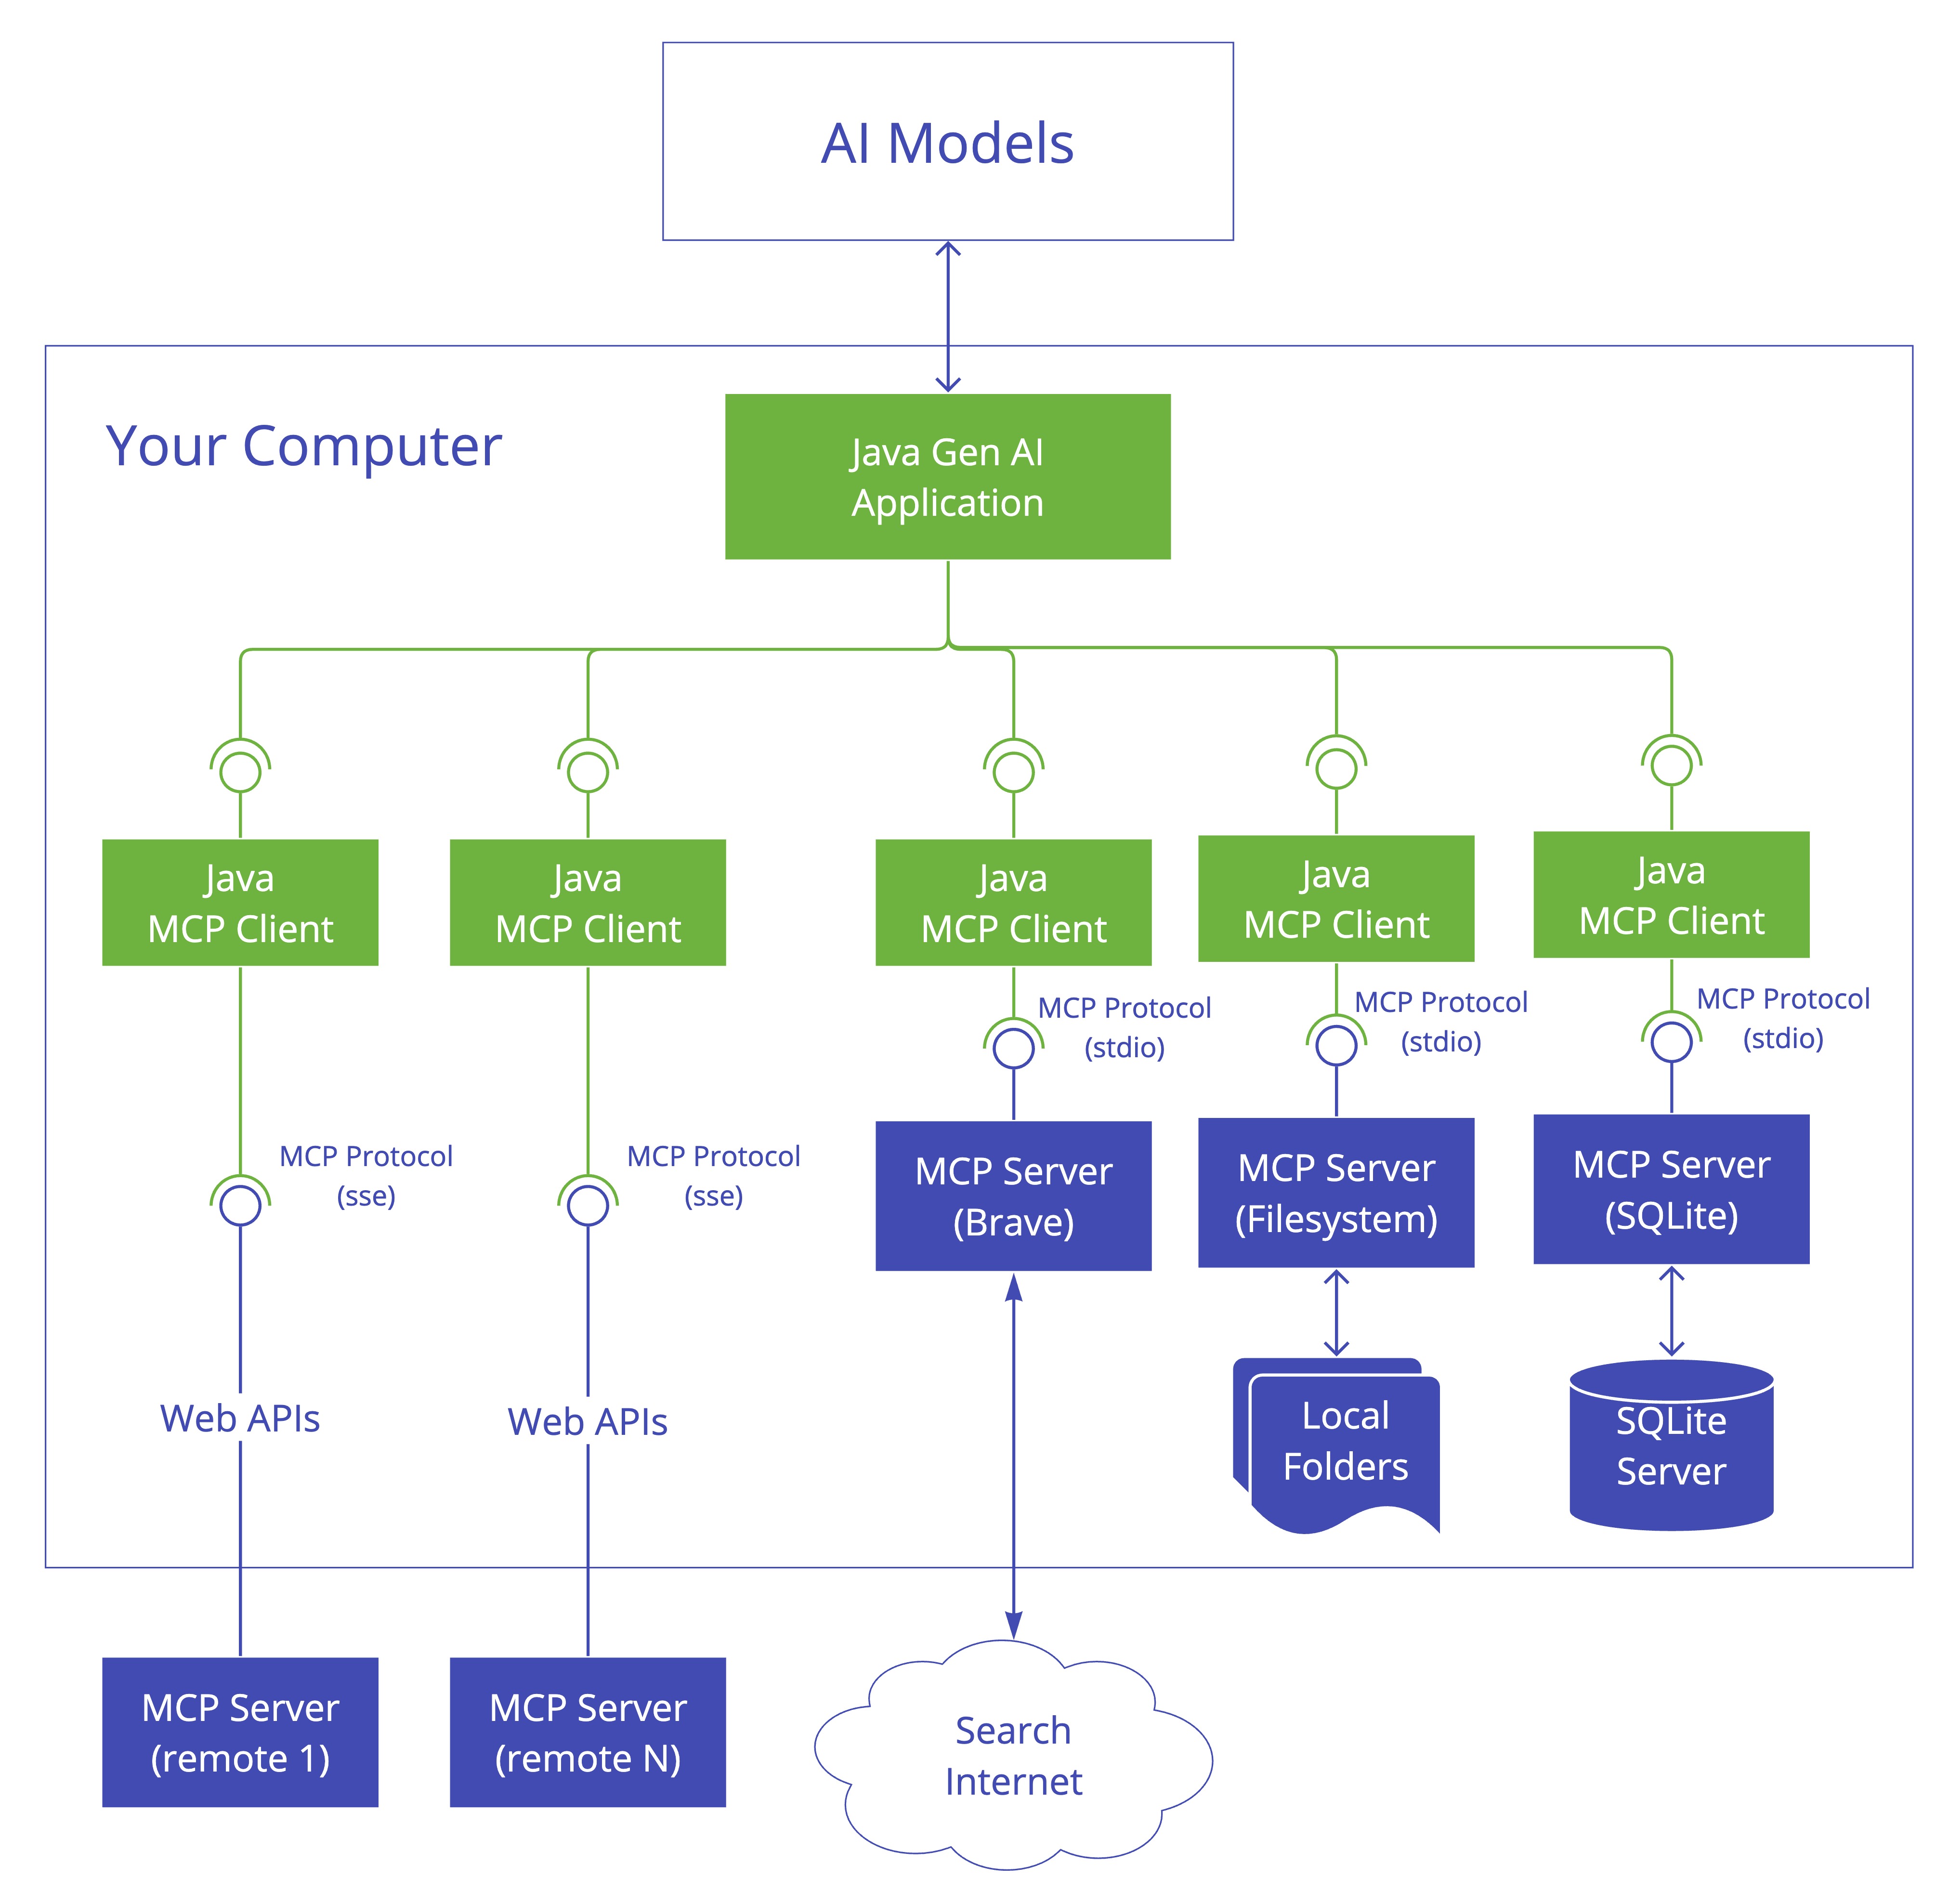 |
| MCP 服务器 | |
|---|---|
| MCP 服务器是模型上下文协议(MCP)架构中的基础组件,为客户端提供工具、资源和功能。它实现了该协议的服务器端部分,负责: - 服务器端协议操作实现 - 工具暴露与发现 - 基于 URI 的资源管理 - 提示模板的提供与处理 - 与客户端的能力协商 - 结构化日志与通知 - 并发客户端连接管理 - 同步与异步 API 支持 - 传输实现: - Stdio、Streamable-HTTP、Stateless Streamable-HTTP、SSE | 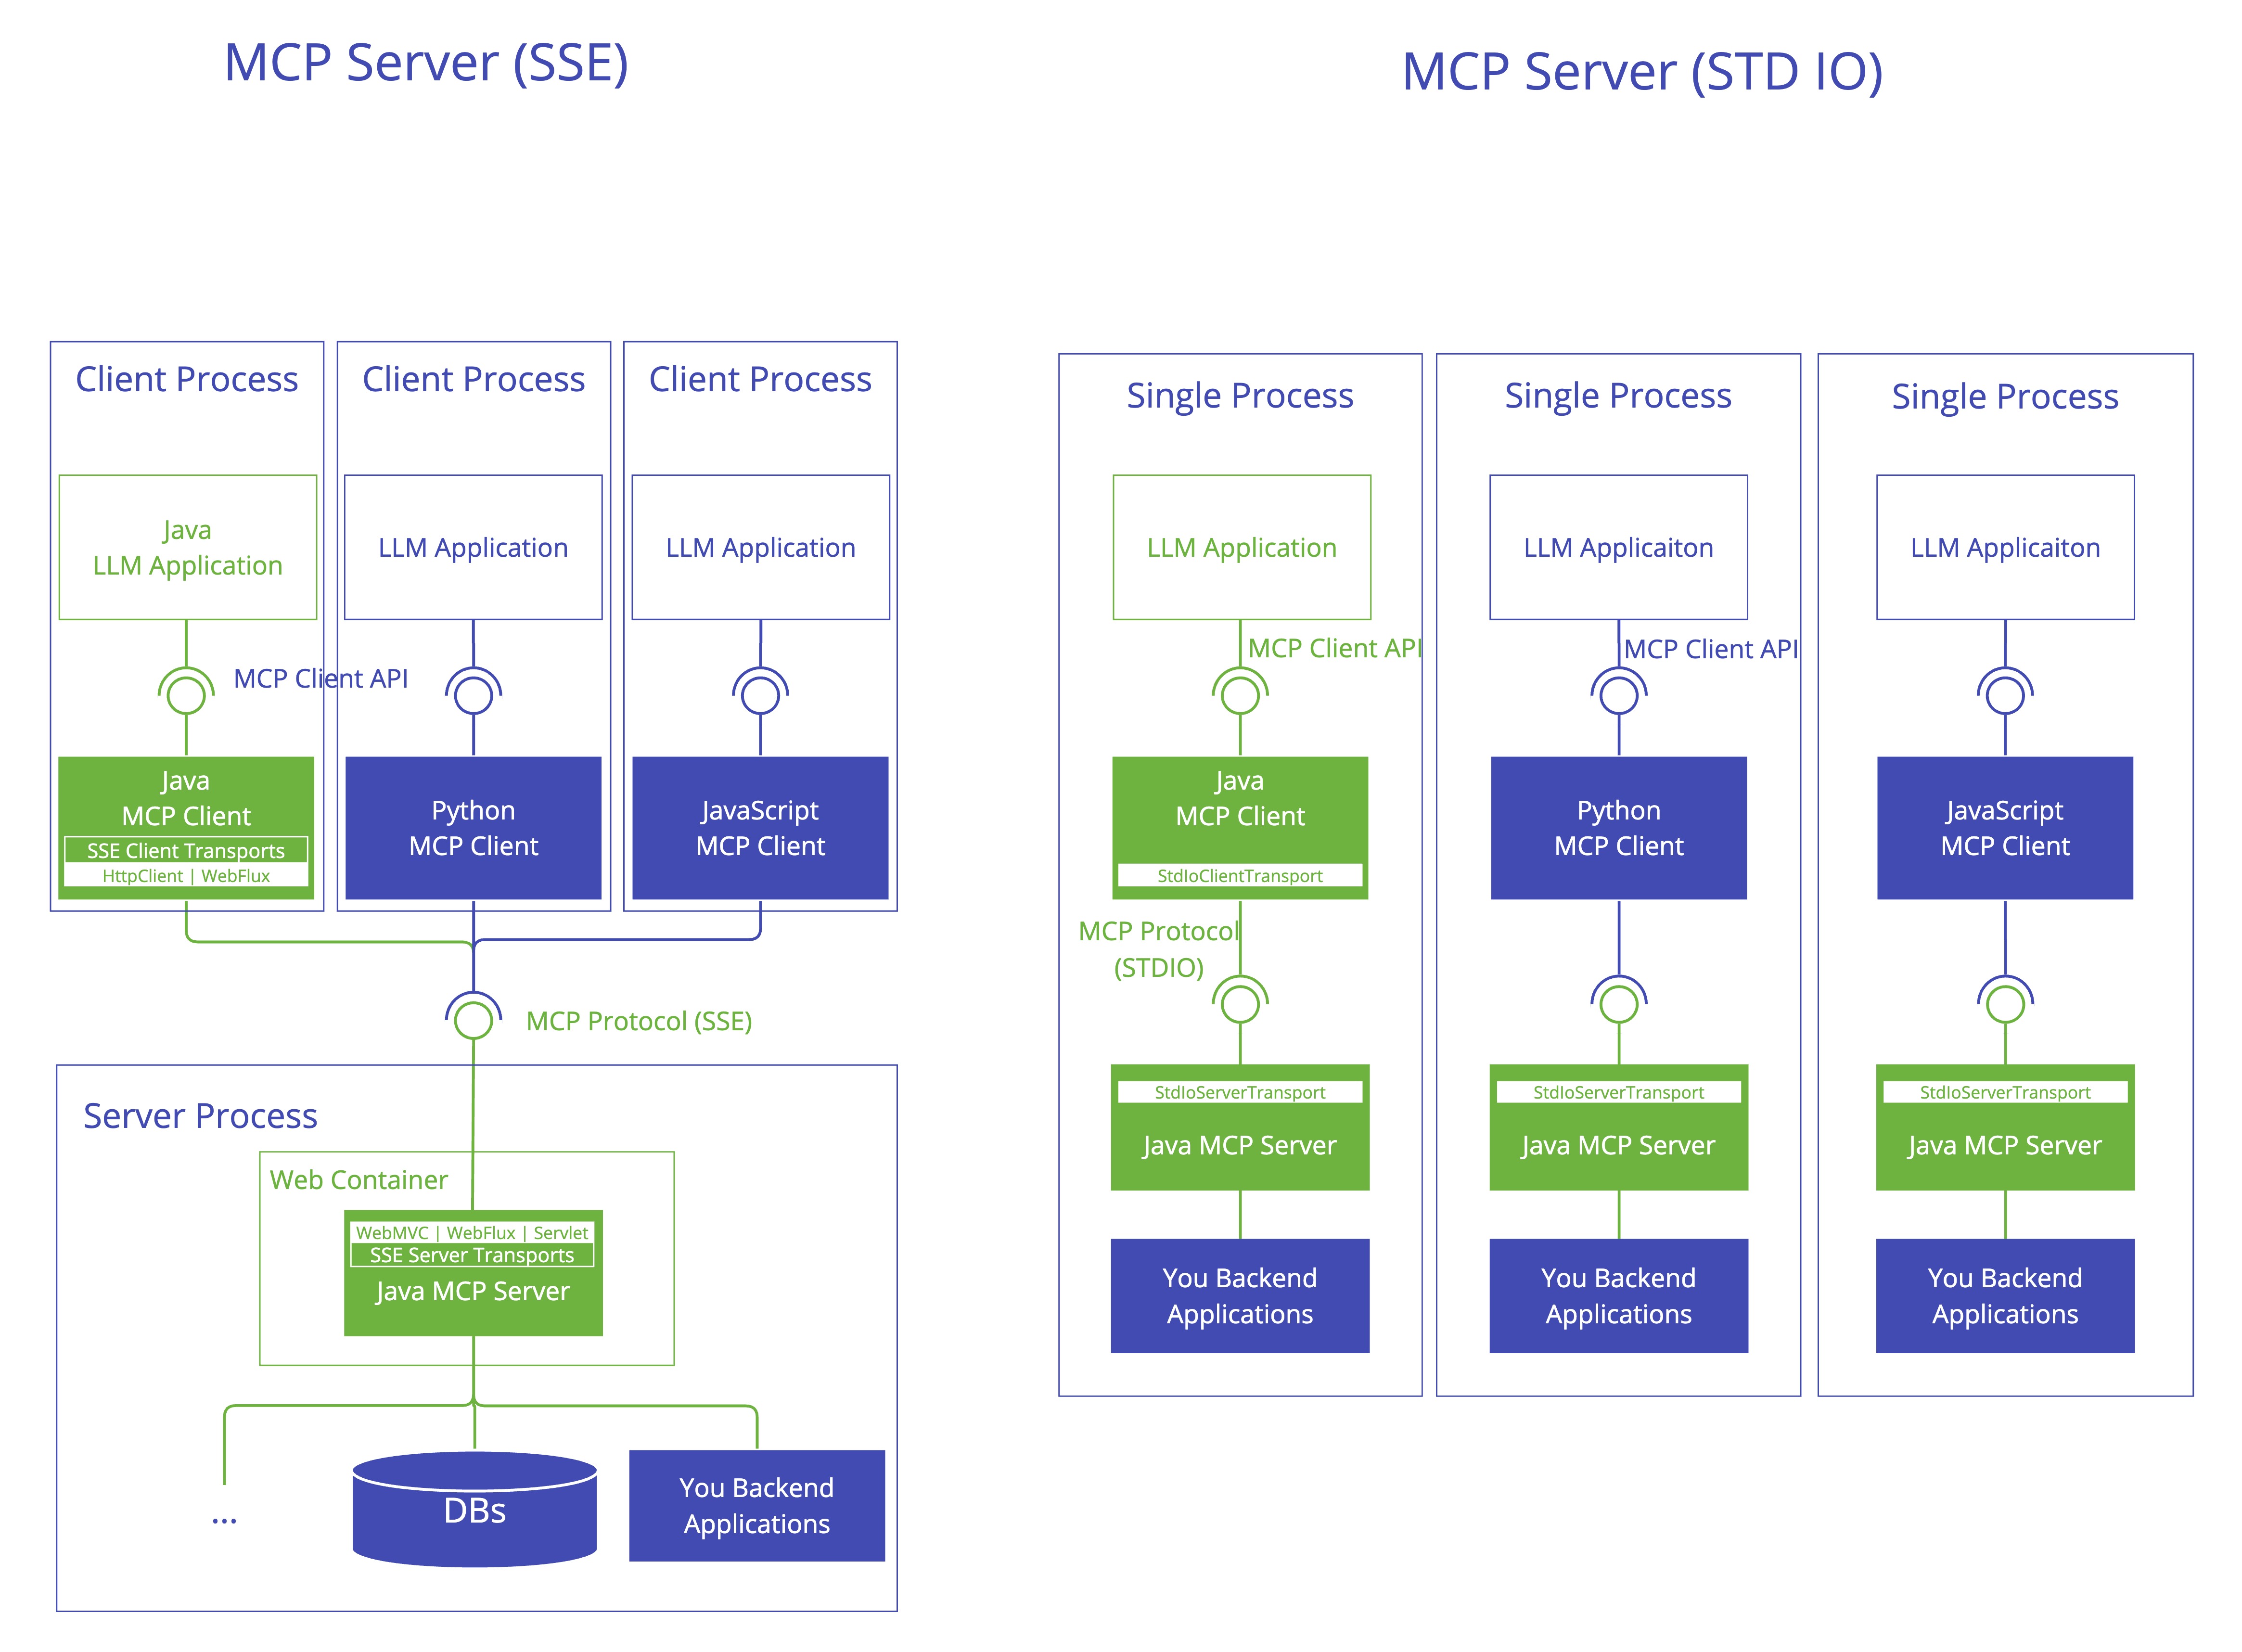 |
有关详细实施指导,使用低级MCP客户端/服务器API,请参阅 MCP Java SDK文档 。 对于使用Spring Boot进行的简化设置,请使用下文所述的MCPStarters。
Spring AI MCP 集成
Spring AI 通过以下 Spring Boot Starter 提供 MCP 集成:
客户端Starters
spring-ai-starter-mcp-client- 核心Starters,提供STDIO、基于 Servlet 的Streamable-HTTP、Stateless Streamable-HTTP和SSE支持spring-ai-starter-mcp-client-webflux- 基于 WebFlux 的Streamable-HTTP、Stateless Streamable-HTTP和SSE传输实现
服务器Starters
标准输出
| 服务池类型设置 | 依赖 | 属性 |
|---|---|---|
| 标准输入输出(STDIO) | spring-ai-starter-mcp-server | spring.ai.mcp.server.stdio=true |
Spring Boot
| 服务池类型设置 | 依赖 | 属性 |
|---|---|---|
| Spring Security Extended Web MVC | spring-ai-starter-mcp-server-webmvc | spring.ai.mcp.server.protocol=SSE 或空 |
| Spring的流式HTTP MVC框架 | spring-ai-starter-mcp-server-webmvc | spring.ai.mcp.server.protocol=STREAMABLE |
| 无状态可流式传输的 HTTP WebMVC | spring-ai-starter-mcp-server-webmvc | spring.ai.mcp.server.protocol=STATELESS |
WebMVC(敏捷)
| 服务池类型设置 | 依赖 | 属性 |
|---|---|---|
| Spring WebFlux | spring-ai-starter-mcp-server-webflux | spring.ai.mcp.server.protocol=SSE 或空 |
| 流式可扩展的HTTP WebFlux | spring-ai-starter-mcp-server-webflux | spring.ai.mcp.server.protocol=STREAMABLE |
| 无状态可流式传输的 HTTP WebFlux | spring-ai-starter-mcp-server-webflux | spring.ai.mcp.server.protocol=STATELESS |
Spring AI MCP 注解
除了编程式的MCP客户端与服务器配置外,Spring AI还通过 MCP注解 模块为MCP服务器和客户端提供基于注解的方法处理。 这种方法使用干净、声明式的编程模型与Java注解,简化了MCP操作的创建与注册。
MCP 注解模块使开发人员能够:
- 使用简单的注解创建 MCP 工具、资源和提示
- 声明式地处理客户端通知和请求
- 减少样板代码并提高可维护性
- 自动为工具参数生成 JSON 模式
- 访问特殊参数和上下文信息
主要功能包括:
- 服务器注解 :
@McpTool,@McpResource,@McpPrompt,@McpComplete - 客户端注解 :
@McpLogging,@McpSampling,@McpElicitation,@McpProgress - 特殊参数 :
McpSyncServerExchange,McpAsyncServerExchange,McpTransportContext,McpMeta - 自动发现 :通过可配置的包包含/排除进行注解扫描
- Spring Boot 集成 :与 MCP Boot Starters 无缝集成
更多资源
检索增强生成
检索增强生成(RAG)是一种有助于克服大型语言模型局限性的技术,这些局限性包括难以处理长篇内容、事实准确性以及上下文感知能力。
Spring AI 通过提供模块化架构来支持 RAG,使您可以自行构建自定义的 RAG 流程, 或使用 Advisor API 来直接使用开箱即用的 RAG 流程。
在 concepts 部分了解更多关于检索增强生成的信息。 |
|---|
通知器
Spring AI 提供开箱即用的支持,使用 Advisor API 实现常见的 RAG 流程。
要使用 QuestionAnswerAdvisor 或 VectorStoreChatMemoryAdvisor,您需要将 spring-ai-advisors-vector-store 依赖添加到您的项目中:
xml
<dependency>
   <groupId>org.springframework.ai</groupId>
   <artifactId>spring-ai-advisors-vector-store</artifactId>
</dependency>
问题回答顾问
向量数据库存储了AI模型所不了解的数据。当用户问题被发送到AI模型时, QuestionAnswerAdvisor 会查询向量数据库以获取与用户问题相关的文档。
向量数据库的响应被附加到用户文本中,以为 AI 模型生成响应提供上下文。
假设您已经将数据加载到 VectorStore 中,您可以通过向 ChatClient 提供 QuestionAnswerAdvisor 的实例来执行检索增强生成(RAG)。
java
ChatResponse response = ChatClient.builder(chatModel)
        .build().prompt()
        .advisors(QuestionAnswerAdvisor.builder(vectorStore).build())
        .user(userText)
        .call()
        .chatResponse();
在本示例中, QuestionAnswerAdvisor 将在向量数据库中的所有文档上执行相似性搜索。要限制搜索的文档类型, SearchRequest 会采用一种类似 SQL 的筛选表达式,该表达式可在所有 VectorStores 中通用。
此过滤器表达式可以在创建 QuestionAnswerAdvisor 时进行配置,因此将始终应用于所有 ChatClient 请求;或者也可以在运行时按每个请求单独提供。
以下是如何创建一个阈值为 0.8 的 QuestionAnswerAdvisor 实例,并返回前 6 个结果。
java
var qaAdvisor = QuestionAnswerAdvisor.builder(vectorStore)
        .searchRequest(SearchRequest.builder().similarityThreshold(0.8d).topK(6).build())
        .build();
动态过滤表达式
在运行时使用 FILTER_EXPRESSION 顾问上下文参数更新 SearchRequest 筛选器表达式:
java
ChatClient chatClient = ChatClient.builder(chatModel)
    .defaultAdvisors(QuestionAnswerAdvisor.builder(vectorStore)
        .searchRequest(SearchRequest.builder().build())
        .build())
    .build();

// Update filter expression at runtime
String content = this.chatClient.prompt()
    .user("Please answer my question XYZ")
    .advisors(a -> a.param(QuestionAnswerAdvisor.FILTER_EXPRESSION, "type == 'Spring'"))
    .call()
    .content();
The FILTER_EXPRESSION parameter allows you to dynamically filter the search results based on the provided expression.
自定义模板
The QuestionAnswerAdvisor uses a default template to augment the user question with the retrieved documents. You can customize this behavior by providing your own PromptTemplate object via the .promptTemplate() builder method.
此处提供的 PromptTemplate 用于自定义顾问如何将检索到的上下文与用户查询进行合并。这与在 ChatClient 本身上配置 TemplateRenderer (使用.templateRenderer())不同,后者会影响顾问运行 之前 初始用户/系统提示内容的呈现。有关客户端级别模板渲染的更多详细信息,请参阅 ChatClient 提示模板 。 |
|---|
自定义的 PromptTemplate 可以使用任何 TemplateRenderer 实现(默认情况下,它使用基于 StringTemplate 引擎的 StPromptTemplate )。关键要求是模板必须包含以下两个占位符:
- a
queryplaceholder to receive the user question. - a
question_answer_contextplaceholder to receive the retrieved context.
java
PromptTemplate customPromptTemplate = PromptTemplate.builder()
    .renderer(StTemplateRenderer.builder().startDelimiterToken('<').endDelimiterToken('>').build())
    .template("""
            <query>

            Context information is below.

            ---------------------
            <question_answer_context>
            ---------------------

            Given the context information and no prior knowledge, answer the query.

            Follow these rules:

            1. If the answer is not in the context, just say that you don't know.
            2. Avoid statements like "Based on the context..." or "The provided information...".
            """)
    .build();

    String question = "Where does the adventure of Anacletus and Birba take place?";

    QuestionAnswerAdvisor qaAdvisor = QuestionAnswerAdvisor.builder(vectorStore)
        .promptTemplate(customPromptTemplate)
        .build();

    String response = ChatClient.builder(chatModel).build()
        .prompt(question)
        .advisors(qaAdvisor)
        .call()
        .content();
The QuestionAnswerAdvisor.Builder.userTextAdvise() method is deprecated in favor of using .promptTemplate() for more flexible customization. |
|---|
检索增强顾问
Spring AI 包含一个 RAG 模块库 ,您可以使用它来构建自己的 RAG 流。 RetrievalAugmentationAdvisor 是一个 Advisor,为最常见的 RAG 流提供了开箱即用的实现, 基于模块化架构。
要使用 RetrievalAugmentationAdvisor,您需要将 spring-ai-rag 依赖项添加到您的项目中:
xml
<dependency>
   <groupId>org.springframework.ai</groupId>
   <artifactId>spring-ai-rag</artifactId>
</dependency>
顺序 RAG 流
朴素RAG
java
Advisor retrievalAugmentationAdvisor = RetrievalAugmentationAdvisor.builder()
        .documentRetriever(VectorStoreDocumentRetriever.builder()
                .similarityThreshold(0.50)
                .vectorStore(vectorStore)
                .build())
        .build();

String answer = chatClient.prompt()
        .advisors(retrievalAugmentationAdvisor)
        .user(question)
        .call()
        .content();
默认情况下, RetrievalAugmentationAdvisor 不允许检索到的上下文为空。当发生这种情况时, 它会指示模型不要回答用户的问题。您可以按如下方式允许空上下文。
java
Advisor retrievalAugmentationAdvisor = RetrievalAugmentationAdvisor.builder()
        .documentRetriever(VectorStoreDocumentRetriever.builder()
                .similarityThreshold(0.50)
                .vectorStore(vectorStore)
                .build())
        .queryAugmenter(ContextualQueryAugmenter.builder()
                .allowEmptyContext(true)
                .build())
        .build();

String answer = chatClient.prompt()
        .advisors(retrievalAugmentationAdvisor)
        .user(question)
        .call()
        .content();
The VectorStoreDocumentRetriever accepts a FilterExpression to filter the search results based on metadata. You can provide one when instantiating the VectorStoreDocumentRetriever or at runtime per request, using the FILTER_EXPRESSION advisor context parameter.
java
Advisor retrievalAugmentationAdvisor = RetrievalAugmentationAdvisor.builder()
        .documentRetriever(VectorStoreDocumentRetriever.builder()
                .similarityThreshold(0.50)
                .vectorStore(vectorStore)
                .build())
        .build();

String answer = chatClient.prompt()
        .advisors(retrievalAugmentationAdvisor)
        .advisors(a -> a.param(VectorStoreDocumentRetriever.FILTER_EXPRESSION, "type == 'Spring'"))
        .user(question)
        .call()
        .content();
请参阅 VectorStoreDocumentRetriever 以获取更多信息。
高级RAG
java
Advisor retrievalAugmentationAdvisor = RetrievalAugmentationAdvisor.builder()
        .queryTransformers(RewriteQueryTransformer.builder()
                .chatClientBuilder(chatClientBuilder.build().mutate())
                .build())
        .documentRetriever(VectorStoreDocumentRetriever.builder()
                .similarityThreshold(0.50)
                .vectorStore(vectorStore)
                .build())
        .build();

String answer = chatClient.prompt()
        .advisors(retrievalAugmentationAdvisor)
        .user(question)
        .call()
        .content();
您还可以使用 DocumentPostProcessor API 在将检索到的文档传递给模型之前对其进行后处理。例如,您可以使用此类接口根据文档与查询的相关性对检索到的文档进行重新排序、删除不相关或冗余的文档,或者压缩每个文档的内容以减少噪声和冗余。
模块
Spring AI 实现了一种模块化 RAG 架构,该架构的灵感来源于论文中详细阐述的模块化概念 " 模块化 RAG:将 RAG 系统转变为类似乐高积木的可重构框架 "。
预检索
预检索模块负责处理用户查询,以获得最佳的检索结果。
查询转换
一个用于将输入查询转换为更有效的检索任务的组件,以应对诸如查询格式不佳、术语歧义、复杂词汇或不支持的语言等挑战。
当使用 QueryTransformer 时,建议将 ChatClient.Builder 配置为较低的温度(例如 0.0),以确保结果更具确定性和准确性,从而提升检索质量。大多数聊天模型的默认温度通常偏高,不利于最佳的查询转换,进而导致检索效果下降。 |
|---|
压缩查询转换器
A CompressionQueryTransformer 使用大型语言模型将对话历史和后续查询压缩为一个独立的查询,该查询能够捕捉对话的本质。
当对话历史较长且后续查询与对话上下文相关时,此转换器非常有用。
java
Query query = Query.builder()
        .text("And what is its second largest city?")
        .history(new UserMessage("What is the capital of Denmark?"),
                new AssistantMessage("Copenhagen is the capital of Denmark."))
        .build();

QueryTransformer queryTransformer = CompressionQueryTransformer.builder()
        .chatClientBuilder(chatClientBuilder)
        .build();

Query transformedQuery = queryTransformer.transform(query);
该组件使用的提示可以通过构建器中可用的 promptTemplate() 方法进行自定义。
重写查询转换器
A RewriteQueryTransformer 使用大型语言模型重写用户查询,以在查询目标系统(例如向量存储或网络搜索引擎)时提供更好的结果。
当用户查询冗长、模糊或包含可能影响搜索结果质量的无关信息时,此转换器非常有用。
java
Query query = new Query("I'm studying machine learning. What is an LLM?");

QueryTransformer queryTransformer = RewriteQueryTransformer.builder()
        .chatClientBuilder(chatClientBuilder)
        .build();

Query transformedQuery = queryTransformer.transform(query);
该组件使用的提示可以通过构建器中可用的 promptTemplate() 方法进行自定义。
翻译查询转换器
A TranslationQueryTransformer 使用大型语言模型将查询翻译为目标语言,该目标语言由用于生成文档嵌入的嵌入模型支持。如果查询已经是目标语言,则原样返回。如果查询的语言未知,则也原样返回。
当嵌入模型是在特定语言上训练的,而用户查询却使用另一种语言时,此转换器非常有用。
java
Query query = new Query("Hvad er Danmarks hovedstad?");

QueryTransformer queryTransformer = TranslationQueryTransformer.builder()
        .chatClientBuilder(chatClientBuilder)
        .targetLanguage("english")
        .build();

Query transformedQuery = queryTransformer.transform(query);
该组件使用的提示可以通过构建器中可用的 promptTemplate() 方法进行自定义。
查询扩展
一个用于将输入查询扩展为查询列表的组件,通过提供替代的查询形式或把复杂问题分解为更简单的子查询,来解决诸如查询格式不佳等问题。
多查询扩展器
A MultiQueryExpander 使用大型语言模型将查询扩展为多个语义上多样化的变体 以捕捉不同的视角,这对于检索额外的上下文信息并提高找到相关结果的可能性非常有用。
java
MultiQueryExpander queryExpander = MultiQueryExpander.builder()
    .chatClientBuilder(chatClientBuilder)
    .numberOfQueries(3)
    .build();
List<Query> queries = queryExpander.expand(new Query("How to run a Spring Boot app?"));
默认情况下, MultiQueryExpander 会将原始查询包含在展开的查询列表中。您可以通过构建器中的 includeOriginal 方法禁用此行为。
java
MultiQueryExpander queryExpander = MultiQueryExpander.builder()
    .chatClientBuilder(chatClientBuilder)
    .includeOriginal(false)
    .build();
该组件使用的提示可以通过构建器中可用的 promptTemplate() 方法进行自定义。
检索
检索模块负责查询向量存储等数据系统,并检索出最相关的文档。
文档搜索
负责从底层数据源(如搜索引擎、向量存储、数据库或知识图谱)检索 Documents 的组件。
向量存储文档检索器
一个 VectorStoreDocumentRetriever 从向量存储中检索与输入查询语义相似的文档。它支持基于元数据、相似度阈值和前 k 个结果的过滤。
java
DocumentRetriever retriever = VectorStoreDocumentRetriever.builder()
    .vectorStore(vectorStore)
    .similarityThreshold(0.73)
    .topK(5)
    .filterExpression(new FilterExpressionBuilder()
        .eq("genre", "fairytale")
        .build())
    .build();
List<Document> documents = retriever.retrieve(new Query("What is the main character of the story?"));
筛选表达式可以是静态的或动态的。对于动态筛选表达式,您可以传递一个 Supplier 。
java
DocumentRetriever retriever = VectorStoreDocumentRetriever.builder()
    .vectorStore(vectorStore)
    .filterExpression(() -> new FilterExpressionBuilder()
        .eq("tenant", TenantContextHolder.getTenantIdentifier())
        .build())
    .build();
List<Document> documents = retriever.retrieve(new Query("What are the KPIs for the next semester?"));
您还可以通过 Query API,使用 FILTER_EXPRESSION 参数提供请求特定的筛选表达式。 如果同时提供了请求特定和检索器特定的筛选表达式,则请求特定的筛选表达式优先生效。
java
Query query = Query.builder()
    .text("Who is Anacletus?")
    .context(Map.of(VectorStoreDocumentRetriever.FILTER_EXPRESSION, "location == 'Whispering Woods'"))
    .build();
List<Document> retrievedDocuments = documentRetriever.retrieve(query);
文档连接
一个用于将基于多个查询和来自多个数据源检索到的文档合并为单个文档集合的组件。作为连接过程的一部分,它还可以处理重复文档和相互排名策略。
连接文档连接器
一个 ConcatenationDocumentJoiner 通过将基于多个查询和多个数据源检索到的文档连接成一个单一的文档集合来合并这些文档。如果出现重复文档,则保留首次出现的文档。 每个文档的分数保持不变。
java
Map<Query, List<List<Document>>> documentsForQuery = ...
DocumentJoiner documentJoiner = new ConcatenationDocumentJoiner();
List<Document> documents = documentJoiner.join(documentsForQuery);
检索后
检索后模块负责处理检索到的文档,以实现最佳的生成结果。
文档后处理
一个用于基于查询对检索到的文档进行后处理的组件,以解决诸如 中间丢失 、模型的上下文长度限制以及减少检索信息中的噪声和冗余等问题。
例如,它可以根据文档与查询的相关性对文档进行排序,删除不相关或冗余的文档,或者压缩每个文档的内容以减少噪声和冗余。
生成
生成模块负责根据用户查询和检索到的文档生成最终响应。
查询增强
一个用于为输入查询添加附加数据的组件,有助于为大型语言模型提供回答用户查询所需的上下文。
上下文查询增强器
ContextualQueryAugmenter 通过从所提供文档的内容中提取上下文数据来增强用户查询。
java
QueryAugmenter queryAugmenter = ContextualQueryAugmenter.builder().build();默认情况下, ContextualQueryAugmenter 不允许检索到的上下文为空。当发生这种情况时, 它会指示模型不要回答用户的查询。
您可以启用 allowEmptyContext 选项,以便在检索到的上下文为空时,模型仍能生成响应。
java
QueryAugmenter queryAugmenter = ContextualQueryAugmenter.builder()
        .allowEmptyContext(true)
        .build();
此组件使用的提示可以通过构建器中提供的 promptTemplate() 和 emptyContextPromptTemplate() 方法进行自定义。
ETL 管道
提取、转换和加载(ETL)框架是RAG场景中数据处理的核心。
ETL管道组织了从原始数据源到结构化向量存储的数据流,确保数据以适合AI模型检索的最优格式存在。
RAG应用场景是通过文本增强生成模型的能力,从大量数据中检索相关信息,以提高生成输出的质量和相关性。
API概述
ETL管道创建、转换和存储了 Document 实例。
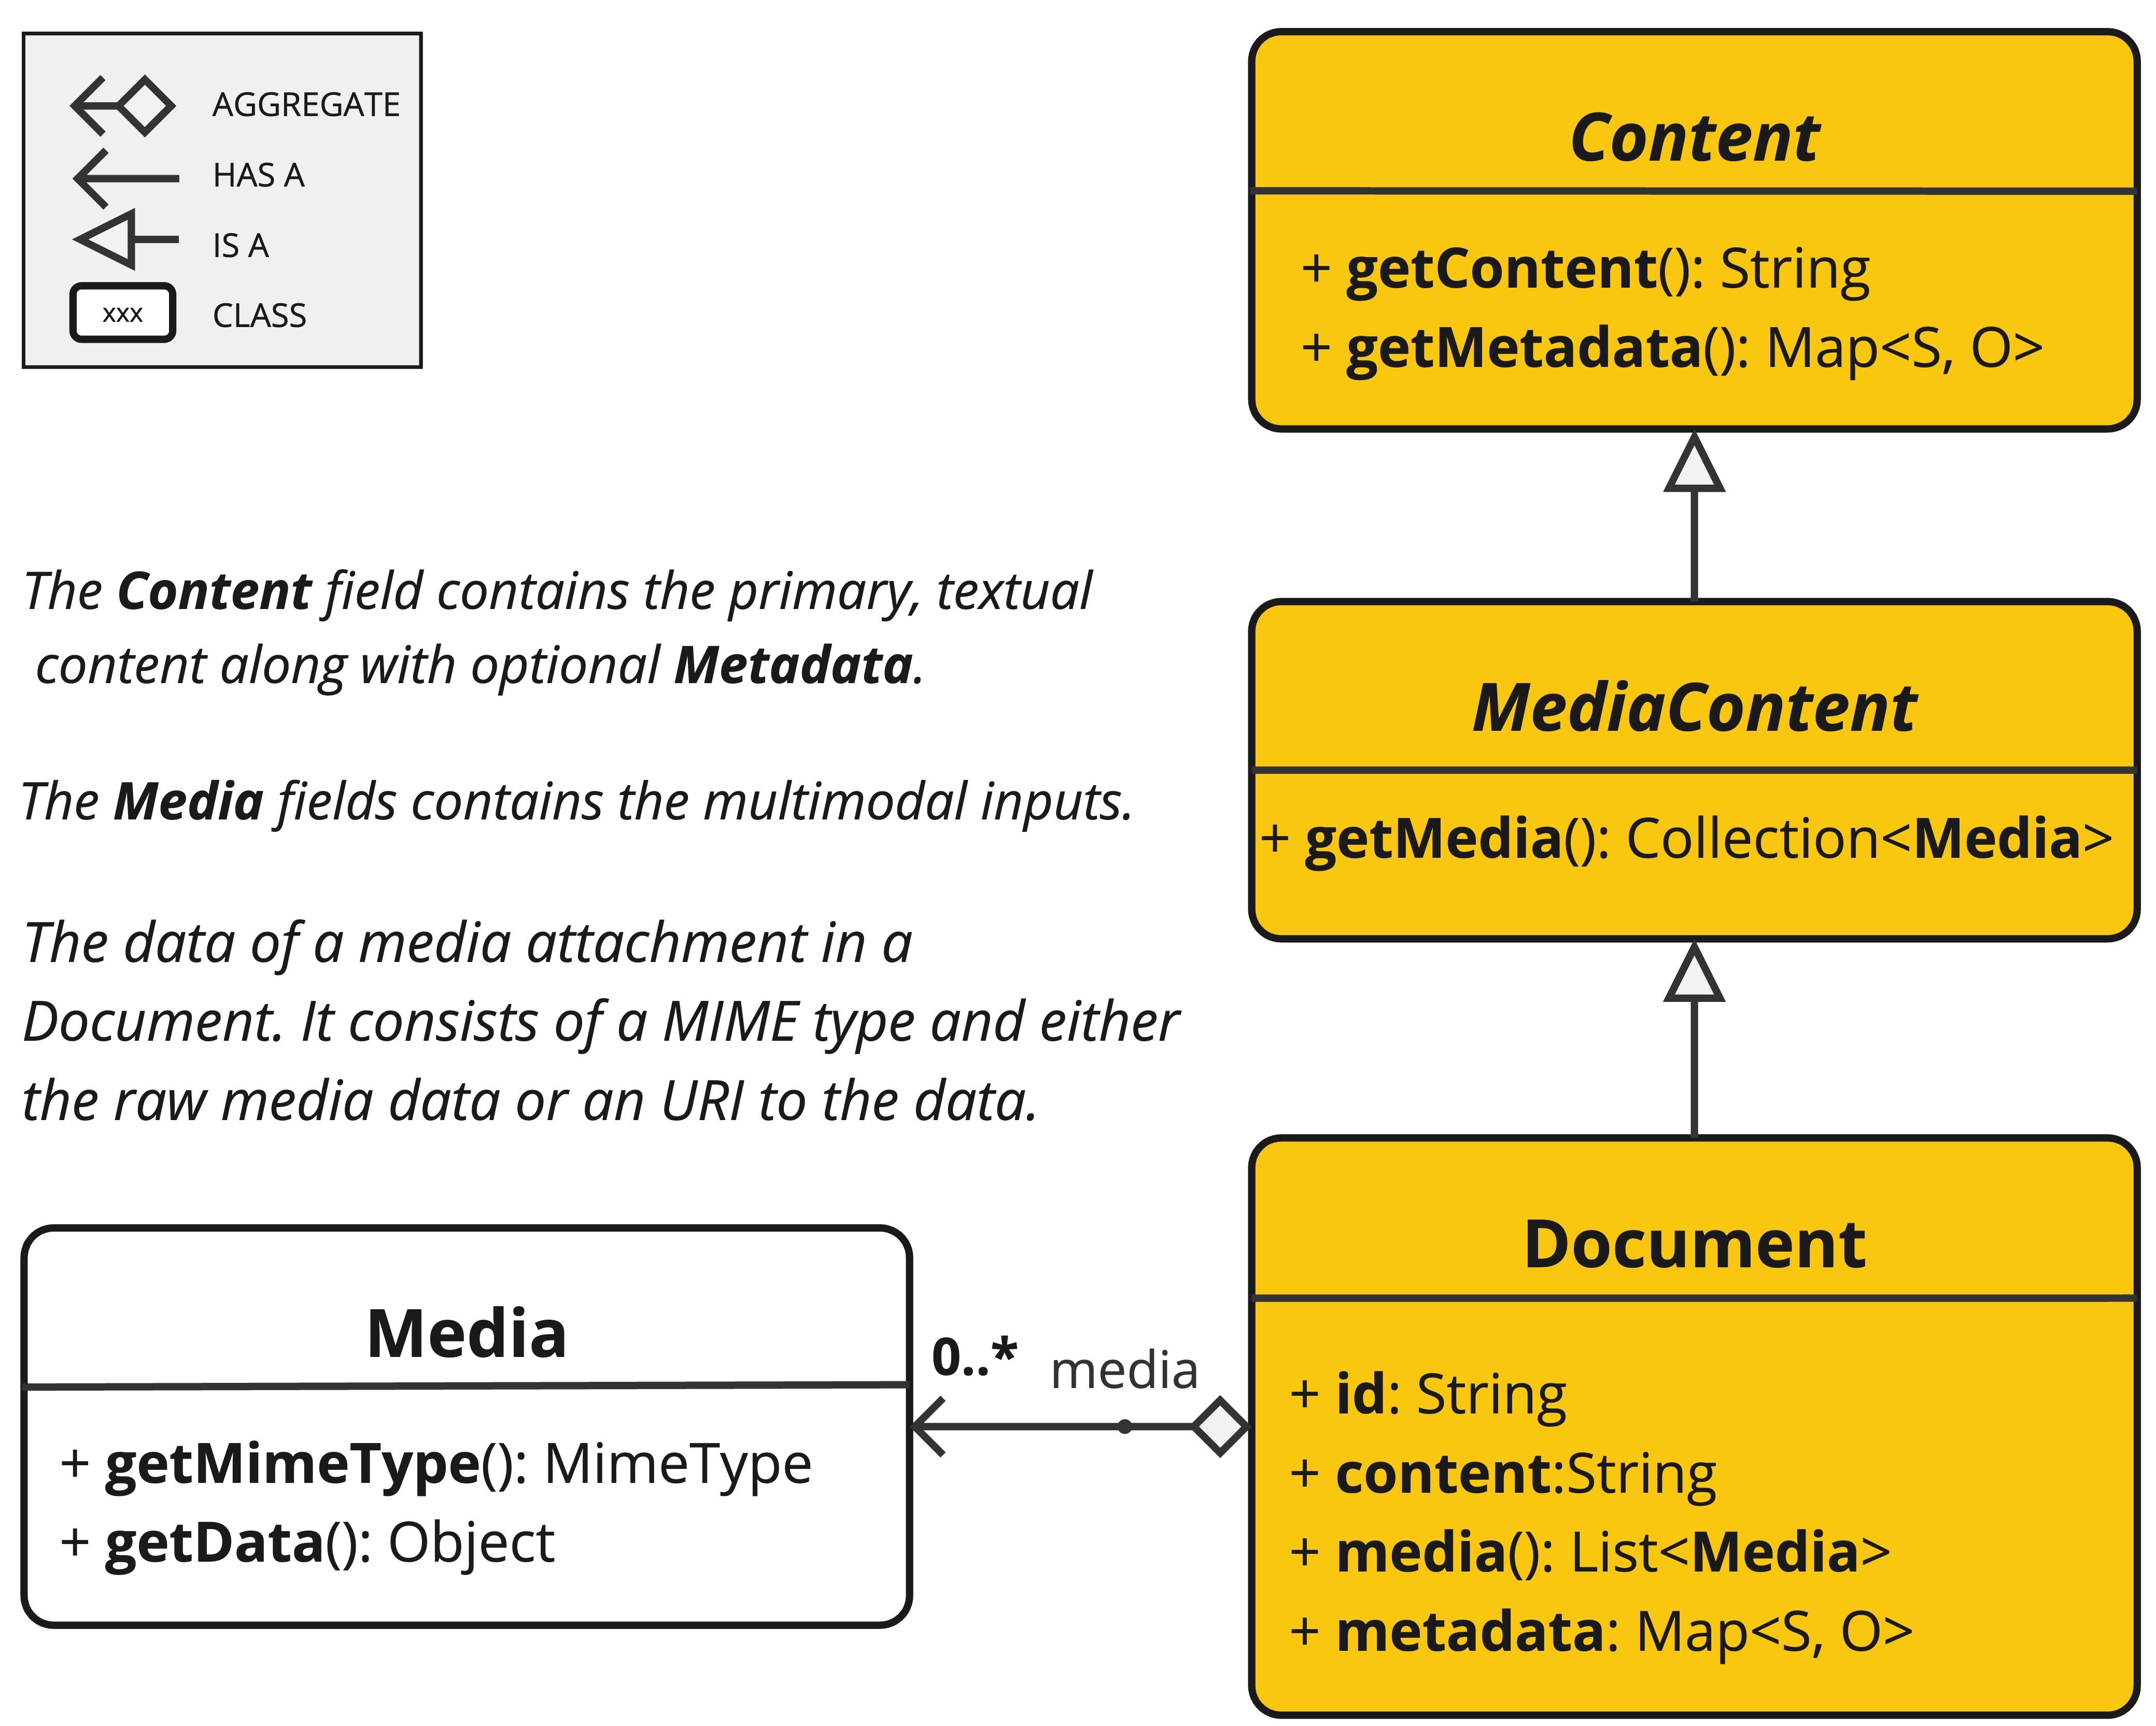
The Document 类包含文本、元数据,以及可选的其他媒体类型,如图片、音频和视频。
ETL数据流程由三个主要组成部分构成。
The Document class content is created from PDFs, text files and other document types with the help of DocumentReader.
要构建一个简单的ETL管道,你可以将每种类型的实例连接在一起。
假设我们有以下这三种ETL类型的实例。
PagePdfDocumentReader是一种实现方式DocumentReaderTokenTextSplitter是一种实现方式DocumentTransformerVectorStore是一种实现方式DocumentWriter
为了在向量数据库中进行基本加载,以便与检索增强生成模式一起使用,使用以下代码在Java函数风格语法下。
java
vectorStore.accept(tokenTextSplitter.apply(pdfReader.get()));或者,你可以使用更适合领域的方法名。
java
vectorStore.write(tokenTextSplitter.split(pdfReader.read()));ETL接口
ETL管道由以下接口和实现组成。 详细的ETL类图在 ETL类图 部分展示。
文档读取器
提供来自不同来源的文档。
java
public interface DocumentReader extends Supplier<List<Document>> {

    default List<Document> read() {
        return get();
    }
}
文档转换器
该组件负责批量处理一批文档,作为整个处理工作流程的一部分。
java
public interface DocumentTransformer extends Function<List<Document>, List<Document>> {

    default List<Document> transform(List<Document> transform) {
        return apply(transform);
    }
}
文档编写器
处理ETL流程的最后阶段,准备文档供存储。
java
public interface DocumentWriter extends Consumer<List<Document>> {

    default void write(List<Document> documents) {
        accept(documents);
    }
}
ETL类图
以下类图展示了ETL接口及其实现情况。
DocumentReaders
JSON
The 零 processes JSON documents, converting them into a list of 一 objects.
示例
java
@Component
class MyJsonReader {

    private final Resource resource;

    MyJsonReader(@Value("classpath:bikes.json") Resource resource) {
        this.resource = resource;
    }

    List<Document> loadJsonAsDocuments() {
        JsonReader jsonReader = new JsonReader(this.resource, "description", "content");
        return jsonReader.get();
    }
}
构造器选项
The 代码 0提供了一些构造器选项:
JsonReader(Resource resource)JsonReader(Resource resource, String… jsonKeysToUse)JsonReader(Resource resource, JsonMetadataGenerator jsonMetadataGenerator, String… jsonKeysToUse)
参数
resource: 一个SpringResource对象指向JSON文件。- `0`:从JSON中取出的一组键,这些键将作为结果中`1`对象的文本内容。
jsonMetadataGenerator: 可选的JsonMetadataGenerator用于创建每个Document的元数据。
行为
0 处理JSON内容如下:
- 该框架支持处理JSON数组和单个JSON对象。
- 对于每个JSON对象(无论是数组中的一个对象,还是单独的一个对象):
- 它基于指定的
jsonKeysToUse提取内容。 - 如果没有指定键,它会使用整个JSON对象作为内容。
- It generates metadata using the provided
JsonMetadataGenerator(or an empty one if not provided). - It creates a
Documentobject with the extracted content and metadata.
- 它基于指定的
使用JSON指针
0 现在支持使用 JSON Pointers 获取 JSON 文档中的具体部分。这个功能允许您轻松从复杂 JSON 结构中提取嵌套数据。
方法
java
public List<Document> get(String pointer)该方法允许你使用JSON指针来获取特定的JSON文档部分。
参数
pointer: 一个根据RFC 6901规定定义的JSON指针字符串,用于定位JSON结构中的所需元素。
返回值
- 返回一个包含通过指针指向的JSON元素解析出的文档的0。
行为
- 该方法使用提供的JSON指针来导航到一个特定的位置在JSON结构中。
- 如果指针是有效的,并且指向一个已存在的元素:
- 对于一个JSON对象:它返回一个单一的文档。
- 当处理一个JSON数组时,它会返回一个Document列表,每个元素对应一个Document。
- If the pointer is invalid or points to a non-existent element, it throws an
IllegalArgumentException.
示例
java
JsonReader jsonReader = new JsonReader(resource, "description");
List<Document> documents = this.jsonReader.get("/store/books/0");
示例JSON结构
json
[
  {
    "id": 1,
    "brand": "Trek",
    "description": "A high-performance mountain bike for trail riding."
  },
  {
    "id": 2,
    "brand": "Cannondale",
    "description": "An aerodynamic road bike for racing enthusiasts."
  }
]
In this example, if the JsonReader is configured with "description" as the jsonKeysToUse, it will create Document objects where the content is the value of the "description" field for each bike in the array.
注释
- 的
JsonReader使用 Jackson 进行 JSON 解析。 - 它可以高效地处理大型JSON文件,通过流式处理数组来实现。
- 如果在
jsonKeysToUse中指定了多个键,则内容将是这些键值的合并。 - 可调整和灵活的设计允许对JSON结构进行定制。
jsonKeysToUse和JsonMetadataGenerator可以根据需要进行修改。
文本
The TextReader 处理纯文本文件,将其转换为一个由 Document 对象组成的列表中。
示例
java
@Component
class MyTextReader {

    private final Resource resource;

    MyTextReader(@Value("classpath:text-source.txt") Resource resource) {
        this.resource = resource;
    }

    List<Document> loadText() {
        TextReader textReader = new TextReader(this.resource);
        textReader.getCustomMetadata().put("filename", "text-source.txt");

        return textReader.read();
    }
}
构造器选项
第 TextReader 提供了两种构造方式:
TextReader(String resourceUrl)TextReader(Resource resource)
参数
resourceUrl: 表示要读取的资源的URL字符串。resource: SpringResource对象指向文本文件。
配置
- 参数
setCharset(Charset charset):指定读取文本文件时使用的字符集。默认值为UTF-8。 - 0: Returns a mutable map where you can add custom metadata for the documents.
行为
The TextReader processes text content as follows:
- It reads the entire content of the text file into a single
Documentobject. - 文件的内容将存储在标记0中。
- Metadata会被自动添加到
零:charset: 字符集用于读取文件(默认值:"UTF-8")。source: 源文本文件的文件名.
- 任何自定义的元数据,通过添加
getCustomMetadata()的方式包含在内,将包含在Document中。
注释
- The
TextReader一次性读取文件内容到内存中,因此,它可能不适合处理非常大的文件。 - If you need to split the text into smaller chunks, you can use a text splitter like
TokenTextSplitterafter reading the document:
java
List<Document> documents = textReader.get();
List<Document> splitDocuments = new TokenTextSplitter().apply(this.documents);- 读者使用Spring的0版本抽象层,允许其从各种来源读取,如类路径、文件系统、URL等。
- 可以为所有由读者创建的文档添加自定义元数据。
HTML(JSoup)
JsoupDocumentReader 会处理HTML文档,使用JSoup库将其转换为 Document 对象的列表。
依赖项
使用 Maven 或 Gradle 将依赖项添加到您的项目中。
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-jsoup-document-reader</artifactId>
</dependency>
示例
java
@Component
class MyHtmlReader {

    private final Resource resource;

    MyHtmlReader(@Value("classpath:/my-page.html") Resource resource) {
        this.resource = resource;
    }

    List<Document> loadHtml() {
        JsoupDocumentReaderConfig config = JsoupDocumentReaderConfig.builder()
            .selector("article p") // Extract paragraphs within <article> tags
            .charset("ISO-8859-1")  // Use ISO-8859-1 encoding
            .includeLinkUrls(true) // Include link URLs in metadata
            .metadataTags(List.of("author", "date")) // Extract author and date meta tags
            .additionalMetadata("source", "my-page.html") // Add custom metadata
            .build();

        JsoupDocumentReader reader = new JsoupDocumentReader(this.resource, config);
        return reader.get();
    }
}
JsoupDocumentReaderConfig 允许您自定义 JsoupDocumentReader 的行为:
charset:指定HTML文档的字符编码(默认为“UTF-8”)。selector: 一个JSoup CSS选择器,用于指定从中提取文本的元素(默认为"body")。separator: 用于连接来自多个选定元素的文本的字符串(默认为“\n”)。allElements:如果为true,则从<body>元素中提取所有文本,忽略selector(默认为false)。groupByElement:如果为true,则为每个由selector匹配到的元素创建一个独立的Document(默认值为false)。includeLinkUrls:如果为true,则提取绝对链接URL并将其添加到元数据中(默认为false)。metadataTags:要从中提取内容的<meta>标签名称列表(默认为["description", "keywords"])。additionalMetadata:允许您向所有创建的Document对象添加自定义元数据。
示例文档:my-page.html
html
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="UTF-8">
<title>My Web Page</title>
<meta name="description" content="A sample web page for Spring AI">
<meta name="keywords" content="spring, ai, html, example">
<meta name="author" content="John Doe">
<meta name="date" content="2024-01-15">
<link rel="stylesheet" href="style.css">
</head>
<body>
<header>
<h1>Welcome to My Page</h1>
</header>
<nav>
<ul>
<li><a href="/">Home</a></li>
<li><a href="/about">About</a></li>
</ul>
</nav>
<article>
<h2>Main Content</h2>
<p>This is the main content of my web page.</p>
<p>It contains multiple paragraphs.</p>
<a href="https://www.example.com">External Link</a>
</article>
<footer>
<p>© 2024 John Doe</p>
</footer>
</body>
</html>Behavior:
The JsoupDocumentReader processes the HTML content and creates Document objects based on the configuration:
- The
selectordetermines which elements are used for text extraction. - 如果
allElements是true,则<body>内的所有文本将被提取到一个单独的Document中。 - 如果
groupByElement是true,则每个匹配selector的元素都会创建一个单独的Document。 - 如果
allElements和groupByElement都不是true,则匹配selector的所有元素的文本将使用separator连接。 - 文档标题、来自指定
<meta>标签的内容,以及(可选)链接 URL 会被添加到Document元数据中。 - 基础 URI 将从 URL 资源中提取,用于解析相对链接。
读者保留所选元素的文本内容,但移除其中的任何 HTML 标签。
Markdown
The MarkdownDocumentReader processes Markdown documents, converting them into a list of Document objects.
依赖项
使用 Maven 或 Gradle 将依赖项添加到您的项目中。
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-markdown-document-reader</artifactId>
</dependency>
示例
java
@Component
class MyMarkdownReader {

    private final Resource resource;

    MyMarkdownReader(@Value("classpath:code.md") Resource resource) {
        this.resource = resource;
    }

    List<Document> loadMarkdown() {
        MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder()
            .withHorizontalRuleCreateDocument(true)
            .withIncludeCodeBlock(false)
            .withIncludeBlockquote(false)
            .withAdditionalMetadata("filename", "code.md")
            .build();

        MarkdownDocumentReader reader = new MarkdownDocumentReader(this.resource, config);
        return reader.get();
    }
}
The MarkdownDocumentReaderConfig allows you to customize the behavior of the MarkdownDocumentReader:
horizontalRuleCreateDocument: 当设置为true时,Markdown 中的水平线将创建新的Document对象。includeCodeBlock: 当设置为true时,代码块将与周围文本位于同一个Document中。当设置为false时,代码块会创建独立的Document对象。includeBlockquote: 当设置为true时,引用块将与周围文本位于同一Document中。当设置为false时,引用块会创建单独的Document对象。additionalMetadata:允许您向所有创建的Document对象添加自定义元数据。
示例文档:code.md
markdown
This is a Java sample application:

\`\`\`java
package com.example.demo;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;

@SpringBootApplication
public class DemoApplication {
    public static void main(String[] args) {
        SpringApplication.run(DemoApplication.class, args);
    }
}
\`\`\`

Markdown also provides the possibility to \`use inline code formatting throughout\` the entire sentence.

---

Another possibility is to set block code without specific highlighting:

\`\`\`
./mvnw spring-javaformat:apply
\`\`\`
行为:MarkdownDocumentReader 处理 Markdown 内容,并根据配置创建 Document 对象。
- 头部信息在 Document 对象中成为元数据。
- 段落成为 Document 对象的内容。
- 代码块可以被分离成独立的 Document 对象,也可以与周围文本一起包含。
- 块引用可以被分离成独立的 Document 对象,也可以与周围文本一起包含。
- 水平线可用于将内容拆分为独立的 Document 对象。
读者会保留文档对象内容中的格式,例如内联代码、列表和文本样式。
PDF 页面
The PagePdfDocumentReader uses Apache PdfBox library to parse PDF documents.
依赖项
使用 Maven 或 Gradle 将依赖项添加到您的项目中。
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-pdf-document-reader</artifactId>
</dependency>
示例
java
@Component
public class MyPagePdfDocumentReader {

    List<Document> getDocsFromPdf() {

        PagePdfDocumentReader pdfReader = new PagePdfDocumentReader("classpath:/sample1.pdf",
                PdfDocumentReaderConfig.builder()
                    .withPageTopMargin(0)
                    .withPageExtractedTextFormatter(ExtractedTextFormatter.builder()
                        .withNumberOfTopTextLinesToDelete(0)
                        .build())
                    .withPagesPerDocument(1)
                    .build());

        return pdfReader.read();
    }

}
PDF段落
The ParagraphPdfDocumentReader uses the PDF catalog (e.g. TOC) information to split the input PDF into text paragraphs and output a single Document per paragraph. NOTE: Not all PDF documents contain the PDF catalog.
依赖项
使用 Maven 或 Gradle 将依赖项添加到您的项目中。
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-pdf-document-reader</artifactId>
</dependency>
示例
java
@Component
public class MyPagePdfDocumentReader {

    List<Document> getDocsFromPdfWithCatalog() {

        ParagraphPdfDocumentReader pdfReader = new ParagraphPdfDocumentReader("classpath:/sample1.pdf",
                PdfDocumentReaderConfig.builder()
                    .withPageTopMargin(0)
                    .withPageExtractedTextFormatter(ExtractedTextFormatter.builder()
                        .withNumberOfTopTextLinesToDelete(0)
                        .build())
                    .withPagesPerDocument(1)
                    .build());

        return pdfReader.read();
    }
}
Tika (DOCX, PPTX, HTML…)
The TikaDocumentReader uses Apache Tika to extract text from a variety of document formats, such as PDF, DOC/DOCX, PPT/PPTX, and HTML. For a comprehensive list of supported formats, refer to the Tika documentation.
依赖项
使用 Maven 或 Gradle 将依赖项添加到您的项目中。
- Maven
- Gradle
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-tika-document-reader</artifactId>
</dependency>
示例
java
@Component
class MyTikaDocumentReader {

    private final Resource resource;

    MyTikaDocumentReader(@Value("classpath:/word-sample.docx")
                            Resource resource) {
        this.resource = resource;
    }

    List<Document> loadText() {
        TikaDocumentReader tikaDocumentReader = new TikaDocumentReader(this.resource);
        return tikaDocumentReader.read();
    }
}
转换器
文本拆分器
The TextSplitter 是一个抽象基类,有助于将文档划分以适应 AI 模型的上下文窗口。
Tokens文本拆分器
The TokenTextSplitter is an implementation of TextSplitter that splits text into chunks based on token count, using the CL100K_BASE encoding.
用法
基本用法
java
@Component
class MyTokenTextSplitter {

    public List<Document> splitDocuments(List<Document> documents) {
        TokenTextSplitter splitter = new TokenTextSplitter();
        return splitter.apply(documents);
    }

    public List<Document> splitCustomized(List<Document> documents) {
        TokenTextSplitter splitter = new TokenTextSplitter(1000, 400, 10, 5000, true, List.of('.', '?', '!', '\n'));
        return splitter.apply(documents);
    }
}
使用构建器模式
推荐的创建 TokenTextSplitter 的方式是使用构建器模式,它提供了更易读且灵活的API:
java
@Component
class MyTokenTextSplitter {

    public List<Document> splitWithBuilder(List<Document> documents) {
        TokenTextSplitter splitter = TokenTextSplitter.builder()
            .withChunkSize(1000)
            .withMinChunkSizeChars(400)
            .withMinChunkLengthToEmbed(10)
            .withMaxNumChunks(5000)
            .withKeepSeparator(true)
            .build();

        return splitter.apply(documents);
    }
}
自定义标点符号
您可以自定义用于将文本拆分为语义上有意义的片段的标点符号。这对于国际化尤其有用:
java
@Component
class MyInternationalTextSplitter {

    public List<Document> splitChineseText(List<Document> documents) {
        // Use Chinese punctuation marks
        TokenTextSplitter splitter = TokenTextSplitter.builder()
            .withChunkSize(800)
            .withMinChunkSizeChars(350)
            .withPunctuationMarks(List.of('。', '?', '!', ';'))  // Chinese punctuation
            .build();

        return splitter.apply(documents);
    }

    public List<Document> splitWithCustomMarks(List<Document> documents) {
        // Mix of English and other punctuation marks
        TokenTextSplitter splitter = TokenTextSplitter.builder()
            .withChunkSize(800)
            .withPunctuationMarks(List.of('.', '?', '!', '\n', ';', ':', '。'))
            .build();

        return splitter.apply(documents);
    }
}
构造器选项
The TokenTextSplitter provides three constructor options:
TokenTextSplitter(): 创建一个具有默认设置的拆分器。TokenTextSplitter(boolean keepSeparator): 创建具有自定义分隔符行为的拆分器。TokenTextSplitter(int chunkSize, int minChunkSizeChars, int minChunkLengthToEmbed, int maxNumChunks, boolean keepSeparator, List<Character> punctuationMarks): 具有所有自定义选项的完整构造函数。
| 构建器模式(如上所示)是创建具有自定义配置的实例的推荐方法。 |
|---|
参数
chunkSize: 每个文本块的目标大小(以标记为单位)(默认值:800)。minChunkSizeChars: 每个文本块的最小字符数(默认值:350)。minChunkLengthToEmbed: 要包含的分块的最小长度(默认:5)。maxNumChunks: 从文本中生成的最大分块数量(默认:10000)。keepSeparator: 是否在分块中保留分隔符(如换行符)(默认:true)。punctuationMarks: 用于作为句子边界进行拆分的字符列表(默认值:.,?,!,\n)。
行为
The TokenTextSplitter processes text content as follows:
- 它使用 CL100K_BASE 编码将输入文本编码为标记。
- 它根据
chunkSize将编码后的文本拆分为若干块。 - 对于每个块:
- 它将该数据块解码回文本。
- 仅当总标记数超过分块大小时,它才会尝试在
minChunkSizeChars之后找到一个合适的断点(使用配置的punctuationMarks)。 - 如果发现断点,则在该点截断数据块。
- 它会裁剪该块,并根据
keepSeparator设置可选地移除换行符。 - 如果生成的片段长度大于
minChunkLengthToEmbed,则将其添加到输出中。
- 此过程将持续,直到所有标记被处理完毕或达到
maxNumChunks。 - 任何剩余的文本如果长度大于
minChunkLengthToEmbed,则作为最后一块添加。
| 仅当标记数量超过分块大小时,基于标点的拆分才会生效。与分块大小完全匹配或小于分块大小的文本将作为一个单独的分块返回,不会进行基于标点的截断。这可以避免对小文本进行不必要的拆分。 |
|---|
示例
java
Document doc1 = new Document("This is a long piece of text that needs to be split into smaller chunks for processing.",
Map.of("source", "example.txt"));
Document doc2 = new Document("Another document with content that will be split based on token count.",
Map.of("source", "example2.txt"));
TokenTextSplitter splitter = new TokenTextSplitter();
List<Document> splitDocuments = this.splitter.apply(List.of(this.doc1, this.doc2));
for (Document doc : splitDocuments) {
System.out.println("Chunk: " + doc.getContent());
System.out.println("Metadata: " + doc.getMetadata());
}注释
- The
TokenTextSplitteruses the CL100K_BASE encoding from thejtokkitlibrary, which is compatible with newer OpenAI models. - 拆分器会尝试在可能的情况下,以句子边界为依据,创建语义上有意义的片段。
- 原始文档的元数据会被保留,并复制到从该文档派生的所有分块中。
- 如果将
copyContentFormatter设置为true(默认行为),则原始文档中的内容格式化器(如果已设置)也会被复制到派生的片段中。 - 该分词器特别适用于为具有标记限制的大型语言模型准备文本,确保每个片段都在模型的处理能力范围内。
- 自定义标点符号 :默认的标点符号(
.、?、!、\n) 适用于英语文本。对于其他语言或特殊内容,可以使用构建器的withPunctuationMarks()方法自定义标点符号。 - 性能考虑 :虽然分词器可以处理任意数量的标点符号,但为了获得最佳性能,建议将列表保持在合理的小范围内(少于20个字符),因为每个标记都会被逐个检查。
- 可扩展性 :
getLastPunctuationIndex(String)方法是protected,允许子类覆盖标点符号检测逻辑以用于特定用例。 - 小文本处理 :自版本2.0起,小文本(标记数量等于或低于分块大小)不再在标点符号处进行拆分,从而避免了对已符合大小限制的内容进行不必要的碎片化。
内容格式转换器
确保所有文档的内容格式统一。
关键字元数据丰富器
The KeywordMetadataEnricher is a DocumentTransformer that uses a generative AI model to extract keywords from document content and add them as metadata.
用法
java
@Component
class MyKeywordEnricher {
private final ChatModel chatModel;
MyKeywordEnricher(ChatModel chatModel) {
this.chatModel = chatModel;
}
List<Document> enrichDocuments(List<Document> documents) {
KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
.keywordCount(5)
.build();
// Or use custom templates
KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
.keywordsTemplate(YOUR_CUSTOM_TEMPLATE)
.build();
return enricher.apply(documents);
}
}构造器选项
第 KeywordMetadataEnricher 提供了两种构造方式:
KeywordMetadataEnricher(ChatModel chatModel, int keywordCount): 使用默认模板并提取指定数量的关键词。KeywordMetadataEnricher(ChatModel chatModel, PromptTemplate keywordsTemplate): 使用自定义模板进行关键词提取。
行为
The KeywordMetadataEnricher processes documents as follows:
- 对于每个输入文档,它会使用该文档的内容创建一个提示。
- 它会将此提示发送到提供的
ChatModel以生成关键字。 - 生成的关键词被添加到文档的元数据中,键为“excerpt_keywords”。
- 丰富的文档已返回。
自定义
您可以使用默认模板,或通过 keywordsTemplate 参数自定义模板。 默认模板为:
java
\{context_str}. Give %s unique keywords for this document. Format as comma separated. Keywords:其中 {context_str} 被替换为文档内容, %s 被替换为指定的关键词数量。
示例
java
ChatModel chatModel = // initialize your chat model
KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
.keywordCount(5)
.build();
// Or use custom templates
KeywordMetadataEnricher enricher = KeywordMetadataEnricher.builder(chatModel)
.keywordsTemplate(new PromptTemplate("Extract 5 important keywords from the following text and separate them with commas:\n{context_str}"))
.build();
Document doc = new Document("This is a document about artificial intelligence and its applications in modern technology.");
List<Document> enrichedDocs = enricher.apply(List.of(this.doc));
Document enrichedDoc = this.enrichedDocs.get(0);
String keywords = (String) this.enrichedDoc.getMetadata().get("excerpt_keywords");
System.out.println("Extracted keywords: " + keywords);注释
KeywordMetadataEnricher需要一个有效的ChatModel才能生成关键词。- 关键字数量必须为1或更大。
- 该增强器向每个处理过的文档添加“excerpt_keywords”元数据字段。
- 生成的关键词以逗号分隔的字符串形式返回。
- 此增强器特别有助于提高文档的可搜索性,以及为文档生成标签或分类。
- 在建造者模式中,如果设置了
keywordsTemplate参数,则会忽略keywordCount参数。
摘要元数据增强器
SummaryMetadataEnricher 是一个使用生成式 AI 模型为文档创建摘要并将其作为元数据添加的 DocumentTransformer 。它可以为当前文档以及相邻文档(上一篇和下一篇)生成摘要。
用法
java
@Configuration
class EnricherConfig {
@Bean
public SummaryMetadataEnricher summaryMetadata(OpenAiChatModel aiClient) {
return new SummaryMetadataEnricher(aiClient,
List.of(SummaryType.PREVIOUS, SummaryType.CURRENT, SummaryType.NEXT));
}
}
@Component
class MySummaryEnricher {
private final SummaryMetadataEnricher enricher;
MySummaryEnricher(SummaryMetadataEnricher enricher) {
this.enricher = enricher;
}
List<Document> enrichDocuments(List<Document> documents) {
return this.enricher.apply(documents);
}
}构造函数
SummaryMetadataEnricher 提供了两个构造函数:
SummaryMetadataEnricher(ChatModel chatModel, List<SummaryType> summaryTypes)SummaryMetadataEnricher(ChatModel chatModel, List<SummaryType> summaryTypes, String summaryTemplate, MetadataMode metadataMode)
参数
chatModel: 用于生成摘要的AI模型。summaryTypes: 一个包含SummaryType枚举值的列表,用于指示生成哪些摘要(PREVIOUS、CURRENT、NEXT)。summaryTemplate: 用于摘要生成的自定义模板(可选)。metadataMode: 指定在生成摘要时如何处理文档元数据(可选)。
行为
The SummaryMetadataEnricher processes documents as follows:
- 对于每个输入文档,它都会使用文档内容和指定的摘要模板创建一个提示。
- 它将此提示发送到提供的
ChatModel以生成摘要。 - 根据指定的
summaryTypes,它会向每个文档添加以下元数据:section_summary: 当前文档的摘要。prev_section_summary: 上一份文档的摘要(如果可用且已请求)。next_section_summary: 下一个文档的摘要(如果可用且已请求)。
- 丰富的文档已返回。
自定义
摘要生成提示可以通过提供自定义的 summaryTemplate 来进行定制。默认模板为:
java
"""
Here is the content of the section:
{context_str}
Summarize the key topics and entities of the section.
Summary:
"""示例
java
ChatModel chatModel = // initialize your chat model
SummaryMetadataEnricher enricher = new SummaryMetadataEnricher(chatModel,
List.of(SummaryType.PREVIOUS, SummaryType.CURRENT, SummaryType.NEXT));
Document doc1 = new Document("Content of document 1");
Document doc2 = new Document("Content of document 2");
List<Document> enrichedDocs = enricher.apply(List.of(this.doc1, this.doc2));
// Check the metadata of the enriched documents
for (Document doc : enrichedDocs) {
System.out.println("Current summary: " + doc.getMetadata().get("section_summary"));
System.out.println("Previous summary: " + doc.getMetadata().get("prev_section_summary"));
System.out.println("Next summary: " + doc.getMetadata().get("next_section_summary"));
}所提供的示例演示了预期的行为:
- 对于两份文档的列表,这两份文档均收到
section_summary。 - 第一个文档接收一个
next_section_summary,但没有prev_section_summary。 - 第二个文档接收一个
prev_section_summary,但没有next_section_summary。 - 第一个文档的
section_summary与第二个文档的prev_section_summary匹配。 - 第一个文档的
next_section_summary与第二个文档的section_summary匹配。
注释
SummaryMetadataEnricher需要一个有效的ChatModel才能生成摘要。- 该丰富器可以处理任意大小的文档列表,并正确处理首尾文档的边界情况。
- 此增强器特别适用于创建上下文感知的摘要,有助于更好地理解序列中文档之间的关系。
MetadataMode参数允许控制如何将现有元数据纳入摘要生成过程。
编写器
文件
FileDocumentWriter 是一个 DocumentWriter 实现,用于将一组 Document 对象的内容写入文件。
用法
java
@Component
class MyDocumentWriter {
public void writeDocuments(List<Document> documents) {
FileDocumentWriter writer = new FileDocumentWriter("output.txt", true, MetadataMode.ALL, false);
writer.accept(documents);
}
}构造函数
FileDocumentWriter 提供了三个构造函数:
FileDocumentWriter(String fileName)FileDocumentWriter(String fileName, boolean withDocumentMarkers)FileDocumentWriter(String fileName, boolean withDocumentMarkers, MetadataMode metadataMode, boolean append)
参数
fileName: 要写入文档的文件名。withDocumentMarkers: 是否在输出中包含文档标记(默认:false)。metadataMode: 指定要写入文件的文档内容(默认值:MetadataMode.NONE)。append: 如果为 true,数据将写入文件末尾而非开头(默认值:false)。
行为
The FileDocumentWriter processes documents as follows:
- 它为指定的文件名打开一个 FileWriter。
- 对于输入列表中的每个文档:
- 如果
withDocumentMarkers为真,则写入一个包含文档索引和页码的文档标记。 - 它根据指定的
metadataMode写入文档的格式化内容。
- 如果
- 文件在所有文档写入完成后关闭。
文档标记
当将 withDocumentMarkers 设置为 true 时,写入器会以以下格式为每个文档包含标记:
### Doc: [index], pages:[start_page_number,end_page_number]元数据处理
编写者使用了两个特定的元数据键:
page_number: 表示文档的起始页码。end_page_number: 表示文档的结束页码。
这些用于编写文档标记时。
示例
java
List<Document> documents = // initialize your documents
FileDocumentWriter writer = new FileDocumentWriter("output.txt", true, MetadataMode.ALL, true);
writer.accept(documents);这将把所有文档写入 "output.txt",包括文档标记,使用所有可用的元数据,并在文件已存在时追加内容。
注释
- 编写器使用
FileWriter,因此它会使用操作系统的默认字符编码来写入文本文件。 - 如果在写入过程中发生错误,将抛出一个
RuntimeException,其原因包含原始异常。 metadataMode参数允许控制如何将现有元数据合并到写入的内容中。- 此编写器特别适用于调试或创建文档集合的可读性输出。
向量存储
提供与各种向量存储的集成。 请参阅 向量数据库文档 以获取完整列表。
评估测试
测试 AI 应用程序需要评估生成的内容,以确保 AI 模型没有产生幻觉响应。
一种评估响应的方法是使用AI模型本身进行评估。选择最适合用于评估的AI模型,该模型可能与生成响应所使用的模型不同。
Spring AI用于评估响应的接口值为 Evaluator,定义如下:
java
@FunctionalInterface
public interface Evaluator {
EvaluationResponse evaluate(EvaluationRequest evaluationRequest);
}评估的输入是定义为 EvaluationRequest 的
java
public class EvaluationRequest {
private final String userText;
private final List<Content> dataList;
private final String responseContent;
public EvaluationRequest(String userText, List<Content> dataList, String responseContent) {
this.userText = userText;
this.dataList = dataList;
this.responseContent = responseContent;
}
...
}userText: 用户的原始输入作为StringdataList: 上下文数据,例如来自检索增强生成的数据,附加到原始输入。responseContent: AI模型的响应内容作为String
相关性评估器
The RelevancyEvaluator is an implementation of the Evaluator interface, designed to assess the relevance of AI-generated responses against provided context. This evaluator helps assess the quality of a RAG flow by determining if the AI model’s response is relevant to the user’s input with respect to the retrieved context.
评估基于用户输入、AI模型的响应以及上下文信息。它使用一个提示模板来询问AI模型,其响应是否与用户输入和上下文相关。
这是由 RelevancyEvaluator 使用的默认提示模板:
text
Your task is to evaluate if the response for the query
is in line with the context information provided.
You have two options to answer. Either YES or NO.
Answer YES, if the response for the query
is in line with context information otherwise NO.
Query:
{query}
Response:
{response}
Context:
{context}
Answer:您可以使用 .promptTemplate() 构建器方法提供您自己的 PromptTemplate 对象,以自定义提示模板。有关详细信息,请参阅 自定义模板 。 |
|---|
集成测试中的用法
以下是集成测试中使用 RelevancyEvaluator 的示例,用于验证使用 RetrievalAugmentationAdvisor 的RAG流程结果:
java
@Test
void evaluateRelevancy() {
String question = "Where does the adventure of Anacletus and Birba take place?";
RetrievalAugmentationAdvisor ragAdvisor = RetrievalAugmentationAdvisor.builder()
.documentRetriever(VectorStoreDocumentRetriever.builder()
.vectorStore(pgVectorStore)
.build())
.build();
ChatResponse chatResponse = ChatClient.builder(chatModel).build()
.prompt(question)
.advisors(ragAdvisor)
.call()
.chatResponse();
EvaluationRequest evaluationRequest = new EvaluationRequest(
// The original user question
question,
// The retrieved context from the RAG flow
chatResponse.getMetadata().get(RetrievalAugmentationAdvisor.DOCUMENT_CONTEXT),
// The AI model's response
chatResponse.getResult().getOutput().getText()
);
RelevancyEvaluator evaluator = new RelevancyEvaluator(ChatClient.builder(chatModel));
EvaluationResponse evaluationResponse = evaluator.evaluate(evaluationRequest);
assertThat(evaluationResponse.isPass()).isTrue();
}您可以在 Spring AI 项目中找到多个集成测试,这些测试使用 RelevancyEvaluator 来测试 QuestionAnswerAdvisor 的功能(参见 tests )和 RetrievalAugmentationAdvisor 的功能(参见 tests)。
自定义模板
The RelevancyEvaluator uses a default template to prompt the AI model for evaluation. You can customize this behavior by providing your own PromptTemplate object via the .promptTemplate() builder method.
自定义的 PromptTemplate 可以使用任何 TemplateRenderer 实现(默认情况下,它会基于 StringTemplate 引擎使用 StPromptTemplate )。重要要求是模板必须包含以下占位符:
- a
queryplaceholder to receive the user question. - a
responseplaceholder to receive the AI model’s response. - 一个
context占位符,用于接收上下文信息。
事实核查评估器
FactCheckingEvaluator 是 Evaluator 接口的另一种实现,旨在根据提供的上下文评估 AI 生成响应的事实准确性。该评估器通过验证给定的陈述(主张)是否由提供的上下文(文档)逻辑支持,从而帮助检测并减少 AI 输出中的幻觉现象。
“claim”和“document”被提交给AI模型进行评估。目前已有专门用于此目的的更小、更高效的AI模型,例如Bespoke的Minicheck,它有助于降低执行此类检查的成本,相比GPT-4等旗舰模型更具优势。此外,Minicheck也可通过Ollama使用。
用法
FactCheckingEvaluator 的构造函数接受一个 ChatClient.Builder 作为参数:
java
public FactCheckingEvaluator(ChatClient.Builder chatClientBuilder) {
this.chatClientBuilder = chatClientBuilder;
}评估器使用以下提示模板进行事实核查:
text
Document: {document}
Claim: {claim}其中 {document} 是上下文信息, {claim} 是待评估的AI模型响应。
示例
以下是如何将 FactCheckingEvaluator 与基于 Ollama 的 ChatModel,特别是 Bespoke-Minicheck 模型一起使用的示例:
java
@Test
void testFactChecking() {
// Set up the Ollama API
OllamaApi ollamaApi = new OllamaApi("http://localhost:11434");
ChatModel chatModel = new OllamaChatModel(ollamaApi,
OllamaChatOptions.builder().model(BESPOKE_MINICHECK).numPredict(2).temperature(0.0d).build())
// Create the FactCheckingEvaluator
var factCheckingEvaluator = new FactCheckingEvaluator(ChatClient.builder(chatModel));
// Example context and claim
String context = "The Earth is the third planet from the Sun and the only astronomical object known to harbor life.";
String claim = "The Earth is the fourth planet from the Sun.";
// Create an EvaluationRequest
EvaluationRequest evaluationRequest = new EvaluationRequest(context, Collections.emptyList(), claim);
// Perform the evaluation
EvaluationResponse evaluationResponse = factCheckingEvaluator.evaluate(evaluationRequest);
assertFalse(evaluationResponse.isPass(), "The claim should not be supported by the context");
}向量数据库
向量数据库是一种专门的数据库类型,在人工智能应用中发挥着至关重要的作用。
在向量数据库中,查询与传统关系型数据库不同。 它们不进行精确匹配,而是执行相似性搜索。 当给定一个向量作为查询时,向量数据库会返回与该查询向量“相似”的向量。 关于如何在高层次上计算这种相似性的更多详细信息,请参阅 向量相似性 。
向量数据库用于将您的数据与AI模型集成。 使用它们的第一步是将您的数据加载到向量数据库中。 然后,当用户查询要发送给AI模型时,会首先检索出一组相似的文档。 这些文档随后作为用户问题的上下文,并与用户的查询一起发送给AI模型。 这种技术被称为 检索增强生成(RAG) 。
以下各节将介绍用于使用多种向量数据库实现的 Spring AI 接口,以及一些高级示例用法。
最后一节旨在揭示向量数据库中相似性搜索的底层方法。
API概述
本节作为 Spring AI 框架中 VectorStore 接口及其相关类的指南。
Spring AI 提供了一个抽象化的 API,用于通过 VectorStore 接口及其只读对应接口 VectorStoreRetriever 与向量数据库进行交互。
向量存储检索器接口
Spring AI 提供了一个只读接口,称为 VectorStoreRetriever,该接口仅暴露文档检索功能:
java
@FunctionalInterface
public interface VectorStoreRetriever {
List<Document> similaritySearch(SearchRequest request);
default List<Document> similaritySearch(String query) {
return this.similaritySearch(SearchRequest.builder().query(query).build());
}
}该函数式接口专为仅需从向量存储中检索文档而无需执行任何修改操作的用例设计。它遵循最小权限原则,仅暴露文档检索所需的必要功能。
向量存储接口
The VectorStore interface extends VectorStoreRetriever and adds mutation capabilities:
java
public interface VectorStore extends DocumentWriter, VectorStoreRetriever {
default String getName() {
return this.getClass().getSimpleName();
}
void add(List<Document> documents);
void delete(List<String> idList);
void delete(Filter.Expression filterExpression);
default void delete(String filterExpression) { ... }
default <T> Optional<T> getNativeClient() {
return Optional.empty();
}
}The VectorStore interface combines both read and write operations, allowing you to add, delete, and search for documents in a vector database.
搜索请求构建器
java
public class SearchRequest {
public static final double SIMILARITY_THRESHOLD_ACCEPT_ALL = 0.0;
public static final int DEFAULT_TOP_K = 4;
private String query = "";
private int topK = DEFAULT_TOP_K;
private double similarityThreshold = SIMILARITY_THRESHOLD_ACCEPT_ALL;
@Nullable
private Filter.Expression filterExpression;
public static Builder from(SearchRequest originalSearchRequest) {
return builder().query(originalSearchRequest.getQuery())
.topK(originalSearchRequest.getTopK())
.similarityThreshold(originalSearchRequest.getSimilarityThreshold())
.filterExpression(originalSearchRequest.getFilterExpression());
}
public static class Builder {
private final SearchRequest searchRequest = new SearchRequest();
public Builder query(String query) {
Assert.notNull(query, "Query can not be null.");
this.searchRequest.query = query;
return this;
}
public Builder topK(int topK) {
Assert.isTrue(topK >= 0, "TopK should be positive.");
this.searchRequest.topK = topK;
return this;
}
public Builder similarityThreshold(double threshold) {
Assert.isTrue(threshold >= 0 && threshold <= 1, "Similarity threshold must be in [0,1] range.");
this.searchRequest.similarityThreshold = threshold;
return this;
}
public Builder similarityThresholdAll() {
this.searchRequest.similarityThreshold = 0.0;
return this;
}
public Builder filterExpression(@Nullable Filter.Expression expression) {
this.searchRequest.filterExpression = expression;
return this;
}
public Builder filterExpression(@Nullable String textExpression) {
this.searchRequest.filterExpression = (textExpression != null)
? new FilterExpressionTextParser().parse(textExpression) : null;
return this;
}
public SearchRequest build() {
return this.searchRequest;
}
}
public String getQuery() {...}
public int getTopK() {...}
public double getSimilarityThreshold() {...}
public Filter.Expression getFilterExpression() {...}
}要将数据插入向量数据库,需将其封装在 Document 对象中。 Document 类封装来自数据源的内容,例如PDF或Word文档,并包含以字符串形式表示的文本。 它还包含键值对形式的元数据,包括文件名等详细信息。
在插入向量数据库时,文本内容会通过嵌入模型转换为一个数值数组,即 float[],称为向量嵌入。嵌入模型,例如 Word2Vec 、 GLoVE 和 BERT,或OpenAI的 text-embedding-ada-002,用于将单词、句子或段落转换为这些向量嵌入。
向量数据库的作用是存储并促进这些嵌入的相似性搜索。它本身并不生成嵌入。要创建向量嵌入,应使用 EmbeddingModel 。
接口中的 similaritySearch 方法允许根据给定的查询字符串检索文档。可以通过使用以下参数对这些方法进行微调:
k: 一个整数,用于指定要返回的相似文档的最大数量。这通常被称为“前 K”搜索,或“K 最近邻”(KNN)。threshold: 一个介于0到1之间的双精度值,数值越接近1表示相似度越高。默认情况下,如果您设置阈值为0.75,例如,则仅返回相似度高于该值的文档。Filter.Expression: 一个用于传递流畅的DSL(领域特定语言)表达式的类,其功能类似于SQL中的“where”子句,但仅适用于Document的元数据键值对。filterExpression: 一个基于 ANTLR4 的外部 DSL,接受过滤器表达式作为字符串。例如,对于诸如 country、year 和isActive等元数据键,您可以使用如下表达式:country == 'UK' && year >= 2020 && isActive == true.
在 Filter.Expression 中查找更多关于 元数据筛选器 的信息。
架构初始化
某些向量存储在使用前需要初始化其后端模式。 默认情况下不会为您初始化。 您必须选择加入,通过为相应的构造函数参数传递 boolean ;或者,如果使用 Spring Boot,则在 application.properties 或 application.yml 中将适当的 initialize-schema 属性设置为 true 。 请查阅您正在使用的向量存储的文档以获取具体的属性名称。
批处理策略
在使用向量存储时,通常需要对大量文档进行嵌入。 虽然看似只需调用一次即可一次性完成所有文档的嵌入,但这种做法可能会引发问题。 嵌入模型会将文本处理为标记,并且存在一个最大标记限制,通常称为上下文窗口大小。 这一限制会制约单次嵌入请求所能处理的文本量。 如果尝试在一次调用中嵌入过多的标记,可能会导致错误或嵌入被截断。
为了解决这一标记限制,Spring AI 实现了批处理策略。 这种方法将大型文档集拆分为较小的批次,使其能够适应嵌入模型的最大上下文窗口。 批处理不仅解决了标记限制问题,还能提升性能并更高效地利用 API 速率限制。
Spring AI 通过 BatchingStrategy 接口提供此功能,该接口允许根据文档的标记数量将其分批处理。
核心 BatchingStrategy 接口定义如下:
java
public interface BatchingStrategy {
List<List<Document>> batch(List<Document> documents);
}此接口定义了一个单方法 batch,该方法接收一个文档列表并返回一个文档批次列表。
默认实现
Spring AI 提供了一个名为 TokenCountBatchingStrategy 的默认实现。 该策略根据文档的标记数量对文档进行分批处理,确保每个批次不超过计算出的最大输入标记数量。
TokenCountBatchingStrategy 的关键特性:
- 使用 OpenAI 的最大输入标记数 (8191)作为默认上限。
- 包含一个预留百分比(默认为10%),以提供潜在开销的缓冲。
- 计算实际的最大输入标记数为:
actualMaxInputTokenCount = originalMaxInputTokenCount * (1 - RESERVE_PERCENTAGE)
该策略会估算每份文档的标记数,将其分组为批次,且每个批次的标记数不超过最大输入标记数;如果单份文档的标记数超过此限制,则抛出异常。
您也可以自定义 TokenCountBatchingStrategy,以更好地满足您的特定需求。这可以通过在 Spring Boot @Configuration 类中创建一个带有自定义参数的新实例来实现。
以下是一个如何创建自定义 TokenCountBatchingStrategy Bean 的示例:
java
@Configuration
public class EmbeddingConfig {
@Bean
public BatchingStrategy customTokenCountBatchingStrategy() {
return new TokenCountBatchingStrategy(
EncodingType.CL100K_BASE, // Specify the encoding type
8000, // Set the maximum input token count
0.1 // Set the reserve percentage
);
}
}在此配置中:
EncodingType.CL100K_BASE: 指定用于分词的编码类型。此编码类型由JTokkitTokenCountEstimator使用,以准确估计词元数量。8000: 设置最大输入标记数。该值应小于或等于您的嵌入模型的最大上下文窗口大小。0.1: 设置保留百分比。从最大输入标记数中保留的标记百分比。这会在处理过程中为潜在的标记数增加创建一个缓冲区。
默认情况下,此构造函数使用 Document.DEFAULT_CONTENT_FORMATTER 进行内容格式化,使用 MetadataMode.NONE 进行元数据处理。如果您需要自定义这些参数,可以使用带有附加参数的完整构造函数。
一旦定义,这个自定义的 TokenCountBatchingStrategy bean 将会自动被您应用程序中的 EmbeddingModel 实现使用,以替换默认策略。
The TokenCountBatchingStrategy internally uses a TokenCountEstimator (specifically, JTokkitTokenCountEstimator) to calculate token counts for efficient batching. This ensures accurate token estimation based on the specified encoding type.
此外, TokenCountBatchingStrategy 提供了灵活性,允许您传入自己的 TokenCountEstimator 接口实现。此功能使您可以使用根据自身需求量身定制的自定义Tokens计数策略。例如:
java
TokenCountEstimator customEstimator = new YourCustomTokenCountEstimator();
TokenCountBatchingStrategy strategy = new TokenCountBatchingStrategy(
this.customEstimator,
8000, // maxInputTokenCount
0.1, // reservePercentage
Document.DEFAULT_CONTENT_FORMATTER,
MetadataMode.NONE
);使用自动截断
一些嵌入模型,例如 Vertex AI 文本嵌入,支持一个 auto_truncate 功能。启用时,该模型会静默截断超过最大长度的文本输入并继续处理;禁用时,则会对过大的输入抛出明确的错误。
当使用带有批处理策略的自动截断时,您必须将批处理策略的输入标记数配置为远高于模型的实际最大值。这样可以防止批处理策略因大文档而抛出异常,从而使嵌入模型能够在内部处理截断。
自动截断的配置
启用自动截断时,请将批处理策略的最大输入标记数设置为远高于模型的实际限制。这样可以防止批处理策略因大文档而抛出异常,从而使嵌入模型能够在内部处理截断。
以下是使用 Vertex AI 并启用自动截断以及自定义 BatchingStrategy 的示例配置,然后在 PgVectorStore 中使用它们:
java
@Configuration
public class AutoTruncationEmbeddingConfig {
@Bean
public VertexAiTextEmbeddingModel vertexAiEmbeddingModel(
VertexAiEmbeddingConnectionDetails connectionDetails) {
VertexAiTextEmbeddingOptions options = VertexAiTextEmbeddingOptions.builder()
.model(VertexAiTextEmbeddingOptions.DEFAULT_MODEL_NAME)
.autoTruncate(true) // Enable auto-truncation
.build();
return new VertexAiTextEmbeddingModel(connectionDetails, options);
}
@Bean
public BatchingStrategy batchingStrategy() {
// Only use a high token limit if auto-truncation is enabled in your embedding model.
// Set a much higher token count than the model actually supports
// (e.g., 132,900 when Vertex AI supports only up to 20,000)
return new TokenCountBatchingStrategy(
EncodingType.CL100K_BASE,
132900, // Artificially high limit
0.1 // 10% reserve
);
}
@Bean
public VectorStore vectorStore(JdbcTemplate jdbcTemplate, EmbeddingModel embeddingModel, BatchingStrategy batchingStrategy) {
return PgVectorStore.builder(jdbcTemplate, embeddingModel)
// other properties omitted here
.build();
}
}在此配置中:
- 嵌入模型已启用自动截断功能,使其能够优雅地处理过大的输入。
- 批处理策略使用了一个人为设定的高标记限制(132,900),远高于实际模型的限制(20,000)。
- 向量存储使用配置的嵌入模型和自定义的
BatchingStrategybean。
为什么这有效
这种方法之所以有效,是因为:
- The
TokenCountBatchingStrategychecks if any single document exceeds the configured maximum and throws anIllegalArgumentExceptionif it does. - 通过在批处理策略中设置一个非常高的限制,我们确保此检查永远不会失败。
- 超过模型限制的文档或批次将被静默截断,并由嵌入模型的自动截断功能进行处理。
最佳实践
当使用自动截断时:
- 将批处理策略的最大输入标记数设置为至少是模型实际限制的 5 到 10 倍,以避免因批处理策略过早触发异常。
- 监控嵌入模型的截断警告日志(注意:并非所有模型都会记录截断事件)。
- 请考虑静默截断对您的嵌入质量的影响。
- 使用示例文档进行测试,以确保截断后的嵌入仍然符合您的要求。
- 请为未来的维护人员记录此配置,因为它是非标准的。
| 虽然自动截断可以防止错误,但它可能导致嵌入不完整。长文档末尾的重要信息可能会丢失。如果您的应用程序要求将所有内容都进行嵌入,请在嵌入之前将文档拆分为更小的片段。 |
|---|
Spring Boot 自动配置
如果您正在使用 Spring Boot 自动配置,您必须提供一个自定义的 BatchingStrategy Bean 来覆盖 Spring AI 默认提供的那个:
java
@Bean
public BatchingStrategy customBatchingStrategy() {
// This bean will override the default BatchingStrategy
return new TokenCountBatchingStrategy(
EncodingType.CL100K_BASE,
132900, // Much higher than model's actual limit
0.1
);
}该 Bean 在您的应用程序上下文中存在时,将自动替换所有向量存储使用的默认批处理策略。
自定义实现
虽然 TokenCountBatchingStrategy 提供了一个强大的默认实现,但您可以根据具体需求自定义批处理策略。 这可以通过 Spring Boot 的自动配置来完成。
要自定义批处理策略,请在您的 Spring Boot 应用程序中定义一个 BatchingStrategy Bean:
java
@Configuration
public class EmbeddingConfig {
@Bean
public BatchingStrategy customBatchingStrategy() {
return new CustomBatchingStrategy();
}
}这个自定义的 BatchingStrategy 随后将被您应用程序中的 EmbeddingModel 实现自动使用。
Spring AI 支持的向量存储已配置为使用默认值 TokenCountBatchingStrategy 。 SAP Hana 向量存储目前未配置为批量处理。 |
|---|
向量存储实现
这些是 VectorStore 接口的可用实现:
- Azure 向量搜索 - Azure 向量存储。
- Apache Cassandra - 该 Apache Cassandra 向量存储。
- Chroma向量存储 - Chroma 向量存储。
- Elasticsearch 向量存储 - Elasticsearch 的向量存储。
- GemFire 向量存储 - GemFire 向量存储。
- MariaDB 向量存储 - MariaDB 的向量存储。
- Milvus 向量存储 - Milvus 的向量存储。
- MongoDB Atlas 向量存储 - MongoDB Atlas 的向量存储。
- Neo4j 向量存储 - Neo4j 的向量存储。
- OpenSearch 向量存储 - OpenSearch 的向量存储。
- Oracle 向量存储 - Oracle 数据库 的向量存储。
- PgVector 存储 - 一个 PostgreSQL/PGVector 向量存储。
- Pinecone向量存储 - Pinecone 向量存储。
- Qdrant 向量存储 - Qdrant 向量存储。
- Redis 向量存储 - Redis 向量存储。
- SAP Hana 向量存储 - SAP HANA 向量存储。
- Typesense 向量存储 - Typesense 的向量存储。
- Weaviate 向量存储 - Weaviate 的向量存储。
- SimpleVectorStore - 一种简单的持久化向量存储实现,适合用于教学目的。
未来版本可能会支持更多实现。
如果您有一个需要由 Spring AI 支持的向量数据库,请在 GitHub 上提交一个问题,或者更好的是,提交一个包含实现的拉取请求。
关于每个 VectorStore 实现的信息可以在本章的子章节中找到。
示例用法
要为向量数据库计算嵌入,您需要选择一个与所使用的高级 AI 模型相匹配的嵌入模型。
例如,对于 OpenAI 的 ChatGPT,我们使用 OpenAiEmbeddingModel 和一个名为 text-embedding-ada-002 的模型。
Spring Boot Starter 对 OpenAI 的自动配置会在 Spring 应用程序上下文中提供一个 EmbeddingModel 实现,以便进行依赖注入。
写入向量存储
将数据加载到向量存储中的通用用法通常是在批处理作业中完成的,首先将数据加载到 Spring AI 的 Document 类中,然后调用 add 接口上的 VectorStore 方法。
给定一个指向源文件的 String 引用,该源文件是一个包含我们希望加载到向量数据库中的数据的JSON文件,我们使用Spring AI的 JsonReader 来加载JSON中的特定字段,将其拆分成小片段,然后将这些小片段传递给向量存储实现。 VectorStore 实现会计算嵌入并向量数据库中存储JSON和嵌入:
java
@Autowired
VectorStore vectorStore;
void load(String sourceFile) {
JsonReader jsonReader = new JsonReader(new FileSystemResource(sourceFile),
"price", "name", "shortDescription", "description", "tags");
List<Document> documents = jsonReader.get();
this.vectorStore.add(documents);
}从向量存储中读取
随后,当用户问题被传递到 AI 模型时,会执行一次相似性搜索以检索相似的文档,并将这些文档“填充”到提示中,作为用户问题的上下文。
对于只读操作,您可以使用 VectorStore 接口或更专注的 VectorStoreRetriever 接口:
java
@Autowired
VectorStoreRetriever retriever; // Could also use VectorStore here
String question = "<question from user>";
List<Document> similarDocuments = retriever.similaritySearch(question);
// Or with more specific search parameters
SearchRequest request = SearchRequest.builder()
.query(question)
.topK(5) // Return top 5 results
.similarityThreshold(0.7) // Only return results with similarity score >= 0.7
.build();
List<Document> filteredDocuments = retriever.similaritySearch(request);可以将其他选项传递到 similaritySearch 方法中,以定义要检索的文档数量以及相似性搜索的阈值。
读写操作的分离
使用独立的接口可以让您清晰地定义哪些组件需要写访问权限,哪些只需要读访问权限:
java
// Write operations in a service that needs full access
@Service
class DocumentIndexer {
private final VectorStore vectorStore;
DocumentIndexer(VectorStore vectorStore) {
this.vectorStore = vectorStore;
}
public void indexDocuments(List<Document> documents) {
vectorStore.add(documents);
}
}
// Read-only operations in a service that only needs retrieval
@Service
class DocumentRetriever {
private final VectorStoreRetriever retriever;
DocumentRetriever(VectorStoreRetriever retriever) {
this.retriever = retriever;
}
public List<Document> findSimilar(String query) {
return retriever.similaritySearch(query);
}
}这种关注点分离通过将对变更操作的访问权限仅限于真正需要它们的组件,有助于创建更易于维护且更安全的应用程序。
使用VectorStoreRetriever的检索操作
The VectorStoreRetriever interface provides a read-only view of a vector store, exposing only the similarity search functionality. This follows the principle of least privilege and is particularly useful in RAG (Retrieval-Augmented Generation) applications where you only need to retrieve documents without modifying the underlying data.
使用VectorStoreRetriever的优势
- 关注点分离 :清晰地将读操作与写操作分开。
- 接口隔离 :仅需要检索功能的客户端不会被暴露给修改方法。
- 函数式接口 :对于简单用例,可以使用 Lambda 表达式或方法引用实现。
- 减少依赖 :仅需执行搜索的组件无需依赖完整的
VectorStore接口。
示例用法
您可以直接使用 VectorStoreRetriever ,当您只需要执行相似性搜索时:
java
@Service
public class DocumentRetrievalService {
private final VectorStoreRetriever retriever;
public DocumentRetrievalService(VectorStoreRetriever retriever) {
this.retriever = retriever;
}
public List<Document> findSimilarDocuments(String query) {
return retriever.similaritySearch(query);
}
public List<Document> findSimilarDocumentsWithFilters(String query, String country) {
SearchRequest request = SearchRequest.builder()
.query(query)
.topK(5)
.filterExpression("country == '" + country + "'")
.build();
return retriever.similaritySearch(request);
}
}在本示例中,该服务仅依赖于 VectorStoreRetriever 接口,因此可以明确其仅执行检索操作,而不会修改向量存储。
与RAG应用程序的集成
The VectorStoreRetriever interface is particularly useful in RAG applications, where you need to retrieve relevant documents to provide context for an AI model:
java
@Service
public class RagService {
private final VectorStoreRetriever retriever;
private final ChatModel chatModel;
public RagService(VectorStoreRetriever retriever, ChatModel chatModel) {
this.retriever = retriever;
this.chatModel = chatModel;
}
public String generateResponse(String userQuery) {
// Retrieve relevant documents
List<Document> relevantDocs = retriever.similaritySearch(userQuery);
// Extract content from documents to use as context
String context = relevantDocs.stream()
.map(Document::getContent)
.collect(Collectors.joining("\n\n"));
// Generate response using the retrieved context
String prompt = "Context information:\n" + context + "\n\nUser query: " + userQuery;
return chatModel.generate(prompt);
}
}这种模式使得在 RAG 应用中能够清晰地将检索组件与生成组件分离。
元数据过滤器
本节介绍可用于对查询结果进行各种过滤的筛选器。
筛选字符串
您可以将类似 SQL 的筛选表达式作为 String 传递给其中一个 similaritySearch 重载。
请参阅以下示例:
"country == 'BG'""genre == 'drama' && year >= 2020""genre in ['comedy', 'documentary', 'drama']"
筛选表达式
您可以使用一个暴露流畅API的 FilterExpressionBuilder 来创建 Filter.Expression 的实例。 一个简单的示例如下:
java
FilterExpressionBuilder b = new FilterExpressionBuilder();
Expression expression = this.b.eq("country", "BG").build();您可以使用以下运算符构建复杂的表达式:
text
EQUALS: '=='
MINUS : '-'
PLUS: '+'
GT: '>'
GE: '>='
LT: '<'
LE: '<='
NE: '!='您可以使用以下运算符来组合表达式:
text
AND: 'AND' | 'and' | '&&';
OR: 'OR' | 'or' | '||';考虑到以下示例:
java
Expression exp = b.and(b.eq("genre", "drama"), b.gte("year", 2020)).build();您还可以使用以下运算符:
text
IN: 'IN' | 'in';
NIN: 'NIN' | 'nin';
NOT: 'NOT' | 'not';请考虑以下示例:
java
Expression exp = b.and(b.in("genre", "drama", "documentary"), b.not(b.lt("year", 2020))).build();您还可以使用以下运算符:
text
IS: 'IS' | 'is';
NULL: 'NULL' | 'null';
NOT NULL: 'NOT NULL' | 'not null';请考虑以下示例:
java
Expression exp = b.and(b.isNull("year")).build();
Expression exp = b.and(b.isNotNull("year")).build();IS NULL 和 IS NOT NULL 尚未在所有向量存储中实现。 |
|---|
从向量存储中删除文档
向量存储接口提供了多种删除文档的方法,允许你通过特定的文档ID或使用过滤表达式来移除数据。
通过文档ID删除
删除文档最简单的方法是提供一个文档 ID 列表:
java
void delete(List<String> idList);此方法会删除所有ID在所提供列表中的文档。 如果列表中的任何ID在存储中不存在,则该ID将被忽略。
java
// Create and add document
Document document = new Document("The World is Big",
Map.of("country", "Netherlands"));
vectorStore.add(List.of(document));
// Delete document by ID
vectorStore.delete(List.of(document.getId()));根据筛选条件删除
对于更复杂的删除条件,可以使用过滤表达式:
java
void delete(Filter.Expression filterExpression);此方法接受一个 Filter.Expression 对象,该对象定义了应删除哪些文档的条件。 当需要根据文档的元数据属性删除文档时,此方法特别有用。
java
// Create test documents with different metadata
Document bgDocument = new Document("The World is Big",
Map.of("country", "Bulgaria"));
Document nlDocument = new Document("The World is Big",
Map.of("country", "Netherlands"));
// Add documents to the store
vectorStore.add(List.of(bgDocument, nlDocument));
// Delete documents from Bulgaria using filter expression
Filter.Expression filterExpression = new Filter.Expression(
Filter.ExpressionType.EQ,
new Filter.Key("country"),
new Filter.Value("Bulgaria")
);
vectorStore.delete(filterExpression);
// Verify deletion with search
SearchRequest request = SearchRequest.builder()
.query("World")
.filterExpression("country == 'Bulgaria'")
.build();
List<Document> results = vectorStore.similaritySearch(request);
// results will be empty as Bulgarian document was deleted通过字符串筛选表达式删除
为方便起见,您也可以使用基于字符串的过滤表达式来删除文档:
java
void delete(String filterExpression);此方法在内部将提供的字符串过滤器转换为 Filter.Expression 对象。 当你以字符串格式拥有过滤条件时,此方法非常有用。
java
// Create and add documents
Document bgDocument = new Document("The World is Big",
Map.of("country", "Bulgaria"));
Document nlDocument = new Document("The World is Big",
Map.of("country", "Netherlands"));
vectorStore.add(List.of(bgDocument, nlDocument));
// Delete Bulgarian documents using string filter
vectorStore.delete("country == 'Bulgaria'");
// Verify remaining documents
SearchRequest request = SearchRequest.builder()
.query("World")
.topK(5)
.build();
List<Document> results = vectorStore.similaritySearch(request);
// results will only contain the Netherlands document调用删除API时的错误处理
所有删除方法在出现错误时可能会抛出异常:
最佳实践是将删除操作封装在 try-catch 代码块中:
java
try {
vectorStore.delete("country == 'Bulgaria'");
}
catch (Exception e) {
logger.error("Invalid filter expression", e);
}文档版本控制用例
一个常见的场景是管理文档版本,你需要上传文档的新版本,同时删除旧版本。以下是使用过滤表达式来处理此问题的方法:
java
// Create initial document (v1) with version metadata
Document documentV1 = new Document(
"AI and Machine Learning Best Practices",
Map.of(
"docId", "AIML-001",
"version", "1.0",
"lastUpdated", "2024-01-01"
)
);
// Add v1 to the vector store
vectorStore.add(List.of(documentV1));
// Create updated version (v2) of the same document
Document documentV2 = new Document(
"AI and Machine Learning Best Practices - Updated",
Map.of(
"docId", "AIML-001",
"version", "2.0",
"lastUpdated", "2024-02-01"
)
);
// First, delete the old version using filter expression
Filter.Expression deleteOldVersion = new Filter.Expression(
Filter.ExpressionType.AND,
Arrays.asList(
new Filter.Expression(
Filter.ExpressionType.EQ,
new Filter.Key("docId"),
new Filter.Value("AIML-001")
),
new Filter.Expression(
Filter.ExpressionType.EQ,
new Filter.Key("version"),
new Filter.Value("1.0")
)
)
);
vectorStore.delete(deleteOldVersion);
// Add the new version
vectorStore.add(List.of(documentV2));
// Verify only v2 exists
SearchRequest request = SearchRequest.builder()
.query("AI and Machine Learning")
.filterExpression("docId == 'AIML-001'")
.build();
List<Document> results = vectorStore.similaritySearch(request);
// results will contain only v2 of the document你也可以使用字符串过滤表达式来实现相同的效果:
java
// Delete old version using string filter
vectorStore.delete("docId == 'AIML-001' AND version == '1.0'");
// Add new version
vectorStore.add(List.of(documentV2));删除文档时的性能考虑
- 当您确切知道需要删除哪些文档时,按 ID 列表删除通常速度更快。
- 基于过滤器的删除可能需要扫描索引来查找匹配的文档;但是,这取决于具体的向量存储实现。
- 大规模删除操作应进行分批处理,以避免系统过载。
- 在根据文档属性进行删除时,考虑使用过滤表达式,而不是先收集ID。
可观测性
Spring AI 基于 Spring 生态中的可观测性功能,为 AI 相关的运维提供洞察。
启用可观测性需要 spring-boot-actuator 模块。 将 Spring Boot Actuator 依赖项添加到项目的 Maven pom.xml 构建文件中:
xml
<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-starter-actuator</artifactId>
</dependency>或者添加到您的Gradle 构建脚本文件 中。
groovy
dependencies {
implementation 'org.springframework.boot:spring-boot-starter-actuator'
}Spring AI 为其核心组件提供指标和跟踪功能: ChatClient (包括 Advisor ), ChatModel 、 EmbeddingModel 、 ImageModel 和 VectorStore 。
| 低基数键将被添加到指标和跟踪中,而高基数键仅会被添加到跟踪中。 |
|---|
1.0.0-RC1 重大变更 以下配置属性已被重命名,以更好地反映其用途: - spring.ai.chat.client.observations.include-prompt → spring.ai.chat.client.observations.log-prompt - spring.ai.chat.observations.include-prompt → spring.ai.chat.observations.log-prompt - spring.ai.chat.observations.include-completion → spring.ai.chat.observations.log-completion - spring.ai.image.observations.include-prompt → spring.ai.image.observations.log-prompt - spring.ai.vectorstore.observations.include-query-response → spring.ai.vectorstore.observations.log-query-response |
|---|
ChatClient
当调用 ChatClient 的 call() 或 stream() 操作时,会记录 spring.ai.chat.client 条观测。 它们用于测量执行调用所花费的时间,并传播相关的跟踪信息。
| 名称 | 描述 |
|---|---|
gen_ai.operation.name | 始终 framework 。 |
gen_ai.system | 始终 spring_ai 。 |
spring.ai.chat.client.stream | 聊天模型的响应是否为流 - true or false |
spring.ai.kind | Spring AI 中的框架 API 类型: chat_client 。 |
| 名称 | 描述 |
|---|---|
gen_ai.prompt | 通过聊天客户端发送的提示内容。可选。 |
spring.ai.chat.client.advisor.params (已弃用) | 顾问参数映射。会话ID现在包含在 spring.ai.chat.client.conversation.id 中。 |
spring.ai.chat.client.advisors | 已配置的聊天客户端顾问列表。 |
spring.ai.chat.client.conversation.id | 使用聊天记忆时的会话标识符。 |
spring.ai.chat.client.system.params (已弃用) | 聊天客户端系统参数。可选。已被 gen_ai.prompt 取代。 |
spring.ai.chat.client.system.text (已弃用) | 聊天客户端系统文本。可选。已被 gen_ai.prompt 取代。 |
spring.ai.chat.client.tool.function.names (已弃用) | 启用的工具函数名称。已被 spring.ai.chat.client.tool.names 取代。 |
spring.ai.chat.client.tool.function.callbacks (已弃用) | 已配置的聊天客户端函数回调列表。已被 spring.ai.chat.client.tool.names 取代。 |
spring.ai.chat.client.tool.names | 传递给聊天客户端的工具名称。 |
spring.ai.chat.client.user.params (已弃用) | 聊天客户端用户参数。可选。已被 gen_ai.prompt 取代。 |
spring.ai.chat.client.user.text (已弃用) | 聊天客户端用户文本。可选。已被 gen_ai.prompt 取代。 |
提示与完成数据
ChatClient 提示和补全数据通常较大,并且可能包含敏感信息。 出于这些原因,它默认不会被导出。
Spring AI 支持将提示和完成数据记录到日志中,以帮助调试和故障排除。
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.chat.client.observations.log-prompt | 是否记录聊天客户端提示内容。 | false |
spring.ai.chat.client.observations.log-completion | 是否记录聊天客户端完成内容。 | false |
| 如果您启用聊天客户端提示和完成数据的日志记录,可能会存在泄露敏感或隐私信息的风险。请务必谨慎! |
|---|
输入数据(已弃用)
spring.ai.chat.client.observations.include-input 属性已弃用,由 spring.ai.chat.client.observations.log-prompt 取代。请参阅 提示内容 。 |
|---|
输入数据 ChatClient 通常较大,并且可能包含敏感信息。 出于这些原因,它默认不会被导出。
Spring AI 支持将输入数据记录到日志中,以帮助调试和故障排除。
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.chat.client.observations.include-input | 是否在观测中包含输入内容。 | false |
| 如果您启用在观测中包含输入内容的功能,可能会存在泄露敏感或隐私信息的风险。请务必谨慎! |
|---|
聊天客户端顾问
当执行顾问时,会记录 spring.ai.advisor 个观测值。 它们用于测量顾问的耗时(包括在内部顾问上花费的时间),并传播相关的跟踪信息。
| 名称 | 描述 |
|---|---|
gen_ai.operation.name | 始终 framework 。 |
gen_ai.system | 始终 spring_ai 。 |
spring.ai.advisor.type (已弃用) | 在请求处理过程中,顾问应用其逻辑的位置为 BEFORE 、 AFTER 或 AROUND 中的一个。自所有顾问始终属于同一类型以来,这一区分已不再适用。 |
spring.ai.kind | Spring AI 中的框架 API 类型: advisor 。 |
| 名称 | 描述 |
|---|---|
spring.ai.advisor.name | 顾问的姓名。 |
spring.ai.advisor.order | 顾问链中的顾问顺序。 |
聊天模型
可观察性功能目前仅支持以下AI模型提供商的 ChatModel 个实现:Anthropic、Azure OpenAI、Mistral AI、Ollama、OpenAI、Vertex AI、MiniMax、Moonshot、QianFan、Zhipu AI。 未来版本将支持更多AI模型提供商。 |
|---|
调用 ChatModel 的 gen_ai.client.operation 观察结果是在调用 call 或 stream 方法时记录的。 它们用于测量方法完成所花费的时间,并传播相关的跟踪信息。
The gen_ai.client.token.usage metrics measures number of input and output tokens used by a single model call. |
|---|
| 名称 | 描述 |
|---|---|
gen_ai.operation.name | 执行的操作名称。 |
gen_ai.system | 由客户端仪表化标识的模型提供商。 |
gen_ai.request.model | 请求所针对的模型名称。 |
gen_ai.response.model | 生成响应的模型名称。 |
| 名称 | 描述 |
|---|---|
gen_ai.request.frequency_penalty | 模型请求的频率惩罚设置。 |
gen_ai.request.max_tokens | 模型为一次请求生成的最大标记数。 |
gen_ai.request.presence_penalty | 模型请求的在场惩罚设置。 |
gen_ai.request.stop_sequences | 模型将用于停止生成更多标记的序列列表。 |
gen_ai.request.temperature | 模型请求的温度设置。 |
gen_ai.request.top_k | 模型请求的 top_k 采样设置。 |
gen_ai.request.top_p | 模型请求的 top_p 采样设置。 |
gen_ai.response.finish_reasons | 模型停止生成标记的原因,对应于每个接收到的生成结果。 |
gen_ai.response.id | AI 响应的唯一标识符。 |
gen_ai.usage.input_tokens | 模型输入(提示)中使用的标记数量。 |
gen_ai.usage.output_tokens | 模型输出(完成)中使用的标记数量。 |
gen_ai.usage.total_tokens | 模型交换中使用的总标记数。 |
gen_ai.prompt | 发送给模型的完整提示。可选。 |
gen_ai.completion | 模型返回的完整响应。可选。 |
spring.ai.model.request.tool.names | 请求中提供给模型的工具定义列表。 |
对于用户Tokens的度量,上表列出了观测跟踪中存在的值。 使用由 ChatModel 提供的指标名称 gen_ai.client.token.usage 。 |
|---|
聊天提示与完成数据
聊天提示和完成数据通常较大,并且可能包含敏感信息。 出于这些原因,它们默认不会被导出。
Spring AI 支持记录聊天提示和完成数据,这对于故障排查场景非常有用。当跟踪功能可用时,日志将包含跟踪信息,以便更好地进行关联。
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.chat.observations.log-prompt | 记录提示内容。 true 或 false | false |
spring.ai.chat.observations.log-completion | 记录完成内容。 true 或 false | false |
spring.ai.chat.observations.include-error-logging | 在观测中包含错误日志。 true 或 false | false |
| 如果您启用聊天提示和完成数据的日志记录,可能会存在泄露敏感或私人信息的风险。请务必谨慎! |
|---|
工具调用
在聊天模型交互的上下文中执行工具调用时,会记录 spring.ai.tool 个观测值。这些观测值用于衡量工具调用完成所花费的时间,并传播相关的追踪信息。
| 名称 | 描述 |
|---|---|
gen_ai.operation.name | 执行的操作名称。它始终为 framework 。 |
gen_ai.system | 负责该操作的提供者。它始终为 spring_ai 。 |
spring.ai.kind | Spring AI 执行的操作类型。始终为 tool_call 。 |
spring.ai.tool.definition.name | 工具的名称。 |
| 名称 | 描述 |
|---|---|
spring.ai.tool.definition.description | 该工具的描述。 |
spring.ai.tool.definition.schema | 调用该工具所使用的参数模式。 |
spring.ai.tool.call.arguments | 工具调用的输入参数。(仅在启用时) |
spring.ai.tool.call.result | 用于调用该工具的参数架构。(仅在启用时) |
工具调用参数和结果数据
默认情况下,工具调用的输入参数和结果不会被导出,因为它们可能具有敏感性。
Spring AI 支持将工具调用参数和结果数据导出为 Span 属性。
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.tools.observations.include-content | 在观察中包含工具调用内容。 true 或 false | false |
| 如果您在观测中启用工具调用参数和结果的包含,可能会存在泄露敏感或隐私信息的风险。请务必谨慎! |
|---|
嵌入模型
可观察性功能目前仅支持以下 AI 模型提供商的 EmbeddingModel 个实现:Azure OpenAI、Mistral AI、Ollama 和 OpenAI。 未来版本将支持更多 AI 模型提供商。 |
|---|
gen_ai.client.operation 个观测记录在嵌入模型方法调用上。 它们用于测量方法完成所花费的时间,并传播相关的跟踪信息。
The gen_ai.client.token.usage metrics measures number of input and output tokens used by a single model call. |
|---|
| 名称 | 描述 |
|---|---|
gen_ai.operation.name | 执行的操作名称。 |
gen_ai.system | 由客户端仪表化标识的模型提供商。 |
gen_ai.request.model | 请求所针对的模型名称。 |
gen_ai.response.model | 生成响应的模型名称。 |
| 名称 | 描述 |
|---|---|
gen_ai.request.embedding.dimensions | 生成的输出嵌入所具有的维度数量。 |
gen_ai.usage.input_tokens | 模型输入中使用的标记数量。 |
gen_ai.usage.total_tokens | 模型交换中使用的总标记数。 |
对于用户Tokens的度量,上表列出了观测跟踪中存在的值。 使用由 EmbeddingModel 提供的指标名称 gen_ai.client.token.usage 。 |
|---|
图像模型
可观察性功能目前仅支持来自以下AI模型提供商的 ImageModel 个实现:OpenAI。 未来版本将支持更多AI模型提供商。 |
|---|
gen_ai.client.operation 个观测记录在图像模型方法调用上。 它们用于测量方法完成所花费的时间,并传播相关的跟踪信息。
The gen_ai.client.token.usage metrics measures number of input and output tokens used by a single model call. |
|---|
| 名称 | 描述 |
|---|---|
gen_ai.operation.name | 执行的操作名称。 |
gen_ai.system | 由客户端仪表化标识的模型提供商。 |
gen_ai.request.model | 请求所针对的模型名称。 |
| 名称 | 描述 |
|---|---|
gen_ai.request.image.response_format | 生成的图像返回的格式。 |
gen_ai.request.image.size | 要生成的图像大小。 |
gen_ai.request.image.style | 生成图像的样式。 |
gen_ai.response.id | AI 响应的唯一标识符。 |
gen_ai.response.model | 生成响应的模型名称。 |
gen_ai.usage.input_tokens | 模型输入(提示)中使用的标记数量。 |
gen_ai.usage.output_tokens | 模型输出(生成)中使用的标记数量。 |
gen_ai.usage.total_tokens | 模型交换中使用的总标记数。 |
gen_ai.prompt | 发送给模型的完整提示。可选。 |
对于用户Tokens的度量,上表列出了观测跟踪中存在的值。 使用由 ImageModel 提供的指标名称 gen_ai.client.token.usage 。 |
|---|
图像提示数据
图像提示数据通常较大,并且可能包含敏感信息。 出于这些原因,它不会默认导出。
Spring AI 支持记录图像提示数据,这对于故障排查场景非常有用。当跟踪功能可用时,日志将包含跟踪信息,以便更好地进行关联。
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.image.observations.log-prompt | 记录图像提示内容。 true 或 false | false |
| 如果您启用图像提示数据的日志记录,可能会存在泄露敏感或隐私信息的风险。请务必谨慎! |
|---|
向量商店
Spring AI 中的所有向量存储实现都已进行插桩,以通过 Micrometer 提供指标和分布式追踪数据。
观察结果 db.vector.client.operation 是在与向量存储交互时记录的。 它们用于测量在 query 、 add 和 remove 操作上花费的时间,并传播相关的追踪信息。
| 名称 | 描述 |
|---|---|
db.operation.name | 正在执行的操作或命令的名称。取值为 add 、 delete 或 query 。 |
db.system | 客户端仪表化所识别的数据库管理系统(DBMS)产品。取值为 pg_vector 、 azure 、 cassandra 、 chroma 、 elasticsearch 、 milvus 、 neo4j 、 opensearch 、 qdrant 、 redis 、 typesense 、 weaviate 、 pinecone 、 oracle 、 mongodb 、 gemfire 、 hana 、 simple 中的一个。 |
spring.ai.kind | Spring AI 中的框架 API 类型: vector_store 。 |
| 名称 | 描述 |
|---|---|
db.collection.name | 数据库中的集合(表、容器)的名称。 |
db.namespace | 数据库的名称,需在服务器地址和端口范围内完整指定。 |
db.record.id | 如果存在,则为记录标识符。 |
db.search.similarity_metric | 用于相似性搜索的指标。 |
db.vector.dimension_count | 向量的维度。 |
db.vector.field_name | 向量中的名称字段(例如,字段名称)。 |
db.vector.query.content | 正在执行的搜索查询内容。 |
db.vector.query.filter | 搜索查询中使用的元数据过滤器。 |
db.vector.query.response.documents | 从相似性搜索查询中返回的文档。可选。 |
db.vector.query.similarity_threshold | 相似度阈值,用于接受所有搜索得分。阈值为 0.0 表示接受任何相似度,或禁用相似度阈值过滤。阈值为 1.0 表示需要完全匹配。 |
db.vector.query.top_k | 查询返回的前 k 个最相似的向量。 |
响应数据
向量搜索的响应数据通常较大,并且可能包含敏感信息。 出于这些原因,它默认不会被导出。
Spring AI 支持记录向量搜索响应数据,这对于故障排查场景非常有用。当跟踪功能可用时,日志将包含跟踪信息,以便更好地进行关联。
| 属性 | 描述 | 默认 |
|---|---|---|
spring.ai.vectorstore.observations.log-query-response | 记录向量存储查询响应内容。 true 或 false | false |
| 如果启用了向量搜索响应数据的日志记录,可能会有泄露敏感或私人信息的风险。请务必小心! |
|---|
更多指标参考
本节记录了Spring AI组件在Prometheus中显示的指标。
指标命名约定
Spring AI 使用 Micrometer。基础指标名称使用点号(例如, gen_ai.client.operation ),Prometheus 会将其导出为带下划线和标准后缀的形式:
- 计时器 →
<base>_seconds_count,<base>_seconds_sum,<base>_seconds_max,以及(在支持时)<base>_active_count - 计数器 →
<base>_total(单调递增)
以下展示了基础指标名称如何扩展为 Prometheus 时间序列。
| 基础指标名称 | 导出的时间序列 |
|---|---|
gen_ai.client.operation | gen_ai_client_operation_seconds_count gen_ai_client_operation_seconds_sum gen_ai_client_operation_seconds_max gen_ai_client_operation_active_count |
db.vector.client.operation | db_vector_client_operation_seconds_count db_vector_client_operation_seconds_sum db_vector_client_operation_seconds_max db_vector_client_operation_active_count |
参考资料
- OpenTelemetry — 生成式AI的语义约定(概述)
- Micrometer — 命名仪表
聊天客户端指标
| 指标名称 | 类型 | 单元 | 描述 |
|---|---|---|---|
gen_ai_chat_client_operation_seconds_sum | 定时器 | 秒 | ChatClient 操作(调用/流)所花费的总时间 |
gen_ai_chat_client_operation_seconds_count | 计数器 | 计数 | 已完成的 ChatClient 操作数量 |
gen_ai_chat_client_operation_seconds_max | 仪表盘 | 秒 | ChatClient 操作的最大观测持续时间 |
gen_ai_chat_client_operation_active_count | 仪表盘 | 计数 | 当前正在进行的 ChatClient 操作数量 |
进行中与已完成: ***active_count*** 显示正在进行的调用; _seconds 系列仅反映已完成的调用。
聊天模型指标(模型提供商执行)
| 指标名称 | 类型 | 单元 | 描述 |
|---|---|---|---|
gen_ai_client_operation_seconds_sum | 定时器 | 秒 | 执行聊天模型操作的总时间 |
gen_ai_client_operation_seconds_count | 计数器 | 计数 | 已完成的聊天模型操作数量 |
gen_ai_client_operation_seconds_max | 仪表盘 | 秒 | 聊天模型操作的最大观测持续时间 |
gen_ai_client_operation_active_count | 仪表盘 | 计数 | 当前正在进行的聊天模型操作数量 |
Tokens使用情况
| 指标名称 | 类型 | 单元 | 描述 |
|---|---|---|---|
gen_ai_client_token_usage_total | 计数器 | Tokens | 消耗的总Tokens数,按Tokens类型标记 |
标签
| 标签 | 含义 |
|---|---|
gen_ai_token_type=input | 发送给模型的提示词元 |
gen_ai_token_type=output | 模型返回的完成Tokens |
gen_ai_token_type=total | 输入 + 输出 |
向量存储指标
| 指标名称 | 类型 | 单元 | 描述 |
|---|---|---|---|
db_vector_client_operation_seconds_sum | 定时器 | 秒 | 向量存储操作(添加/删除/查询)所花费的总时间 |
db_vector_client_operation_seconds_count | 计数器 | 计数 | 已完成的向量存储操作数量 |
db_vector_client_operation_seconds_max | 仪表盘 | 秒 | 向量存储操作的最大观测持续时间 |
db_vector_client_operation_active_count | 仪表盘 | 计数 | 当前正在进行的向量存储操作数量 |
标签
| 标签 | 含义 |
|---|---|
db_operation_name | 操作类型 (add, delete, query) |
db_system | 向量数据库/提供商 (redis, chroma, pgvector, …) |
spring_ai_kind | vector_store |
理解进行中与已完成
- 活动的 (
*_active_count) — 正在进行的操作(并发/负载)的瞬时度量。 - 已完成 (
*_seconds_sum|count|max) — 已完成操作的统计信息: _seconds_sum / _seconds_count→ 平均延迟_seconds_max→ 自上次抓取以来的最高水位标记(取决于注册表行为)
开发时服务
Docker Compose
Spring AI提供了一个通过Docker Compose运行的模型服务或向量存储的自动配置Spring Boot连接的功能。要启用它,请在您的项目Maven pom.xml 文件中添加以下依赖项:
xml
<dependency>
<groupId>org.springframework.ai</groupId>
<artifactId>spring-ai-spring-boot-docker-compose</artifactId>
</dependency>或者添加到您的Gradle 构建脚本文件 中。
groovy
dependencies {
implementation 'org.springframework.ai:spring-ai-spring-boot-docker-compose'
}| 参考以下 依赖管理 部分,添加Spring AI BOM到你的构建文件中。 |
|---|
服务连接
以下提供了一个模块中的服务连接工厂: spring-ai-spring-boot-docker-compose 模块。
| 连接详情 | 匹配于 |
|---|---|
AwsOpenSearchConnectionDetails | 容器名为 localstack/localstack |
ChromaConnectionDetails | 容器名为0,1 |
MongoConnectionDetails | 容器名为 mongodb/mongodb-atlas-local |
OllamaConnectionDetails | 容器名为 ollama/ollama |
OpenSearchConnectionDetails | 容器名为 opensearchproject/opensearch |
QdrantConnectionDetails | 容器名为 qdrant/qdrant |
TypesenseConnectionDetails | 容器名为 typesense/typesense |
WeaviateConnectionDetails | 容器名为0,1 |
McpSseClientConnectionDetails | 容器名为 docker/mcp-gateway |
更多服务连接由Spring Boot组件 spring-boot-docker-compose 提供。参考 文档以获取完整的列表。
Testing
Testcontainers
Spring AI 提供 Spring Boot 的自动配置功能,用于连接到运行于 Testcontainers 上的模型服务或向量存储。要启用该功能,请在您的项目 Maven 的 pom.xml 文件中添加以下依赖项:
xml
<dependency>
<groupId>org.springframework.ai</groupId>
<artifactId>spring-ai-spring-boot-testcontainers</artifactId>
</dependency>或者添加到您的Gradle 构建脚本文件 中。
groovy
dependencies {
implementation 'org.springframework.ai:spring-ai-spring-boot-testcontainers'
}| 参考以下 依赖管理 部分,添加Spring AI BOM到你的构建文件中。 |
|---|
服务连接
以下提供了一个模块中的服务连接工厂: spring-ai-spring-boot-testcontainers 模块。
| 连接详情 | 匹配于 |
|---|---|
AwsOpenSearchConnectionDetails | 容器的类型 0 |
ChromaConnectionDetails | 容器的类型 0 |
McpSseClientConnectionDetails | 容器的类型 0 |
MilvusServiceClientConnectionDetails | 容器的类型 0 |
MongoConnectionDetails | 容器的类型 0 |
OllamaConnectionDetails | 容器的类型 0 |
OpenSearchConnectionDetails | 容器的类型 0 |
QdrantConnectionDetails | 容器的类型 0 |
TypesenseConnectionDetails | 容器的类型 0 |
WeaviateConnectionDetails | 容器的类型 0 |
更多服务连接由Spring Boot模块提供。参考 Testcontainers Service Connections 文档页面获取完整列表。